

Claude Opus 5.5 使用指南:16 步完整走一遍
Claude Opus 5.5 是 Anthropic 在 2026 年 9 月 22 日发布的旗舰模型,定位就是长时间运行的智能体编程和知识工作。它比 Opus 5 每 token 便宜 20%,完成同样任务消耗的 token 更少,Pro、Max、Team 订阅的额度还同步上调了 25%。这篇攻略跟着 Anthropic 官方的日常使用演示一步步走,所有数字都与官方公告和文档交叉核对过:从选模型、调 effort,到配子代理、改项目提示词。
来源与致谢
本教程的截图来自 Claude 的公开演示视频。每个步骤都链接到视频中的对应时间点,方便你对照学习。
Claude ↗先搞清楚你为什么买单
- 1
先读一遍官方公告
动手之前先把 Anthropic 的公告过一遍。官方对 Opus 5.5 的定位是 Claude 5.5 家族的第一个模型:多数工作上达到 Claude Fable 5.1 的水准,运行成本却比 Opus 5 低 40%。记住这两个数字,接下来你在自己项目里实测时就有了一把对照的尺子。
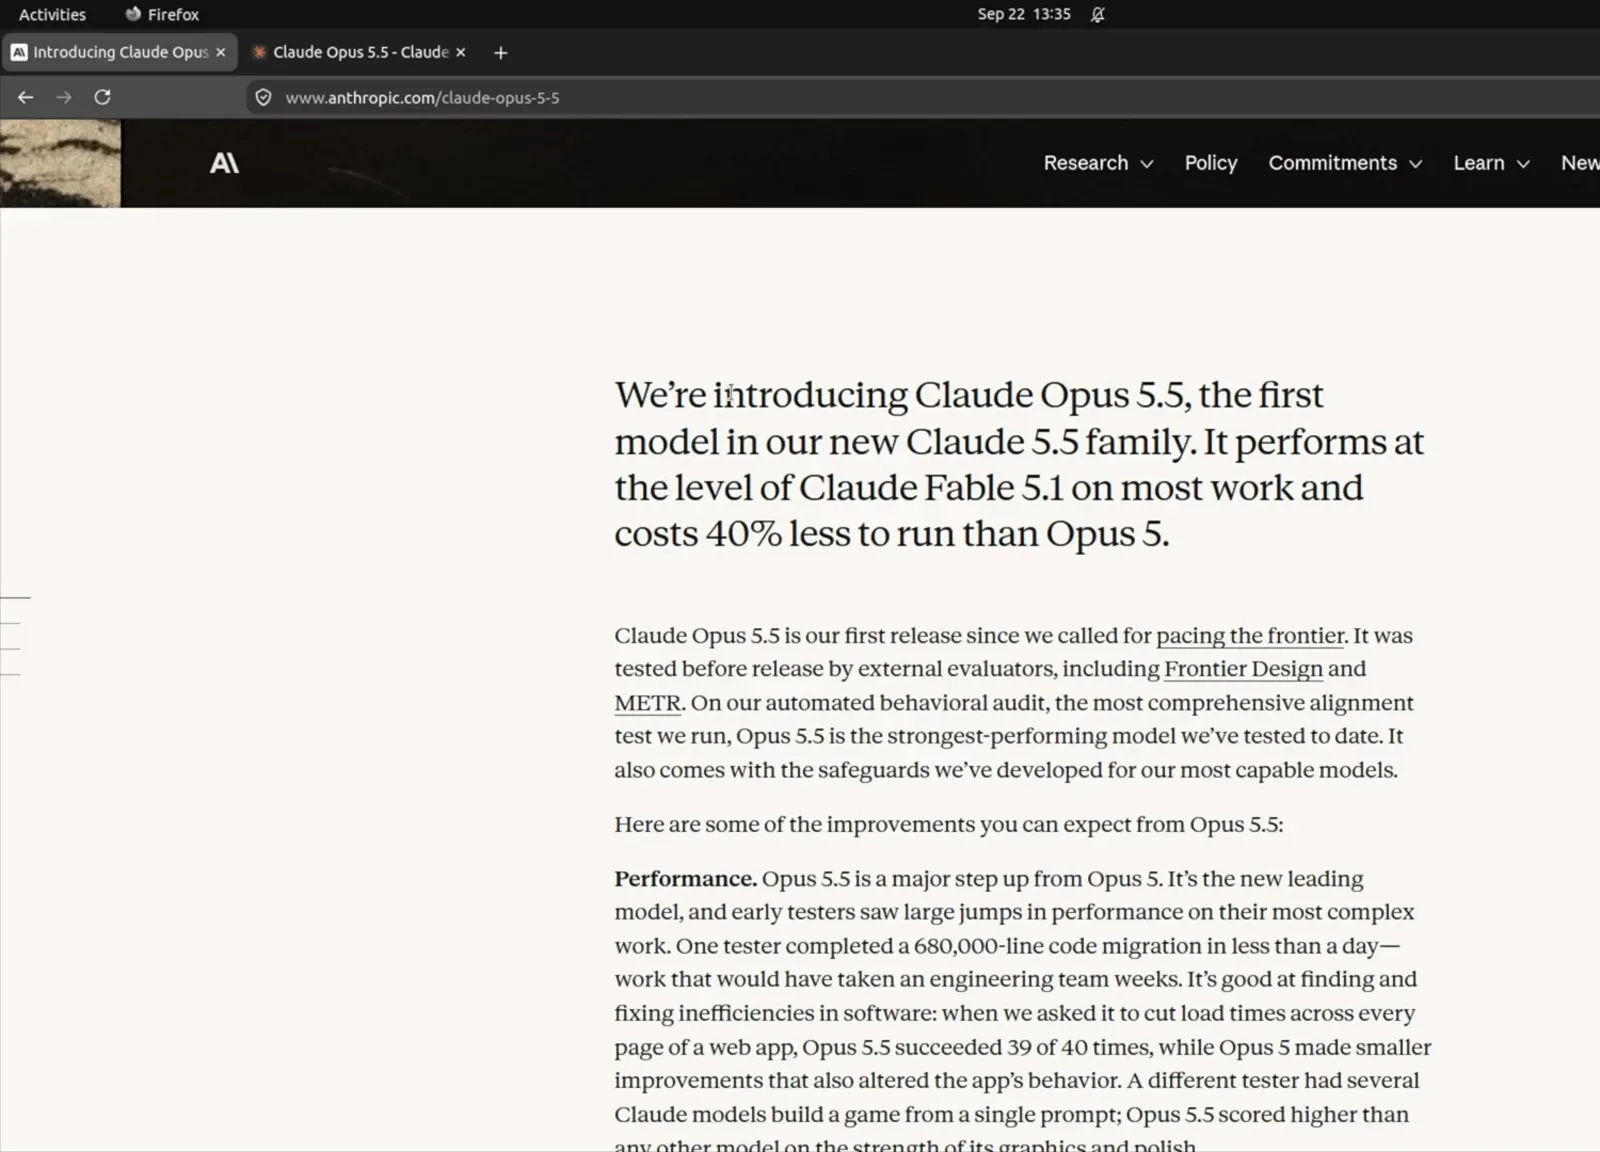
Anthropic 在 2026 年 9 月 22 日发布 Opus 5.5,Claude 5.5 家族的第一款模型。视频 0:46 处 - 2
提问之前先看清价格
Opus 5.5 的 API 定价是每百万 token 输入 4 美元、输出 20 美元,比 Opus 5 的 5 美元和 25 美元各降 20%。缓存读取降到每百万 token 0.20 美元;还有一档快速模式,输入 8 美元、输出 40 美元,换最多 2.5 倍的速度。直接调 API 按量计费,Pro、Max、Team 订阅用户则在套餐额度内直接使用。
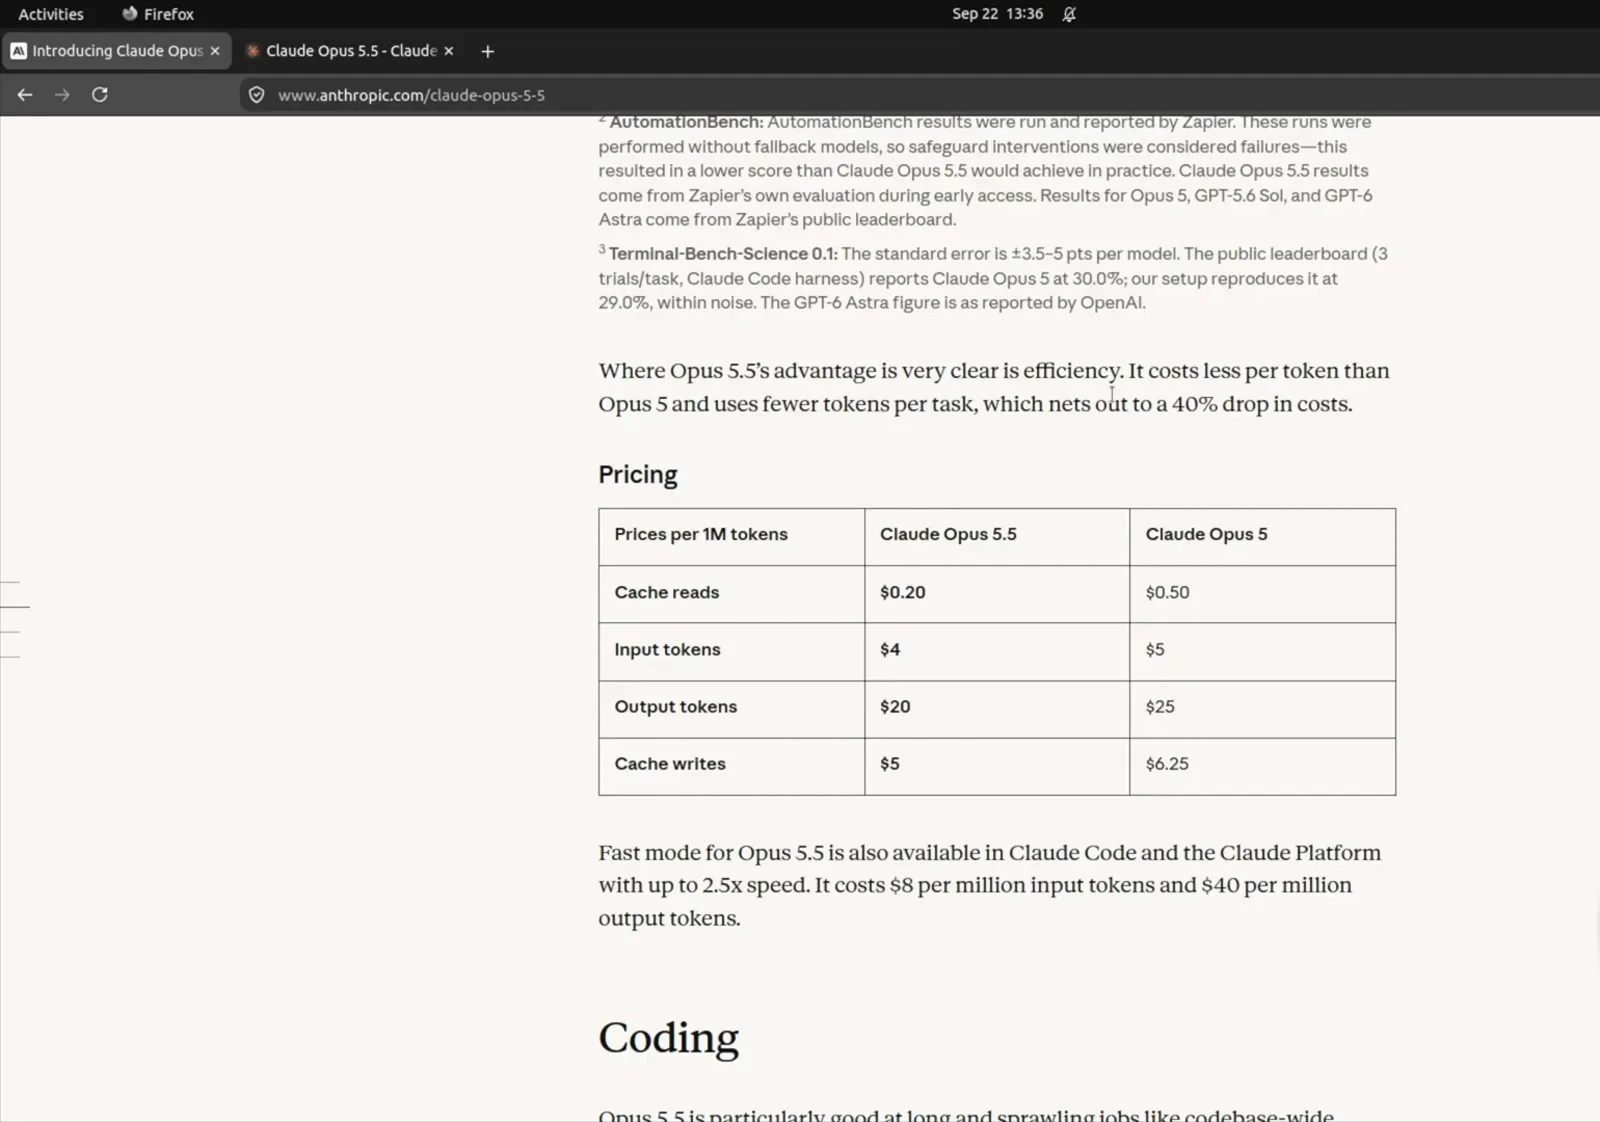
输入从每百万 token 5 美元降到 4 美元,输出从 25 美元降到 20 美元,两边都是 20% 的降幅。视频 1:58 处 - 3
记住 100 万 token 的上下文窗口
模型卡片上写着:100 万 token 上下文窗口、12.8 万最大输出、自适应思考常开。要走 API 就复制模型 ID claude-opus-5-5,在 Claude 应用里直接按名字选 Opus 5.5 即可。正是这个上下文预算,让长时间智能体会话不用反复总结也能跑下去。
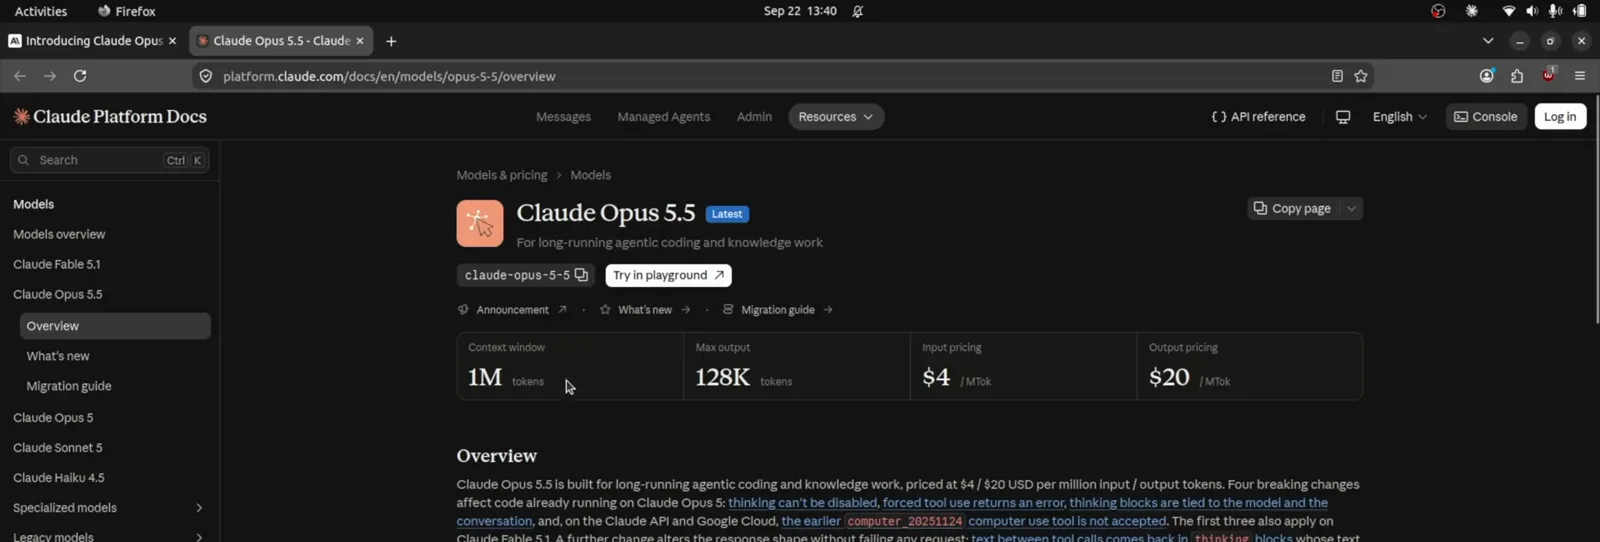
文档给出三个关键数:100 万输入 token、12.8 万输出 token、每百万 token 输入 4 美元输出 20 美元。视频 3:42 处
在 Claude 里选模型、定思考强度
- 4
把 Opus 5.5 和 Opus 5 放在一起跑
在官方演示里,同一个退款舍入缺陷同时发给左右两栏:左边 Opus 5,右边 Opus 5.5,都是中等强度。两边都会读退款代码、找到折扣拆分的位置、跑测试,但 5.5 不到一分钟就交活,整体快了约 30%。换主力模型之前,照这个样子拿自己的真实任务对比一轮。
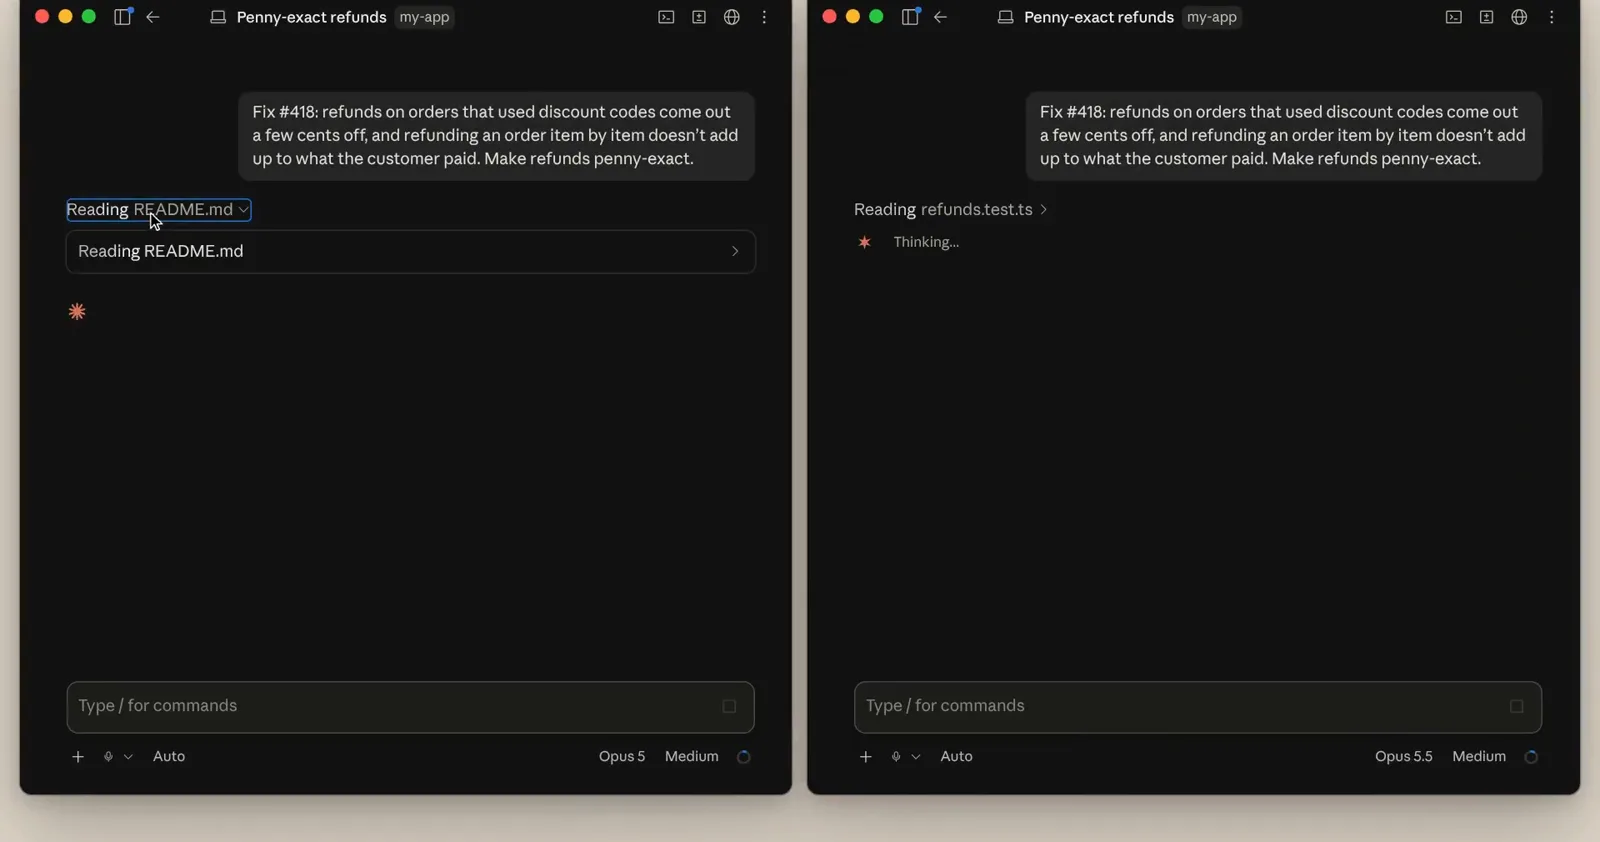
同一个项目、同一条提示词:左边 Opus 5,右边 Opus 5.5。视频 0:37 处 - 5
起步阶段保持 Medium 思考强度
Opus 5.5 默认就是中等强度,effort 本质上是模型动手前思考的深度。选择器上的提示写得很直白:更高的强度意味着更彻底的回答,但耗时更久、额度消耗更快。日常任务中等强度足够,官方演示里普通修复全程也没离开这一档。
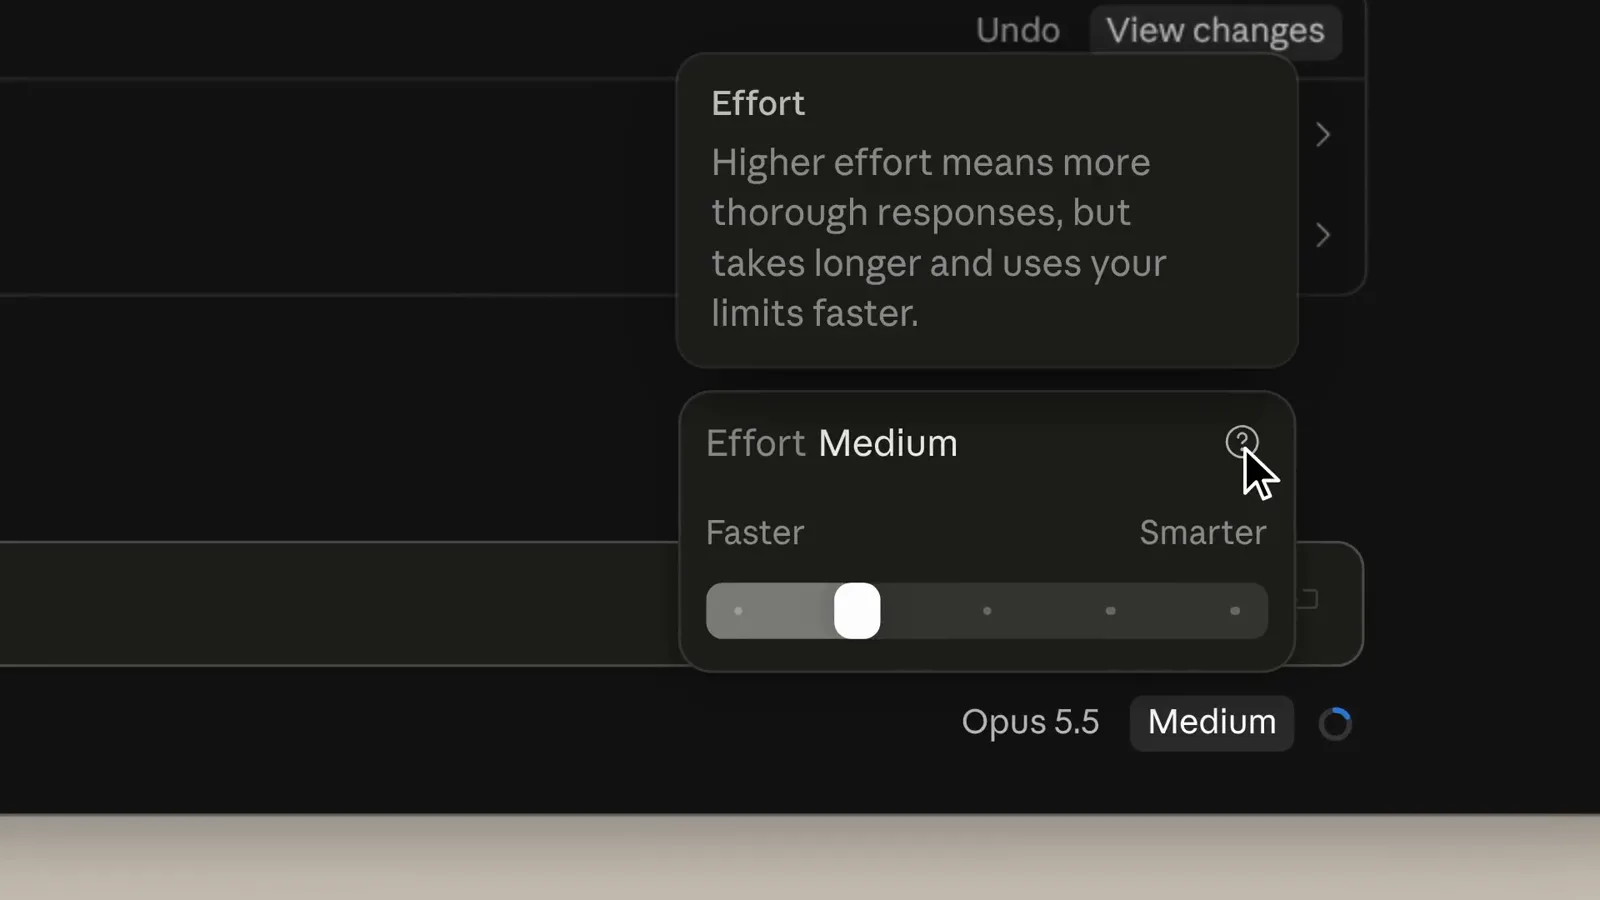
悬停 effort 标签就能看到官方写的取舍:更彻底,但更慢、更费额度。视频 1:32 处 - 6
盯住 5 小时额度:它掉得更慢了
同一个修复跑完,Opus 5.5 只用了 5 小时 Max 额度的约 4%,Opus 5 用了 6%;上下文窗口这边是 31.4k token,Opus 5 那边是 44k。因为 5.5 完成任务消耗的 token 更少,Anthropic 估计单任务成本能省下四成左右。你的具体数字会不一样,但重复跑几次就能稳定看到这个差距。
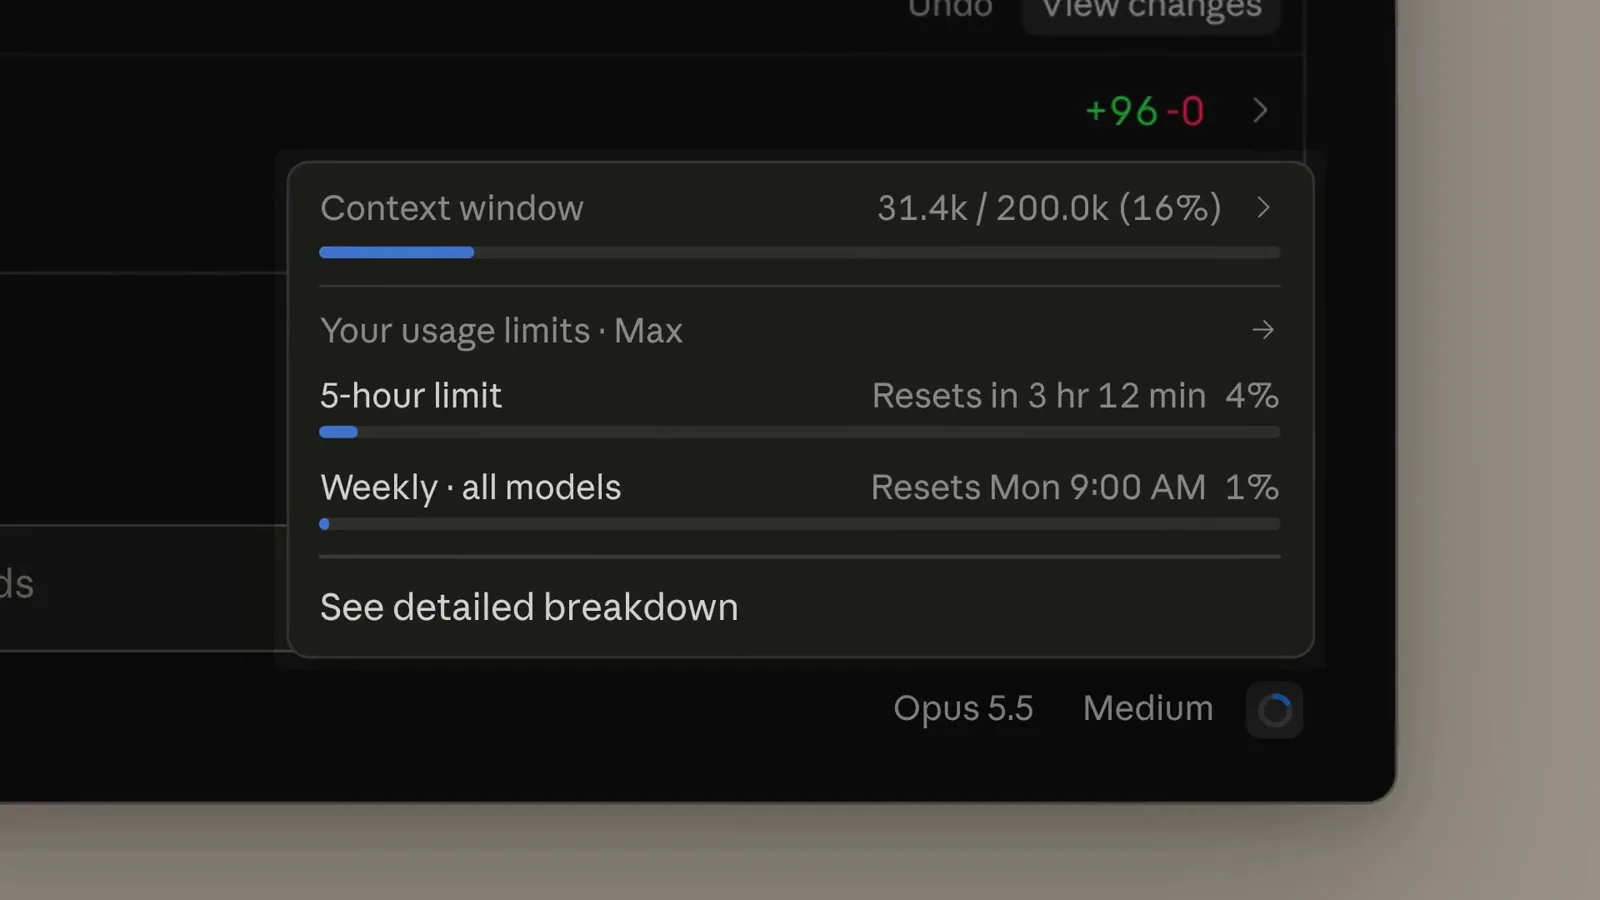
同一个任务,Opus 5.5 花掉 5 小时额度的 4%,Opus 5 花掉 6%。视频 1:14 处 - 7
一周后回看统计数据
统计总览会把真实用量汇总起来:总 token 数、单任务平均 token、平均耗时,还有一张活动热力图,这个 Max 账号的常用模型显示为 Opus 5.5。用满一周后回来看一眼,确认中等强度确实把用量控制在预期内。如果某类任务的消耗持续偏高,那就是该为它单独调高强度值的信号。
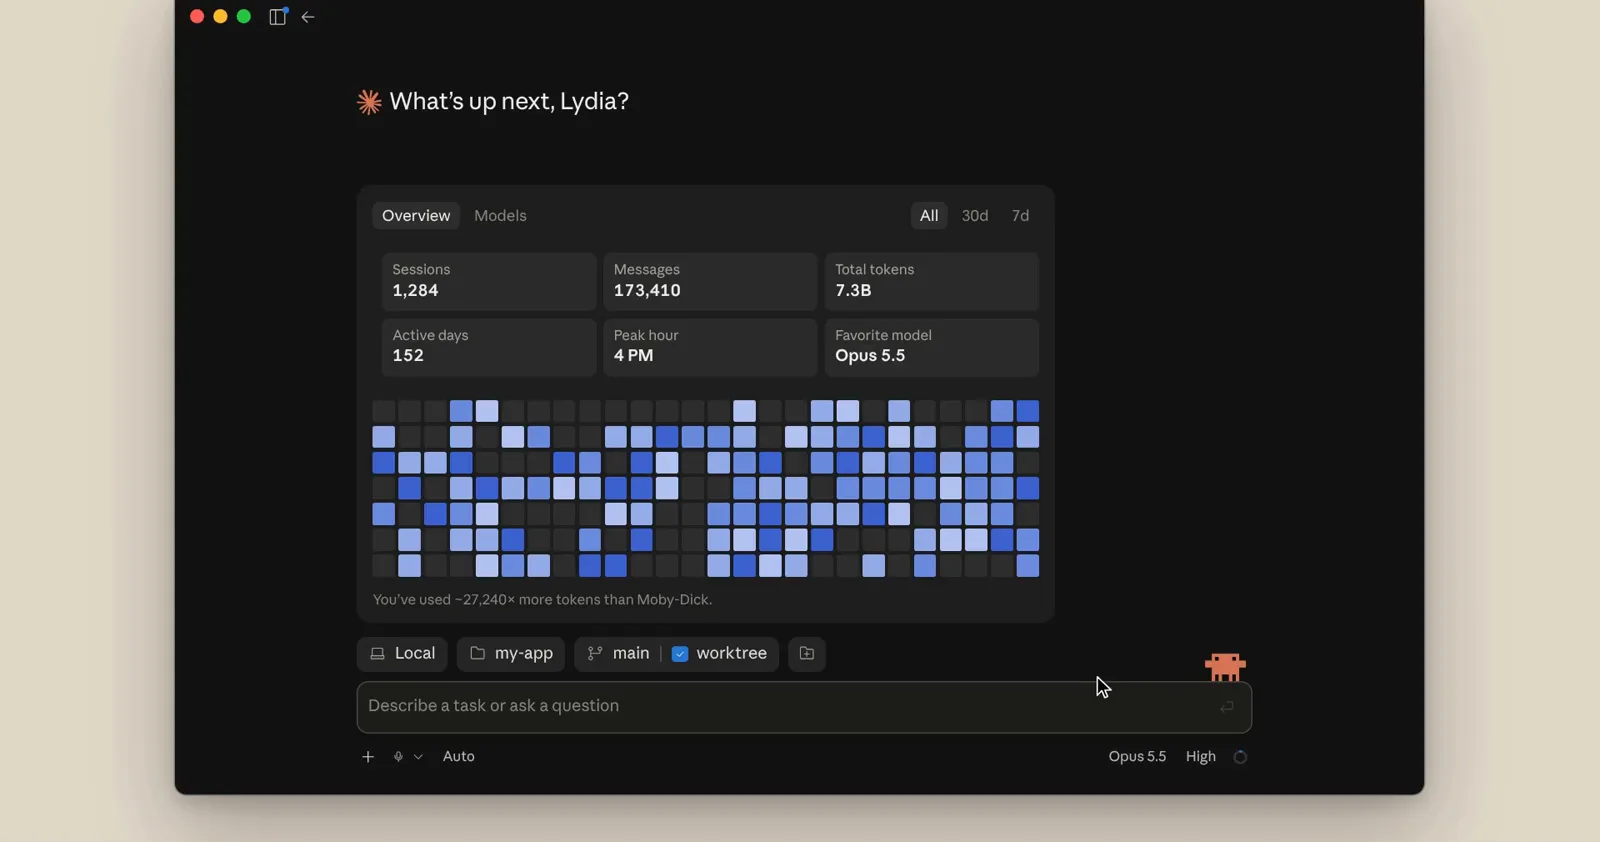
平均耗时、平均消耗加一张任务热力图,省没省钱这里见分晓。视频 2:32 处
在 Claude Code 里跑第一个智能体修复
- 8
喂给它一个可验证的具体缺陷
演示用的提示词就是一份好工单:修复 418 号问题——打折订单的退款金额会差几毛钱、逐项退款加起来对不上账,要求做到分毫不差。三句话说清了症状、约束和验收标准。Opus 5.5 最吃这种提示词结构:一个具体的缺陷,加一条可度量的完成定义。
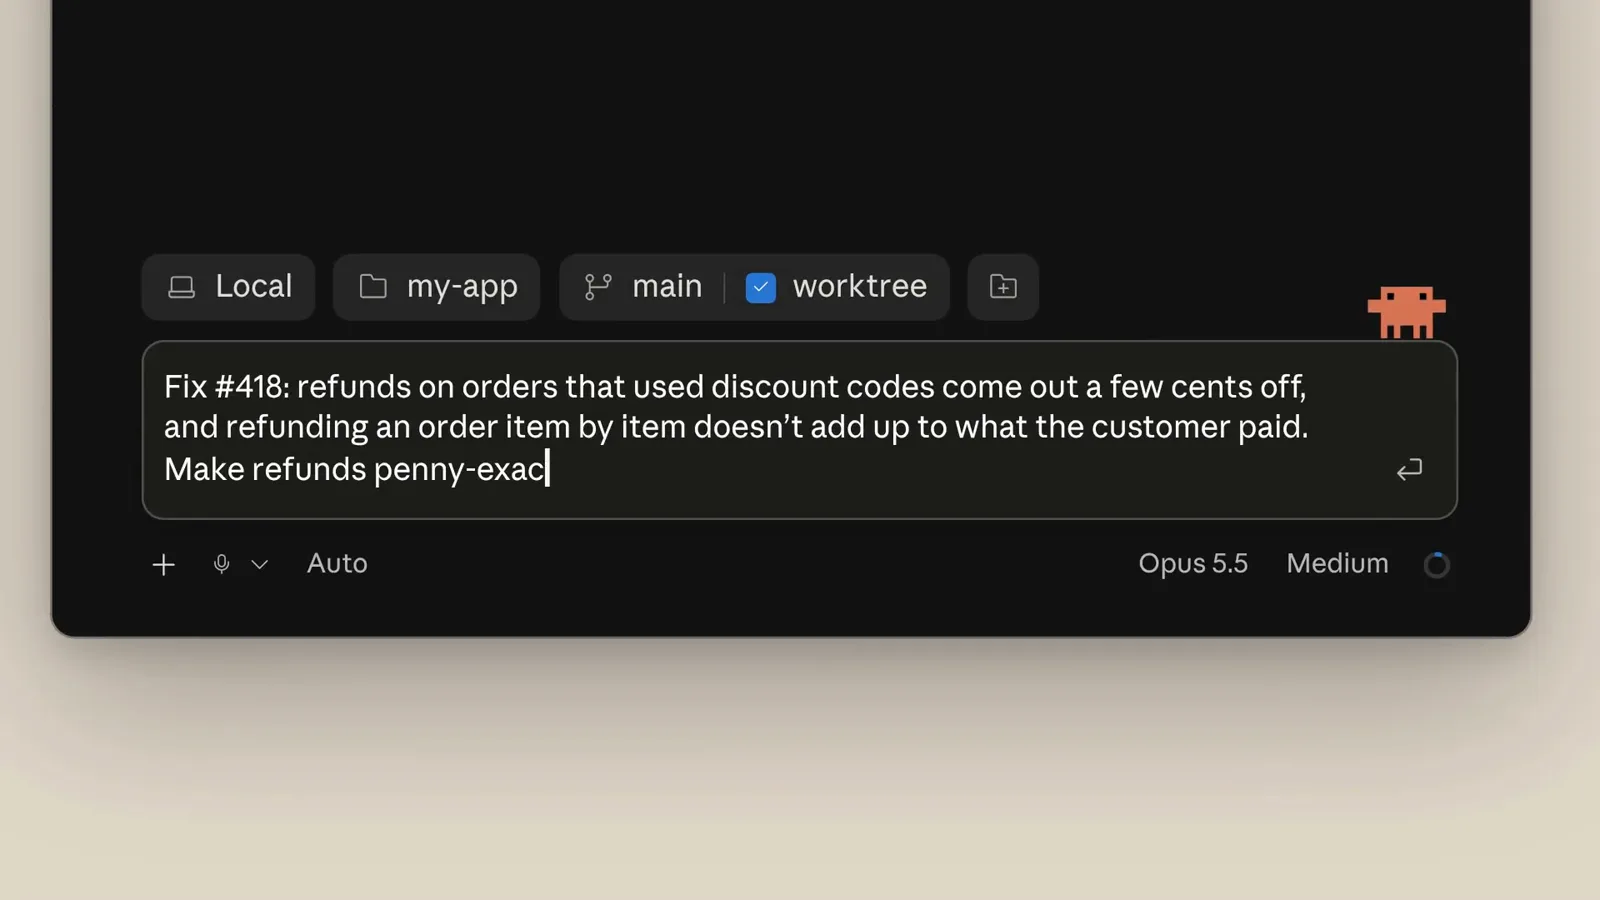
三句话:418 号问题、症状是什么、验收标准是分毫不差。视频 0:32 处 - 9
小范围修改交给中等强度
像「把订单处理器里的 customerRef 改名为 accountRef」这种范围明确的请求,中等强度会搜索代码、改 handlers.ts、跑 API 测试,然后汇报全部 14 项测试通过,外加一段简短的改动说明。这就是日常主力用法:范围划清楚,强度用中等,让它自己跑。看完 diff、保住绿灯,继续下一件事。
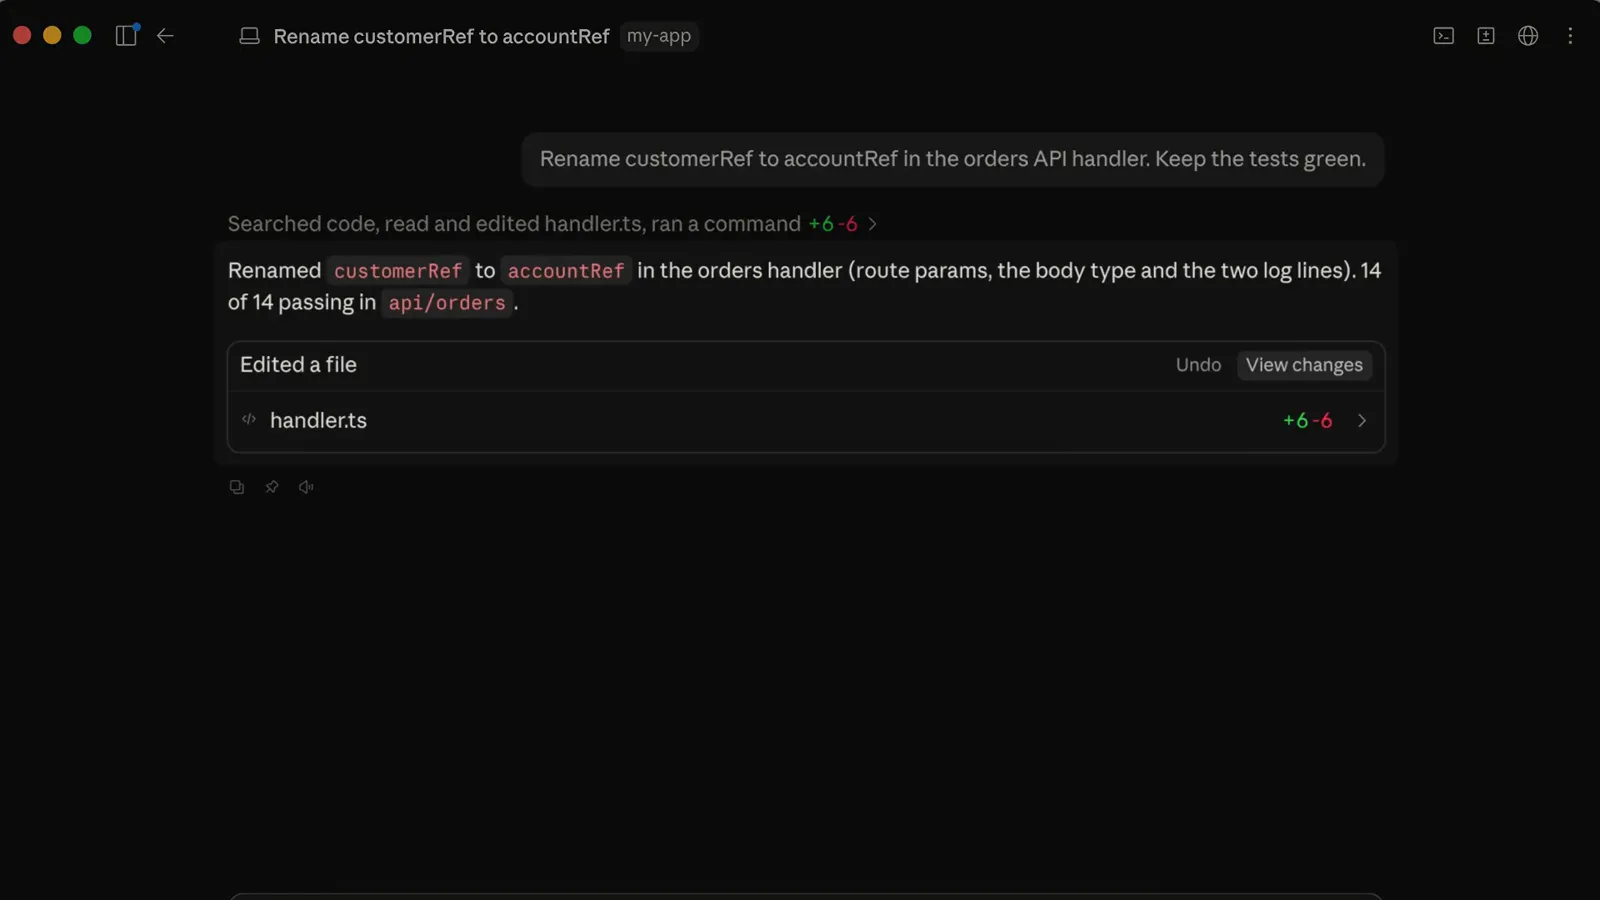
中等强度下的范围化重命名:只改一个文件,测试全绿,报告简短。视频 1:55 处 - 10
知道中等强度会漏掉什么
中等强度改完处理器里的字段就停手了,但移动端发送同一个值时用的是带下划线的 customer_ref,而且要经过 order_serializer.ts,搜索根本匹配不到那个文件。修复本身没错,只是不完整。把单轮结果理解为你字面点名范围之内的修改,一旦改动会波及多个边界,就升级到高强度。
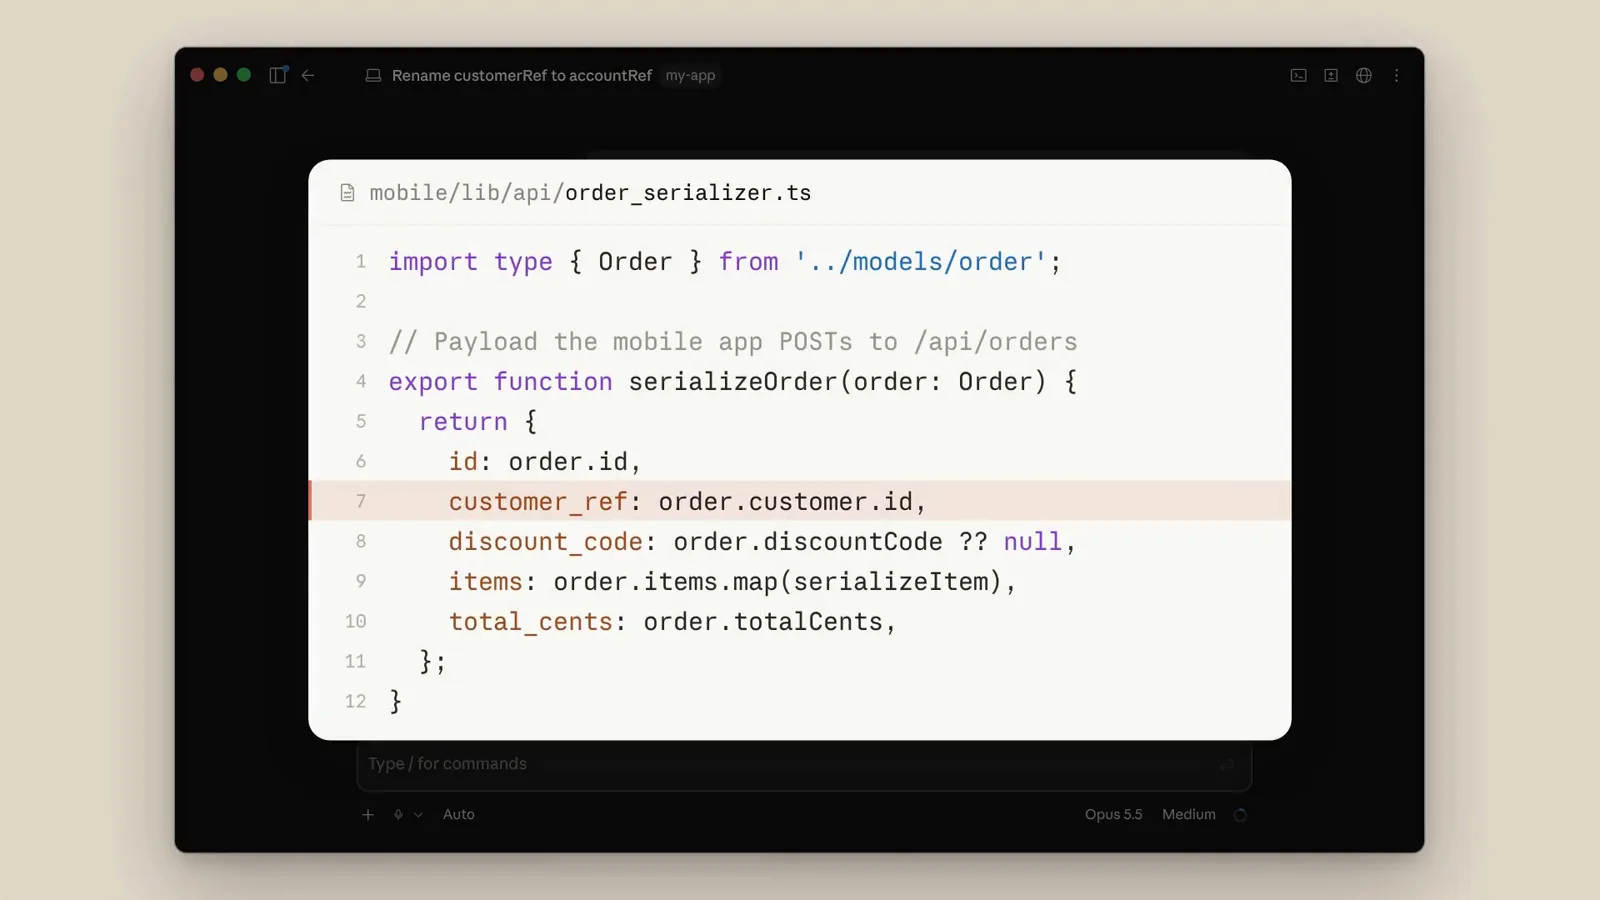
customer_ref 藏在移动端序列化器里,中等强度那轮重命名完全没碰到这个文件。视频 2:00 处 - 11
跨文件改动切到高强度
当修复要横跨多个文件时,切到高强度并把话说全:把还在使用 customerRef 的地方全部改成 accountRef,包括发给 API 的那条链路。高强度下模型会顺着 payload 找到移动端客户端,把序列化器和 schema 里的字段一起改掉,还补了一个回归测试。大改动落地之后,记得切回中等强度。
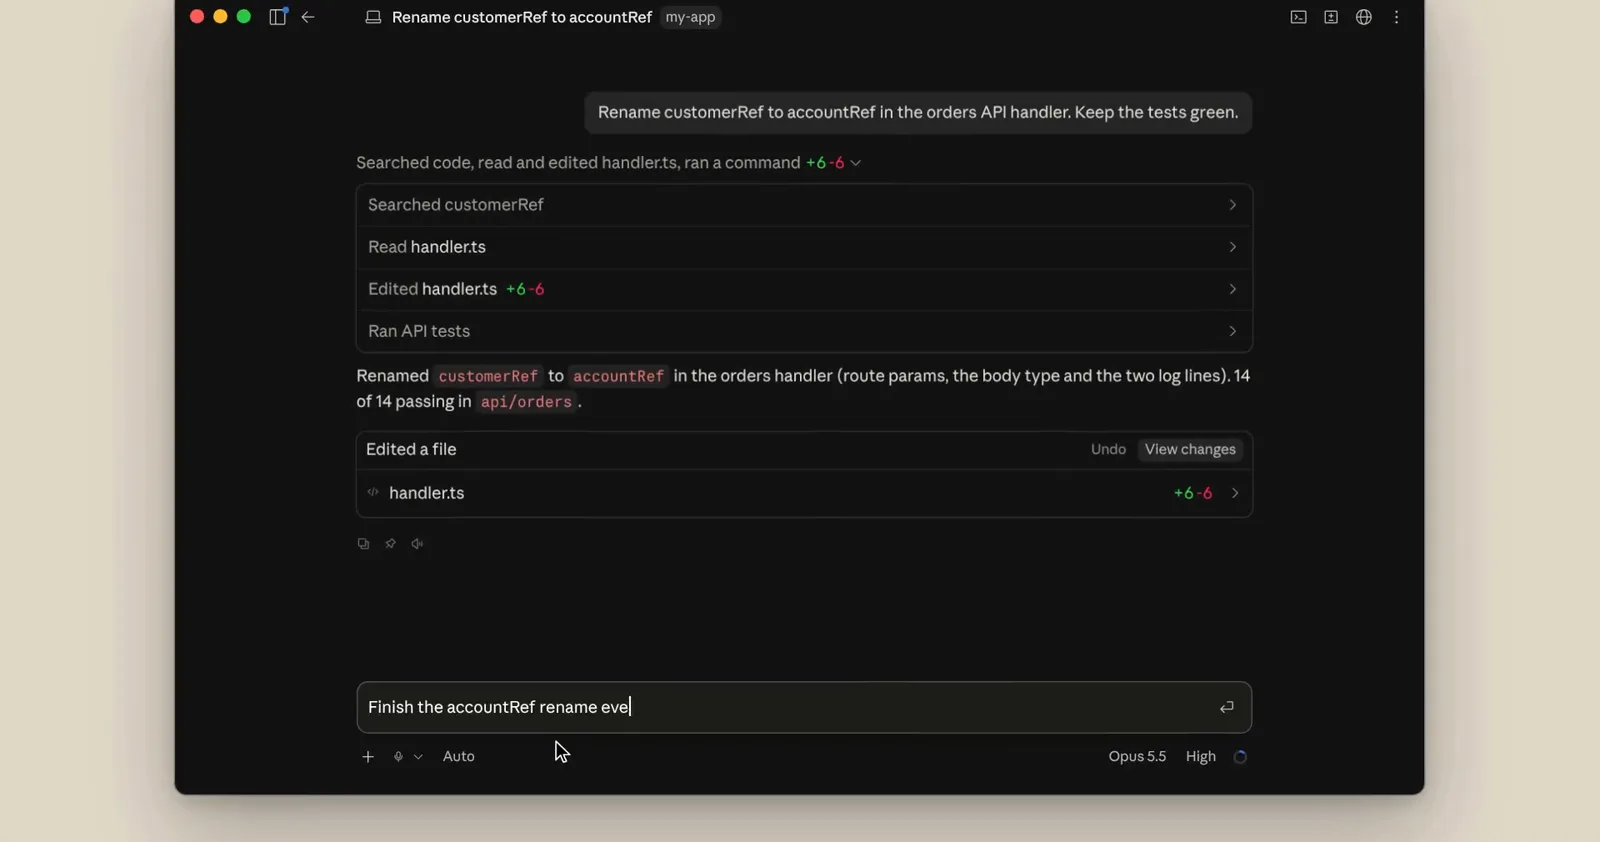
高强度会追着 customer_ref 进移动端客户端和序列化器,跑完这轮再回到中等强度。视频 2:18 处
调提示词、配子代理、认清边界
- 12
为 5.5 审一遍项目提示词
就算你只用 Claude Code、从不直接调 API,也可以跑 /claude-api prompt-audit 命令。它会读你的 CLAUDE.md 和技能文件,把那些按老模型习惯写出来的指令改写成适配 Opus 5.5 的版本。演示里这条命令一轮就同时调整了 CLAUDE.md 和一个 SKILL.md。
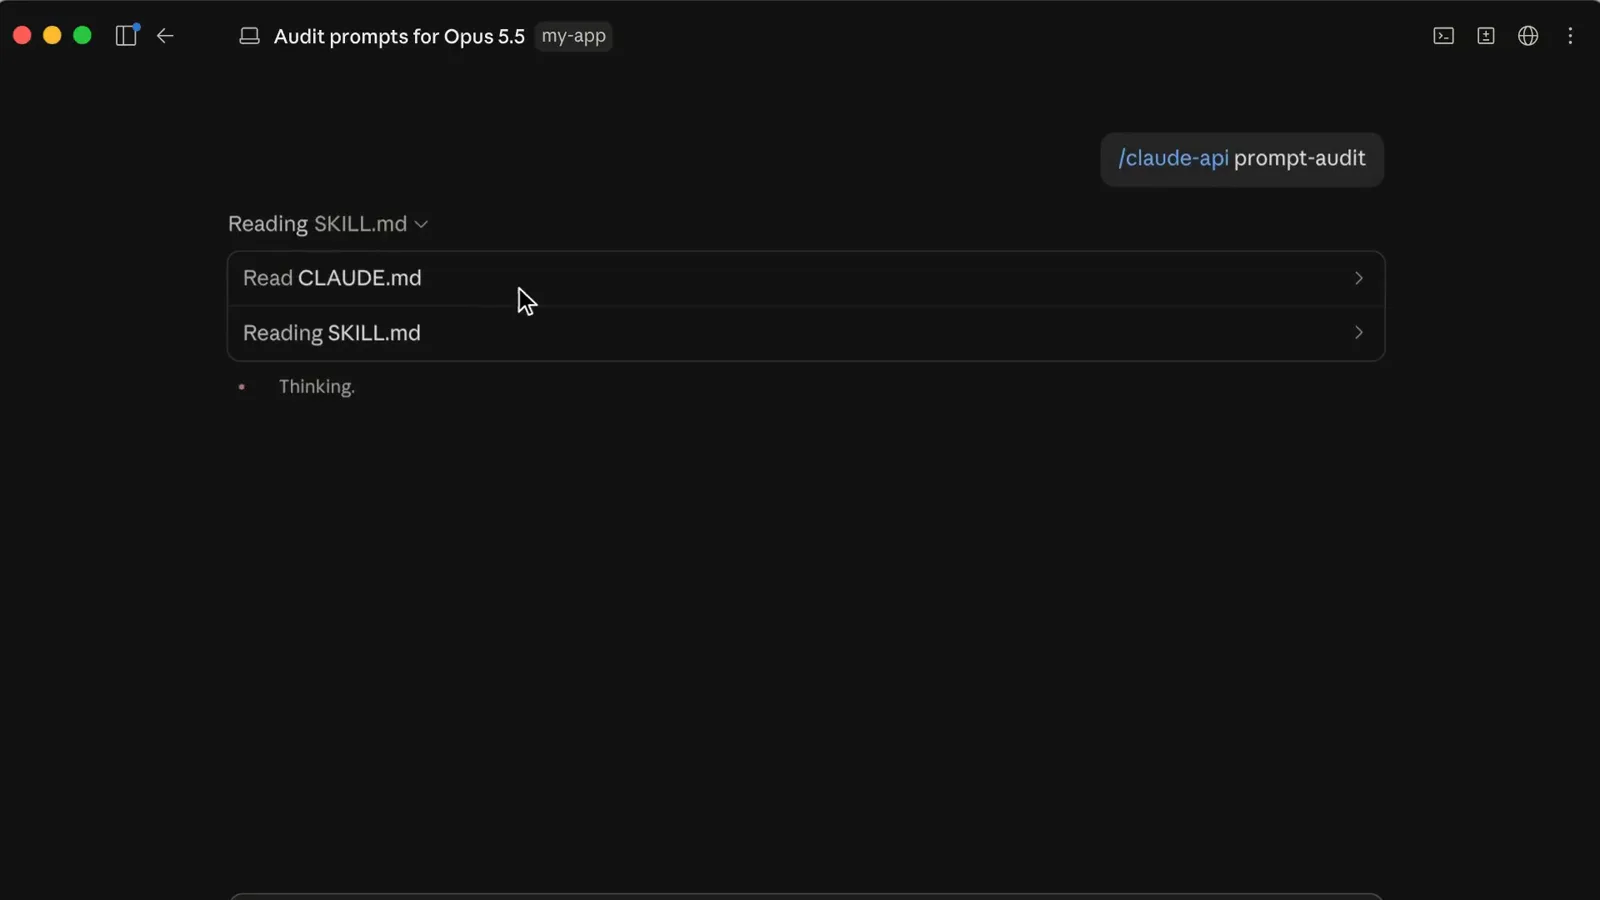
一条命令读完 CLAUDE.md 和技能文件,再把它们改写成适配 Opus 5.5 的版本。视频 3:12 处 - 13
让只读子代理跑在 Sonnet 上
只负责翻代码库的子代理用不上 Opus 级的推理。直接让 Claude 把 explore 子代理切到 Sonnet,并把项目里所有子代理的默认模型设为 Sonnet:它会在代理定义里写上 model 为 sonnet,再把 CLAUDE_CODE_SUBAGENT_MODEL 写进 .claude/settings.json,而主会话继续留在 Opus 5.5 上。便宜的只读探索用 Sonnet 就够,有时甚至 Haiku 也行。
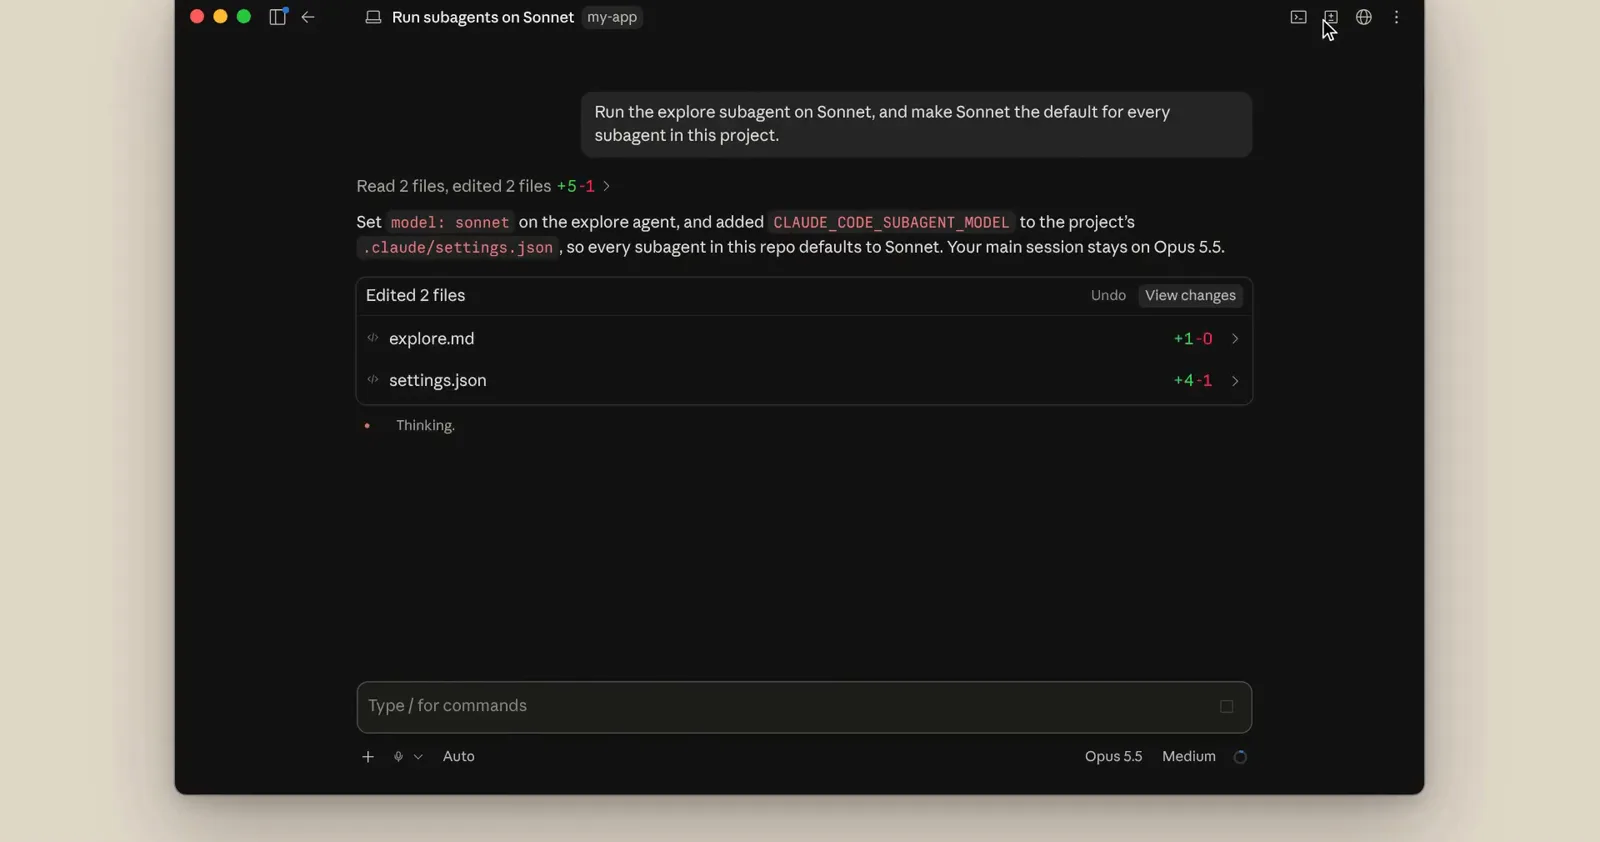
主会话留在 Opus 5.5,仓库里所有子代理的默认模型都换成 Sonnet。视频 2:42 处 - 14
一处配置固定子代理模型
想全仓库生效,就在 .claude/settings.json 的 env 块里加上 CLAUDE_CODE_SUBAGENT_MODEL,值设为 sonnet,和测试权限写在一起。之后每个子代理都自动继承这个更便宜的模型,不用逐个配置。把 Opus 5.5 留给主线程,那里的推理才真正值回票价。
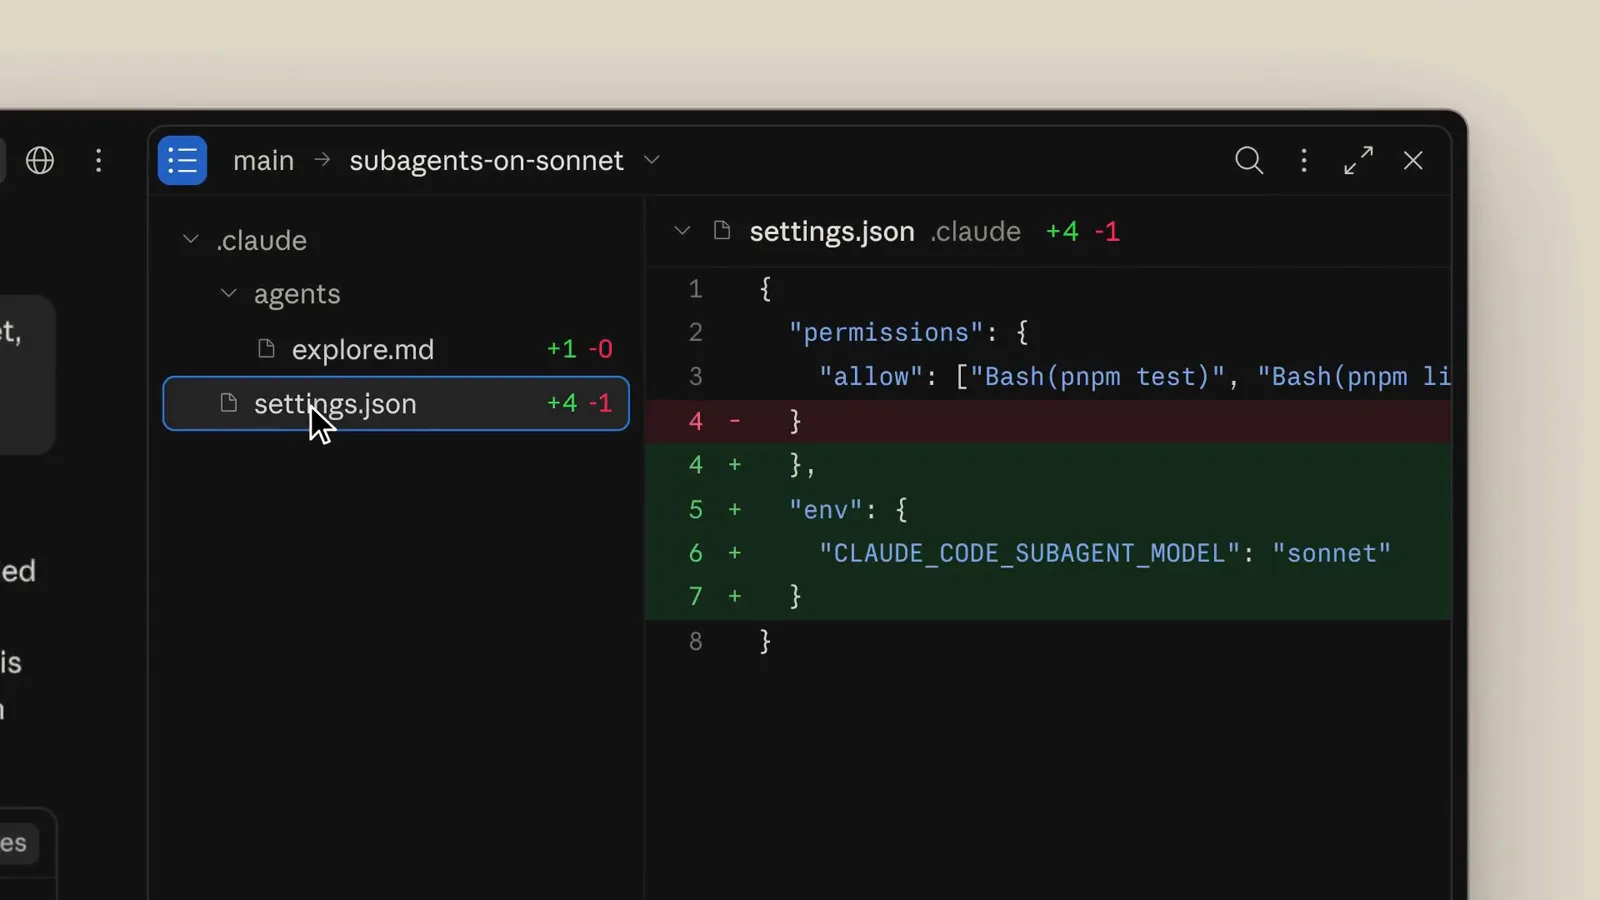
settings.json 里一行 env 配置,就把全仓库的子代理都指向了 Sonnet。视频 2:47 处 - 15
按成本曲线选思考强度
Anthropic 的 Terminal-Bench 4.0 图表把各强度档位的准确率对每次尝试的成本画在一张图上,Opus 5.5 高强度那一点是 64.2%、约 3.80 美元。在智能体编程上,中等强度用低得多的花费就能逼近高强度,这正是它被设为默认的原因。按任务价值选强度,别条件反射式地拉满。
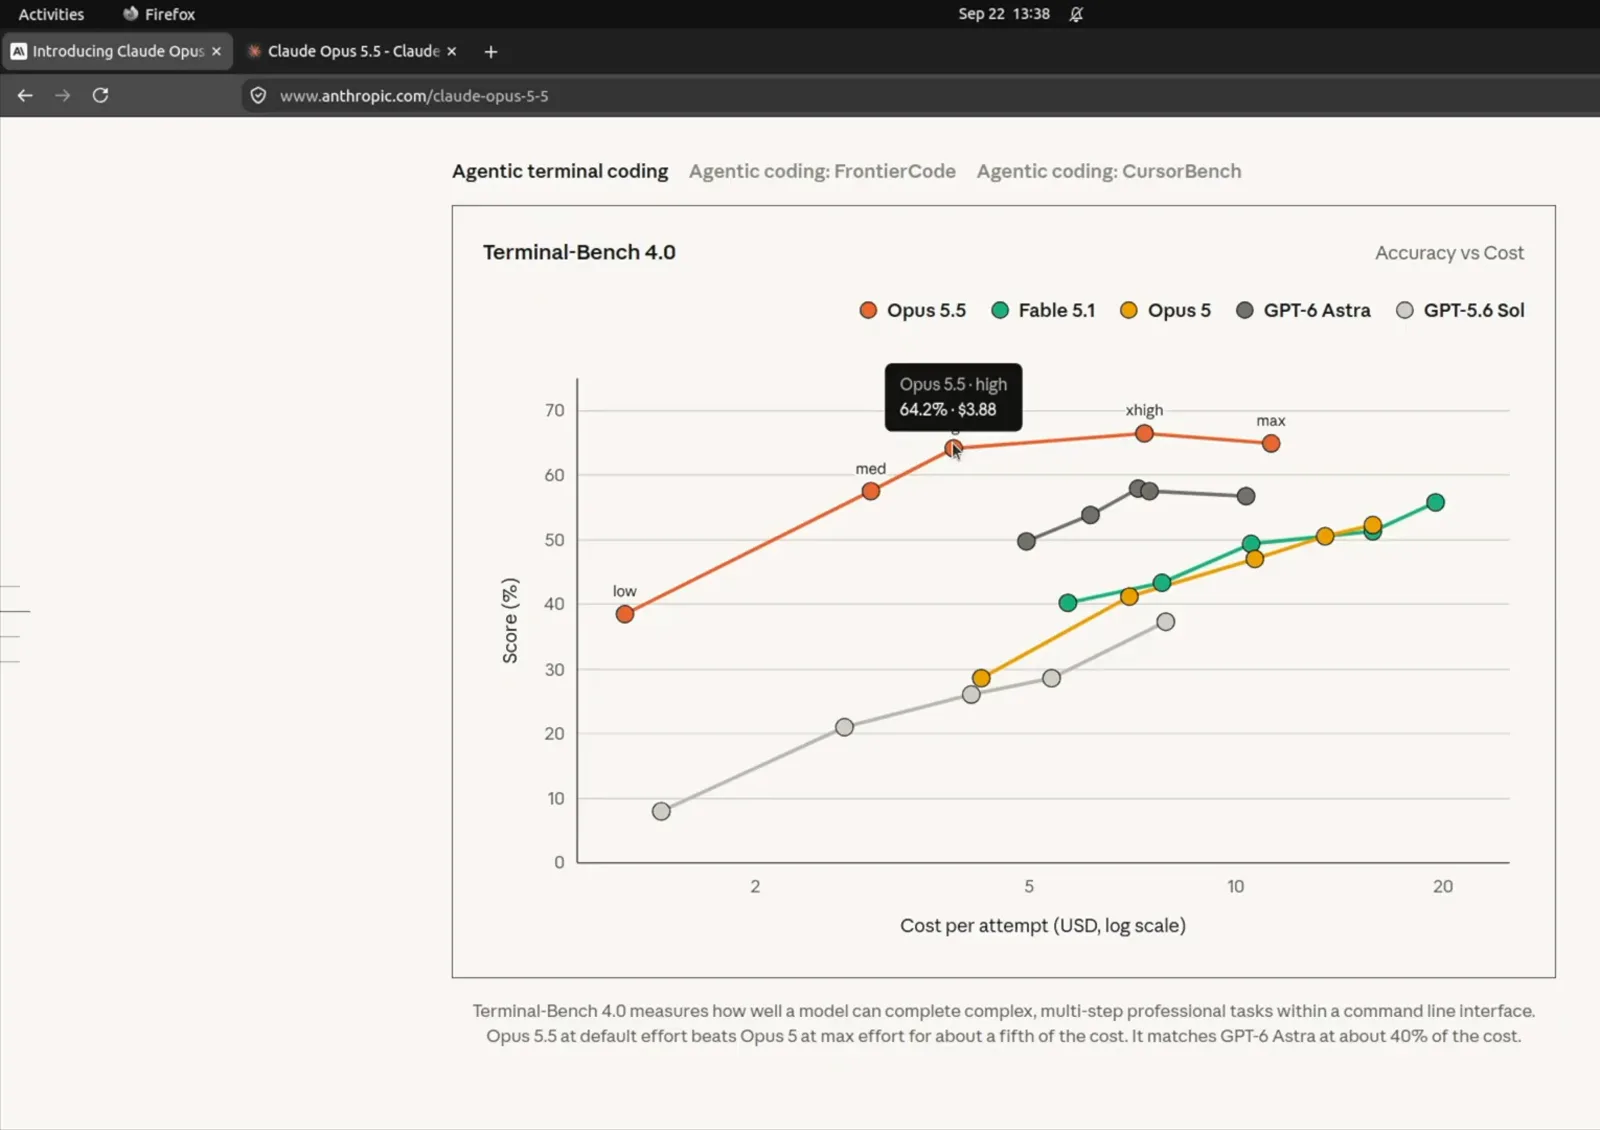
各强度档位的准确率对成本曲线——对多数编程任务,中等强度就是性价比最高的一档。视频 2:08 处 - 16
记住唯一红线:前沿大模型研发
Opus 5.5 不是什么请求都能接。分类器会拦下一小撮与前沿大模型研发相关的能力,比如某些 ML 加速器的内核开发,然后 Claude 回退到能力较弱的模型,并在对话里给出提示。常规的机器学习开发、研究和普通编码不受影响。看到回退提示时,换个说法重新描述任务,比原样重试有用。
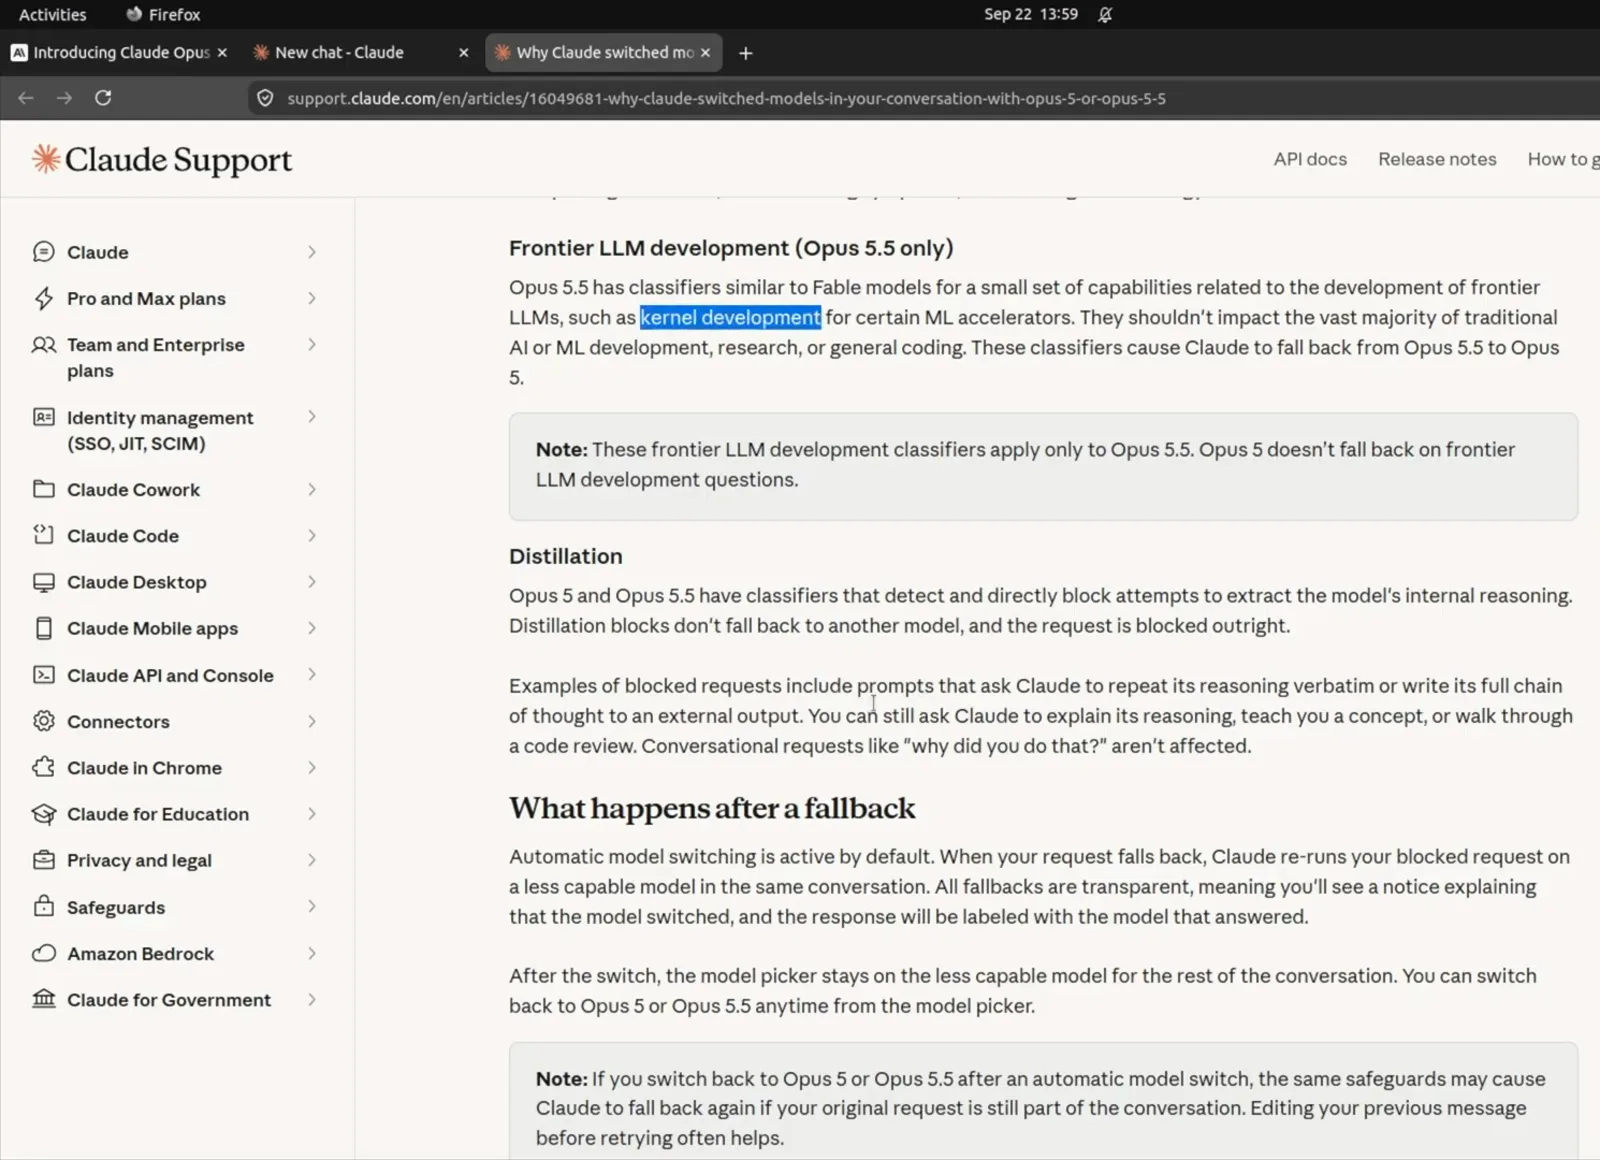
Claude 支持中心明确:前沿大模型研发类请求会透明地回退到较弱的模型。视频 3:10 处