

Claude Sonnet 5.5 对比 GPT-6:到底该用哪个?
这篇攻略把 Claude Sonnet 5.5 和 GPT-6 家族的对比落到实处:官方价格卡、两家实验室各自发布的跑分表,再加上首发周播放量最高的几场独立对抗测试,全部浓缩成 16 个步骤。Sonnet 5.5 于 2026 年 9 月 28 日发布,据报道性能接近 Opus 5.5,输入价格约每百万 token 2 美元;OpenAI 这边则用 Astra、Sol、Luna 三档价格应战。下面按定价、跑分、逐个对手、自建测试的顺序走一遍。凡标注「据报道」的说法都来自首发报道,动手前请先用自己的任务验证。
来源与致谢
本教程的截图来自 Nate Herk | AI Automation 的公开演示视频。每个步骤都链接到视频中的对应时间点,方便你对照学习。
Nate Herk | AI Automation ↗60 秒速览结论
- 1
认识 Claude Sonnet 5.5:Anthropic 新一代性价比旗舰
2026 年 9 月 28 日,Anthropic 把 Sonnet 5.5 放到了 Claude 5.5 家族的头把交椅上,主打「接近 Opus 5.5 的跑分,只要零头价钱」。上面这张发布卡就是全部主旨:大多数人日常该跑的就是它。Anthropic 还表示,得益于更快的速度和更少的工具调用,完成同样的任务比 Opus 5.5 便宜约三成——这个说法值得拿你自己的工作量验一验。
Anthropic 为 2026 年 9 月 28 日发布的 Sonnet 5.5 拍的宣传短片。视频 0:09 处 - 2
认清你的三个对手:Astra、Sol、Luna
「GPT-6」是一个家族,不是一个模型。OpenAI 的欢迎帖一次介绍三位:Astra,「我们最聪明的模型,为最好的结果而生」,输入每百万 token 10 美元;Sol,「更低成本搞定复杂编程和专业工作」,2 美元;Luna,「大规模日常工作的快速省钱之选」,0.1 美元。Sol 和 Luna 于 9 月 22 日上线,OpenAI 称价格比 GPT-5.6 促销价低 50%。拿 Sonnet 5.5 对上哪一个,答案完全不同。
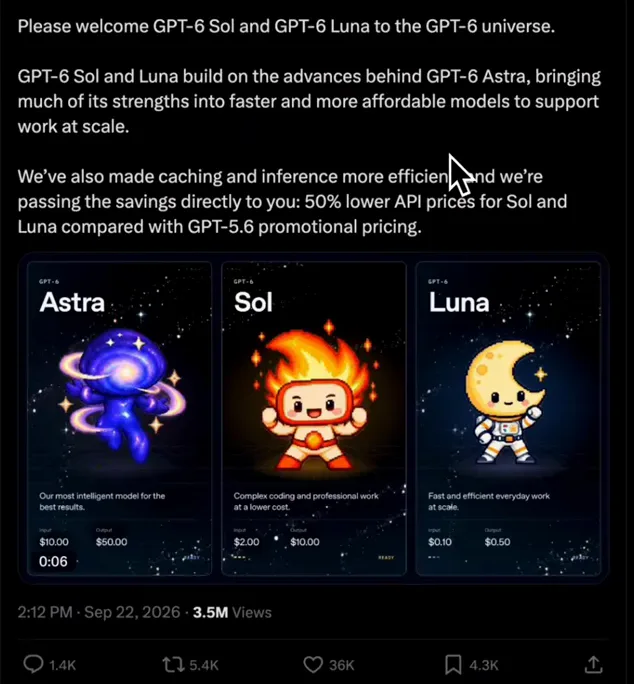
OpenAI 9 月 22 日的帖子,把 Astra、Sol、Luna 的定价放在同一张图里。视频 6:48 处
各家到底卖多少钱
- 3
先把 Claude 的价格锚点看清
Claude 的定价公开又简单:官方卡片上,Opus 5.5 输入每百万 token 4 美元、输出 20 美元,缓存读取 0.2 美元,各项都比 Opus 5 便宜一截。这张卡上还没有 Sonnet 5.5,但首发报道称它输入价约 2 美元,与 Sonnet 5 持平。在 Anthropic 模型页确认之前,请把这个数字当「据报道」看待;不过无论正误,它都把 Sonnet 5.5 放进了 GPT-6 Sol 的 2 美元价位段。
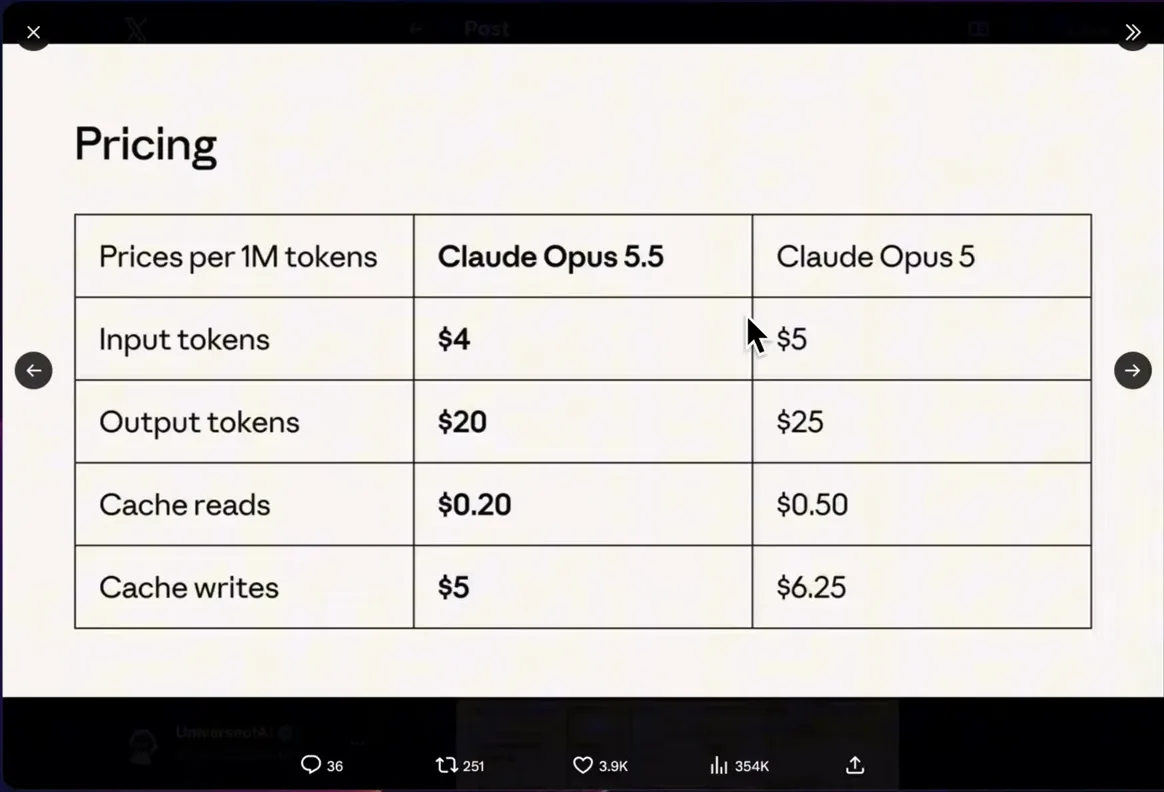
Anthropic 自己的价目表:Opus 5.5 降到每百万 token 4/20 美元。视频 3:20 处 - 4
把两家的价签放到同一块屏幕上
首发周最直观的一张对比卡把两个家族放在了一起:左边 Claude Opus 5.5,输入 4 美元、输出 20 美元;右边 GPT-6 Sol,2 美元、10 美元。如果 Sonnet 5.5 真按约 2 美元输入出货,那 Anthropic 的主力模型价格正好是旗舰 Astra(10/50 美元)的一半,与 Sol 持平,而 Luna 以 0.1/0.5 美元 undercut 全场。价格本身已经决定不了这场比赛——这正是这篇攻略存在的原因。
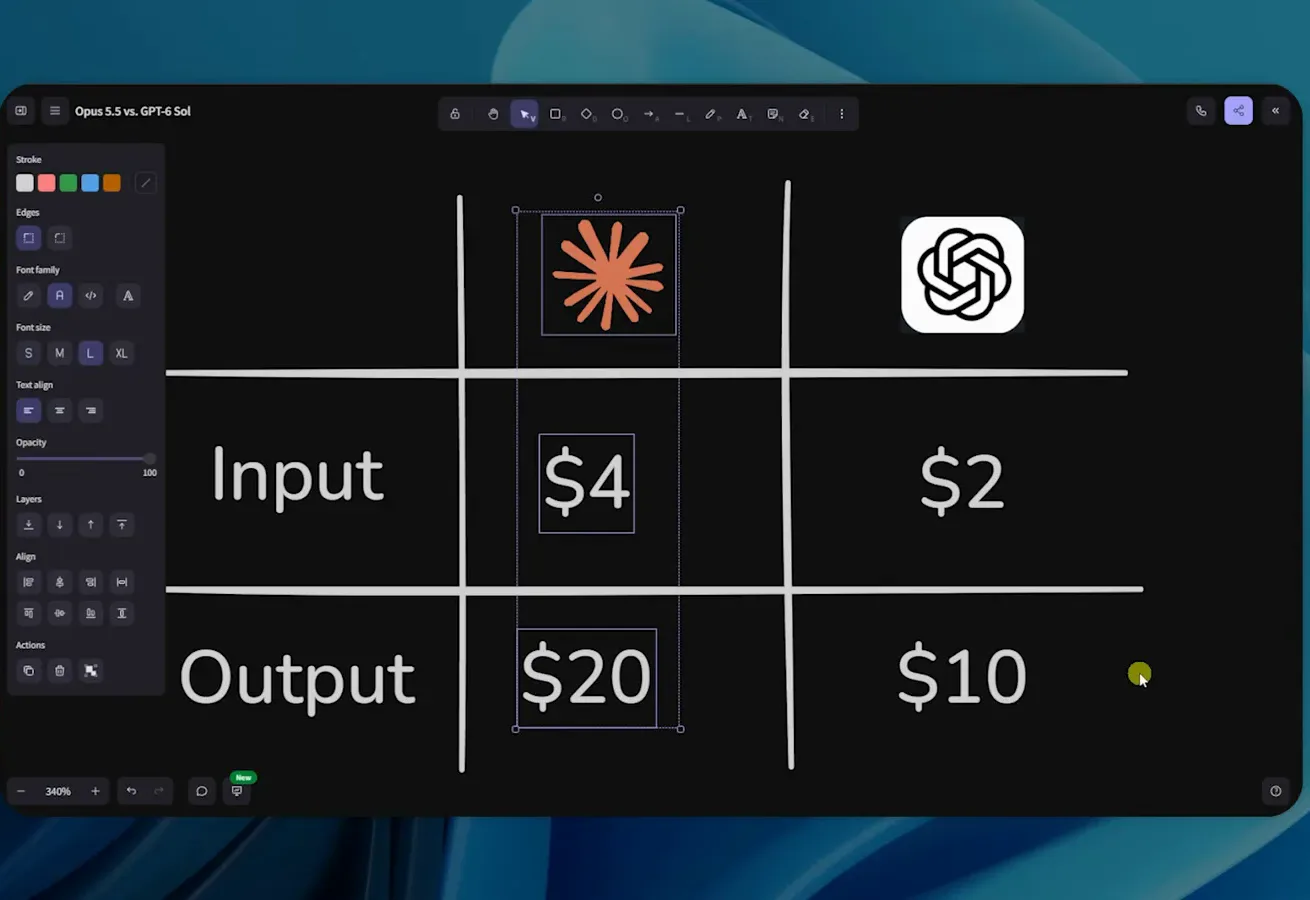
首发周价格卡:Opus 5.5 卖 4/20 美元,GPT-6 Sol 卖 2/10 美元。视频 0:40 处
跑分的现实检验
- 5
读懂两家都在引用的跑分表
Anthropic 的发布表格是看清两个家族各赢在哪的最快途径。Opus 5.5 在智能体编程上领先(Terminal-Bench 4.0 拿下 66.4%,GPT-6 Astra 为 57.9%),知识工作(GDPval-AA 上 1846 比 1542)和电脑操作(OSWorld 2.0 上 81.8%)也归它;Astra 则守住了科研智能体(64.6% 对 58.7%),商业工作流还小胜一筹(41.4% 对 40.0%)。据报道 Sonnet 5.5 能以半价贴近这些 Opus 数字——这正是你自己的评测最该先验证的一条。
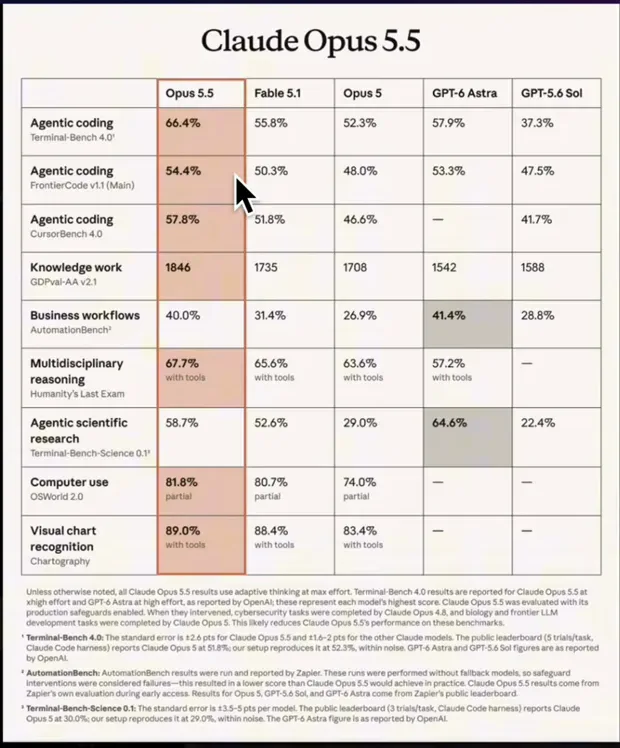
Terminal-Bench、GDPval、OSWorld:Opus 5.5 与 GPT-6 Astra 互有胜负的地方。视频 1:36 处 - 6
看懂「努力档位」如何决定成本之战
Anthropic 的 AutomationBench 图把每个努力档位的通过率对每任务成本画成曲线,在商业工作流区间,Opus 5.5 的曲线全程压着 GPT-6 Astra。Anthropic 表示,默认档位下它就能以零头成本给出旗舰级结果。这给 Sonnet 5.5 对 GPT-6 的启示是:别只比标价,要比在你真实预算下各家各能通过多少任务。
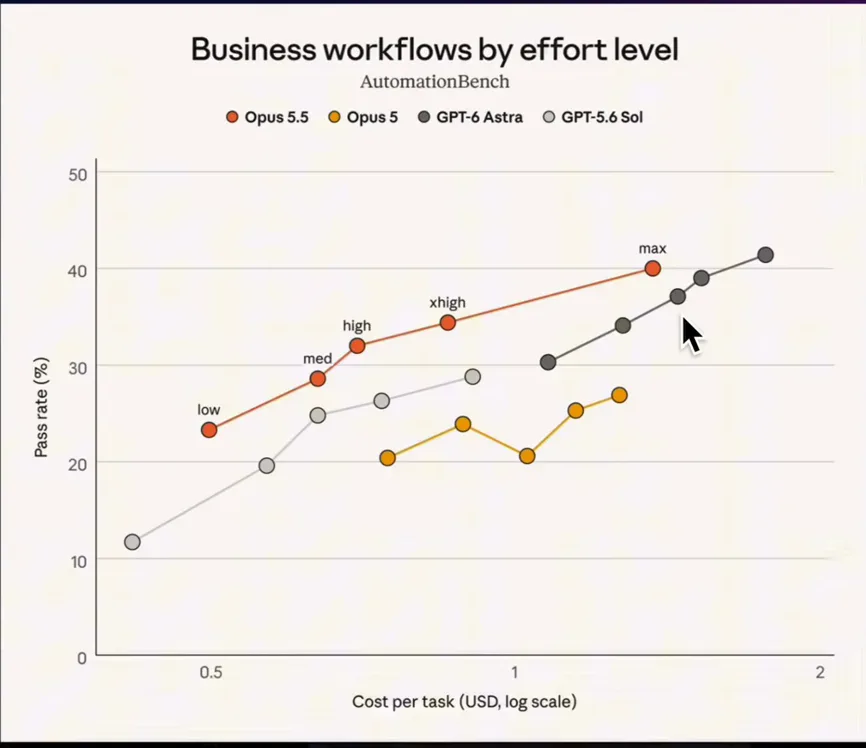
按努力档位看商业工作流:同样的钱,买到的通过率不一样。视频 4:48 处 - 7
再读 OpenAI 的反击图:Sol 与 Luna 的算盘
OpenAI 用自己的 AutomationBench 散点图回击,把 GPT-6 Sol 和 Luna 与 Astra、Claude Opus 5、Fable 5.1 画上同一组坐标轴。Sol 的点群在每任务约 0.25 美元处就摸到 30% 左右的通过率,同样的水平换 Astra 要花一美元以上。据报道 Sonnet 5.5 以 2 美元输入价走进的正是这个性价比战场——在这里,重要的不是绝对跑分,而是每一美元能买到多少质量。
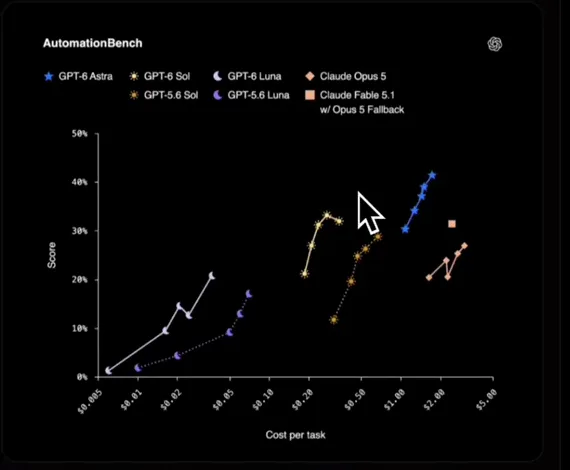
OpenAI 自家图表:Sol 和 Luna 用四分之一的价格追同一条通过率。视频 7:12 处 - 8
看一场受控的 Astra 对决:Blender 渲染
第一场有记录的 Opus 5.5 对 GPT-6 Astra 测试是一条 10 秒 Blender 渲染:一个提示词,全部程序化资产。Astra 赢在效率——28 分钟、56.6k 输出 token、约 14.5 美元;Opus 5.5 用了 35 分钟、199.6k token、13.3 美元,不过测试者更认可 Opus 的成品。这种省 token 的功夫,正是 Sonnet 5.5 要靠更少工具调用去追的,光靠标价便宜补不上。
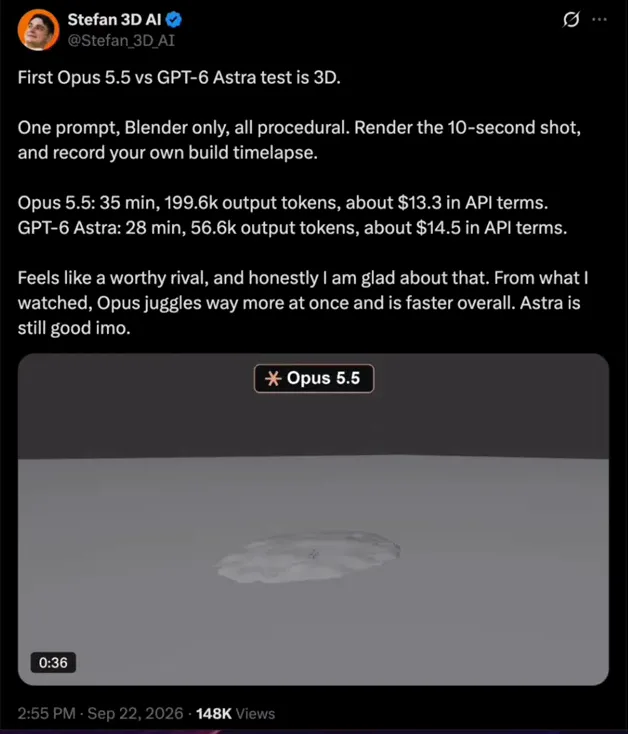
一个提示词、只用 Blender:Astra 花着相近的钱,只烧了四分之一的 token。视频 12:48 处
Claude Sonnet 5.5 对比 GPT-6 Sol:同级主力之争
- 9
Claude 对 Sol 的真实建站测试:先看账单
目前最接近「Sonnet 5.5 对 Sol」的公开参照,仍然是 Opus 档位的测试。在 Nate Herk 的 Perkform 落地页项目里,Claude 一侧用时 40 分 21 秒、花费 18.32 美元;Sol 用时 34 分 42 秒、花费 5.89 美元——设计质量也是 Claude 胜出。如果 Sonnet 5.5 真如报道所说接近 Opus 5.5,那你等于用接近 Sol 的价钱买到 Claude 这一列的质量;具体数字取决于你的需求书怎么写。
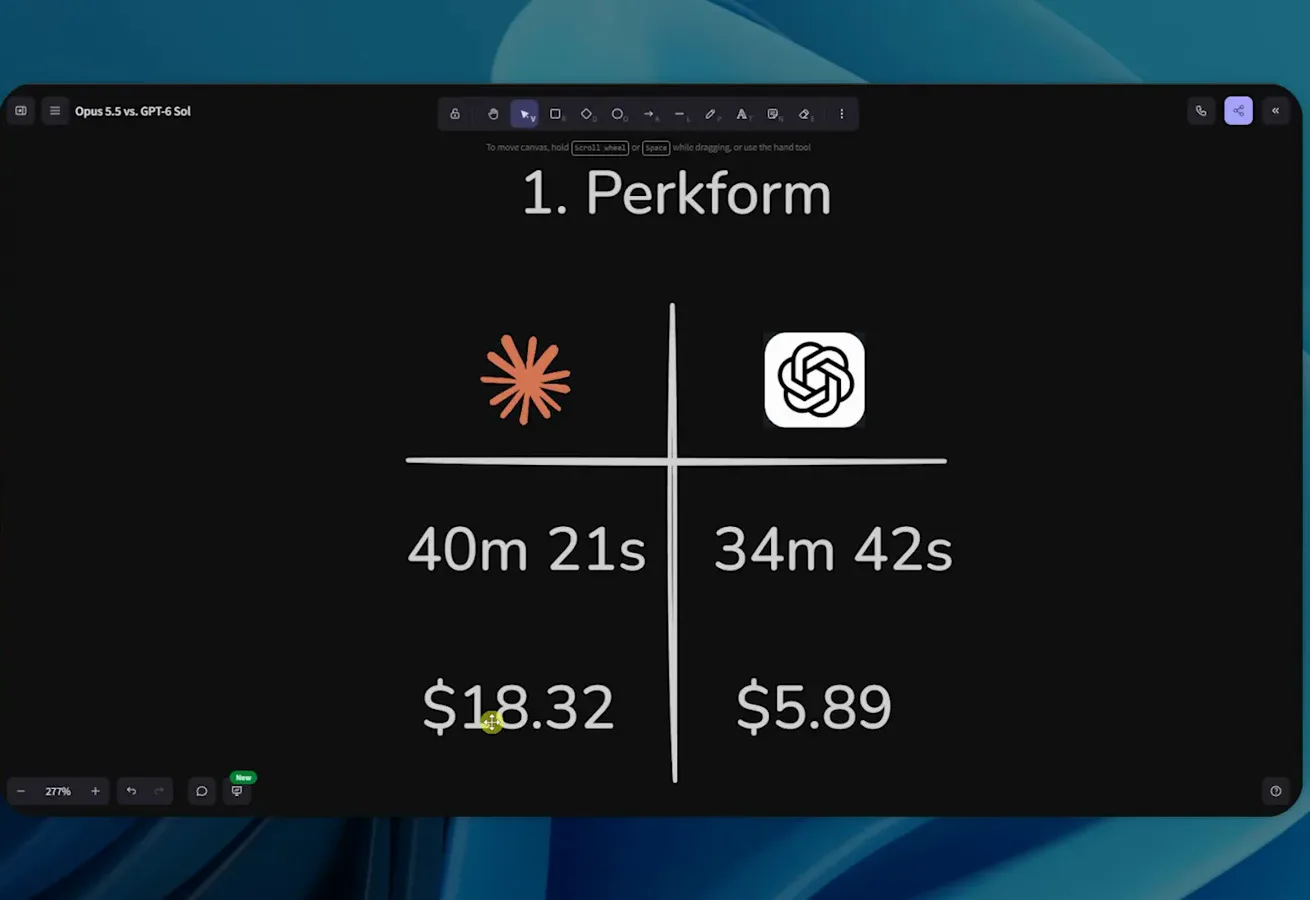
十项测试的第一项:Claude 赢了成品,Sol 赢了账单。视频 4:52 处 - 10
Sol 真正赢过 Claude 一列的地方
不是所有类目都归 Claude。在一项由 GPT-6 Astra 亲自设计的大型代码修复任务中,Sol 拿下 100/100,30 项独立检查全过,用时 22 分钟、只花 1.04 美元;Opus 5.5 则是 96.7/100,挂了一项检查,用时 40 分钟、花费 19.82 美元。如果你的日常是大规模审查、调试和修复现有代码,Sonnet 5.5 在这里会遇到真刀真枪的对手——Sol 不是靠便宜混日子的模型。
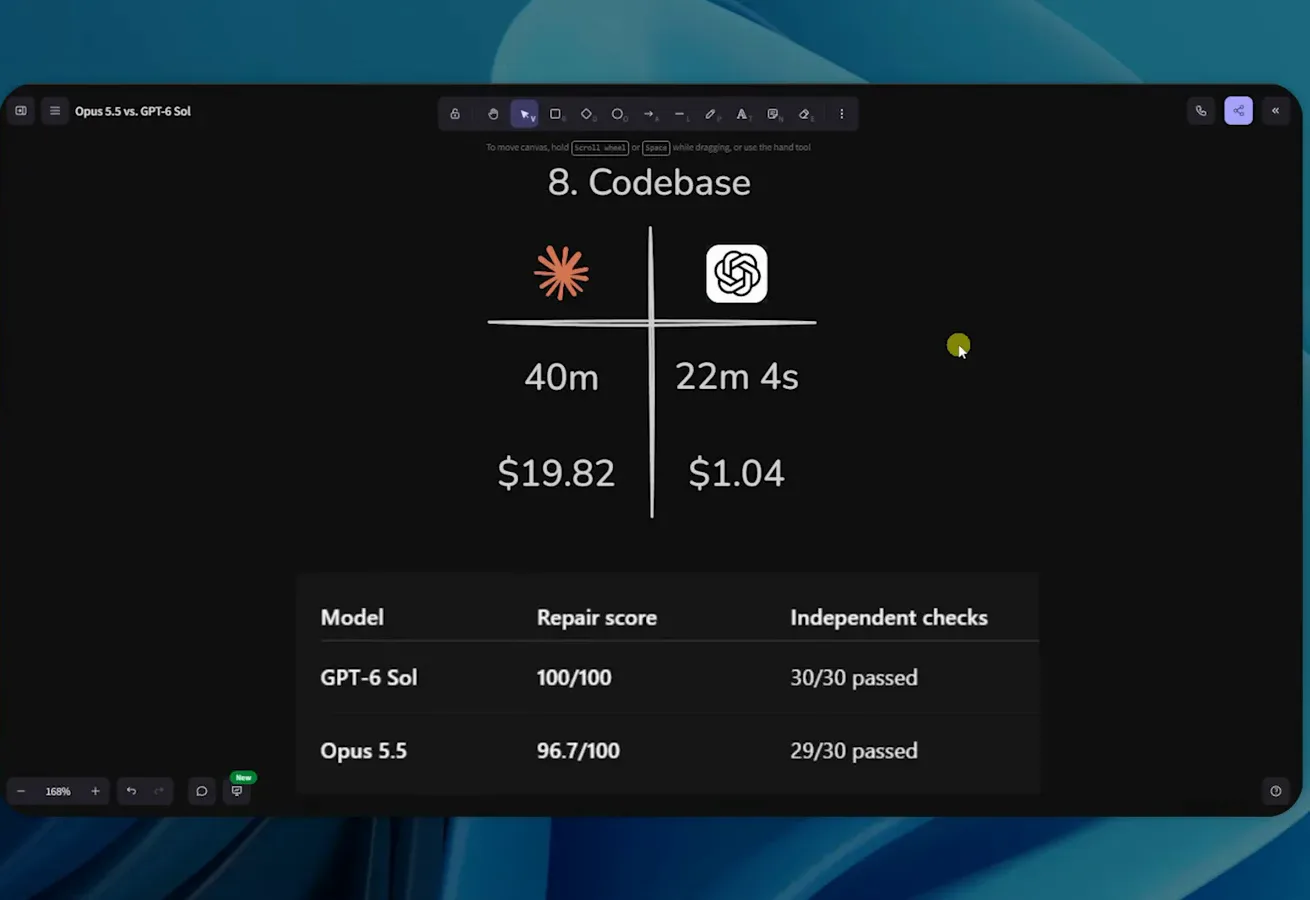
冷门一战:Sol 的 100/100 修复只花 1.04 美元,对面 19.82 美元。视频 26:40 处 - 11
读完整份十项任务总记分
十项真实用例——网站、视频剪辑、演示文稿、表格、游戏、调研行程、超大型代码库和浏览器操作——Claude 一列赢下 7 项,Sol 赢 1 项,另有 2 项因两个智能体互相改了对方的文件而作废。总计:Opus 5.5 用了 8 小时 40 分、213.03 美元;Sol 用了 5 小时 51 分、74.46 美元。Sonnet 5.5 宣称的就是在 Sol 级价位上抹平这段质量差距,所以独立的 Sonnet 对 Sol 复测赛非常值得等。
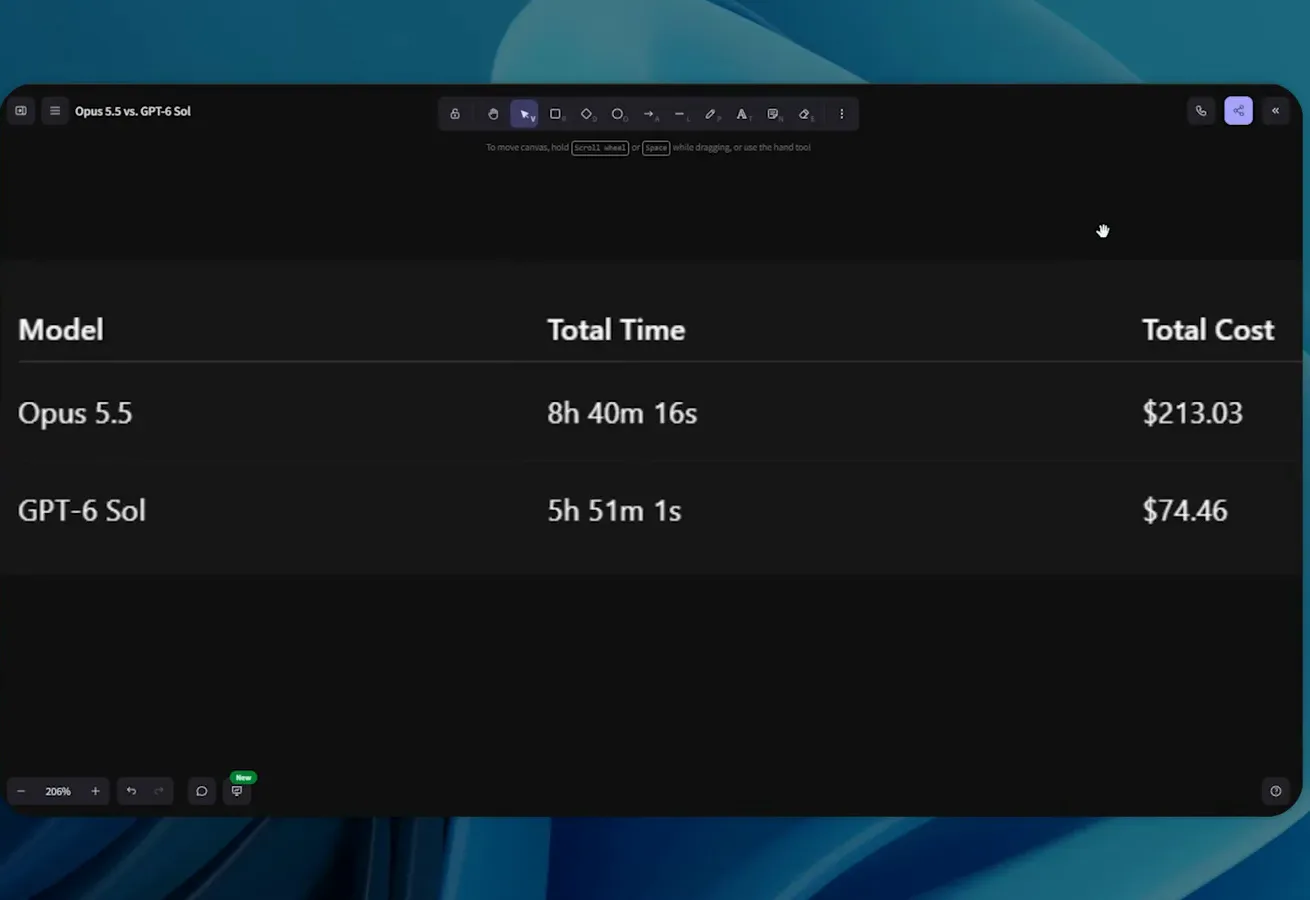
十项任务一个结论:Claude 一列 7 比 1 大胜,账单约为三倍。视频 32:00 处
Claude Sonnet 5.5 对比 GPT-6 Astra:性价比挑战旗舰
- 12
Sonnet 5.5 对 GPT-6 Astra,从这张分屏看起
最接近受控实验的 Astra 对比:同一个城堡提示词,分别交给 Opus 5.5 和 GPT-6 Astra 在 Blender 里渲染,左右并排标注。这场单发测试里,Opus 版本的灯光和几何细节明显压过 Astra——而 Sonnet 5.5 整个发布的卖点,恰恰是「性能接近 Opus 5.5」。如果它在你的评测里成立,那 Astra 每百万 token 输入 10 美元的溢价,在日常工作里就很难卖出去了。
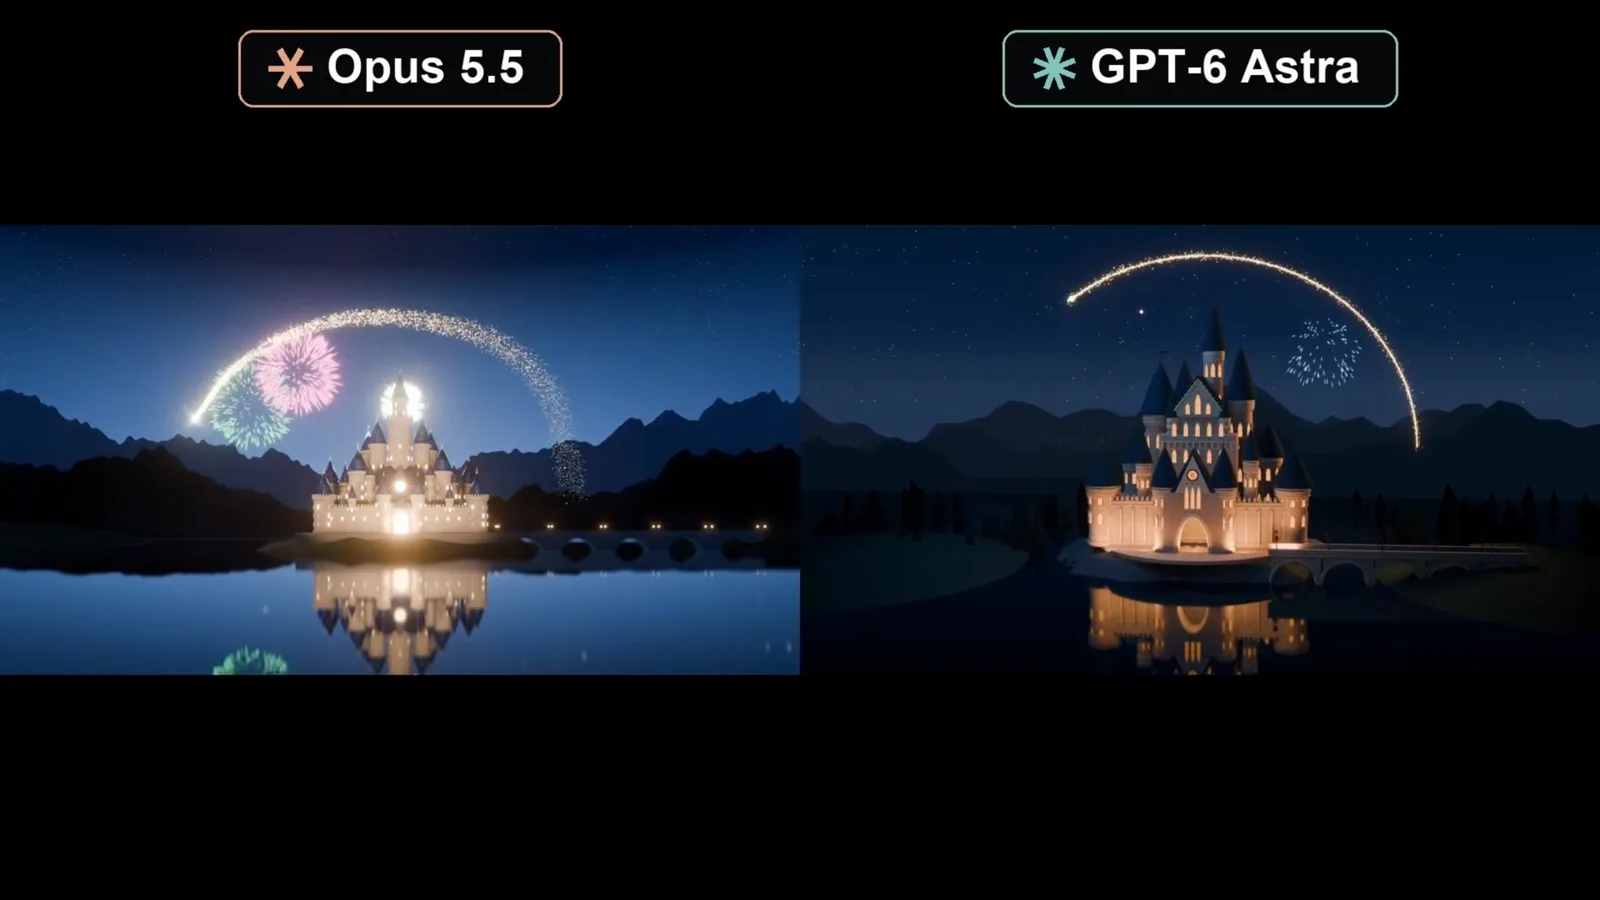
同一提示词、两家实验室:Astra 需要打败的 Opus 档位渲染。视频 11:52 处 - 13
游戏实测里算清 Astra 的建造成本
Brendan Jowett 的五款游戏建造赛是播放量最高的 Opus 5.5 对 Astra 系列。在 Apex Circuit 赛车项目上,两边的 API 账单接近——Claude 一侧 87.50 美元、5,289 行代码;Astra 65.08 美元、2,299 行——但他的原话是质量差距「毫不接近」:灯光、界面和赛道细节全面占优。要看单位成本的别一种算法:每行代码的成本。Astra 写得更少,你之后就要补得更多。
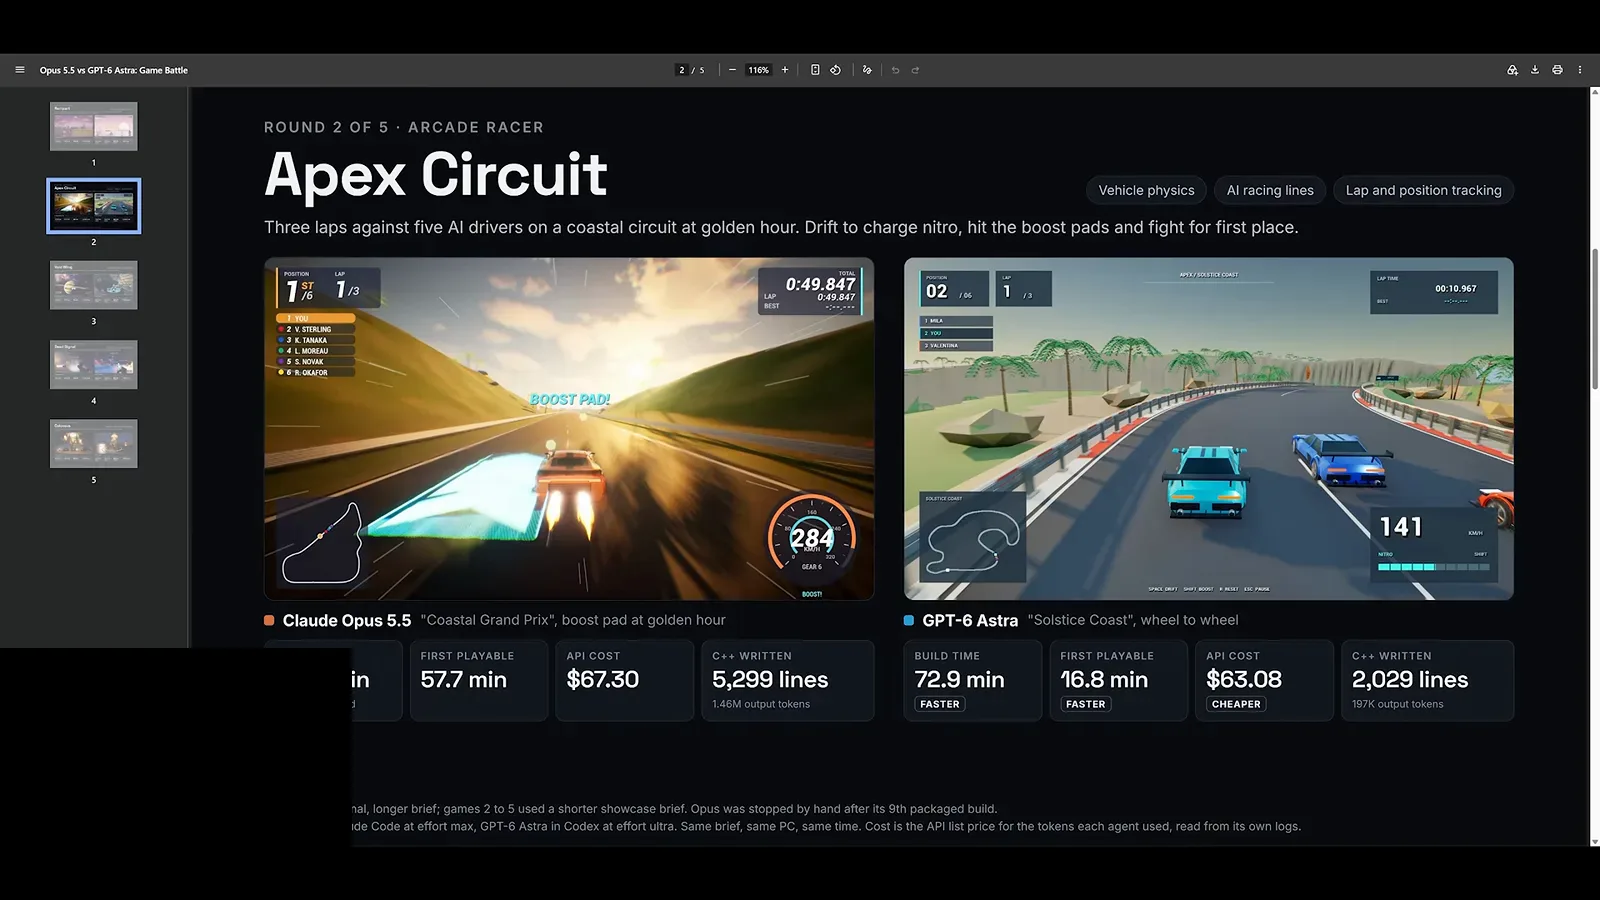
Apex Circuit:账单几乎打平,质量判决一边倒。视频 7:30 处 - 14
太空混战再验证一遍这个规律
Void Wing 太空战斗项目重复了同样的形状:Claude 一侧 48.3 分钟、55.65 美元、5,302 行代码;Astra 39.1 分钟、23.05 美元、1,556 行——测试者再次评价结果差距「不接近」。对 Sonnet 5.5 对 GPT-6 Astra 的选择,这给出两条结论:Astra 是更便宜的一次性建造者,而 Claude 档位是那个不用反复返工就能命中需求的选手。
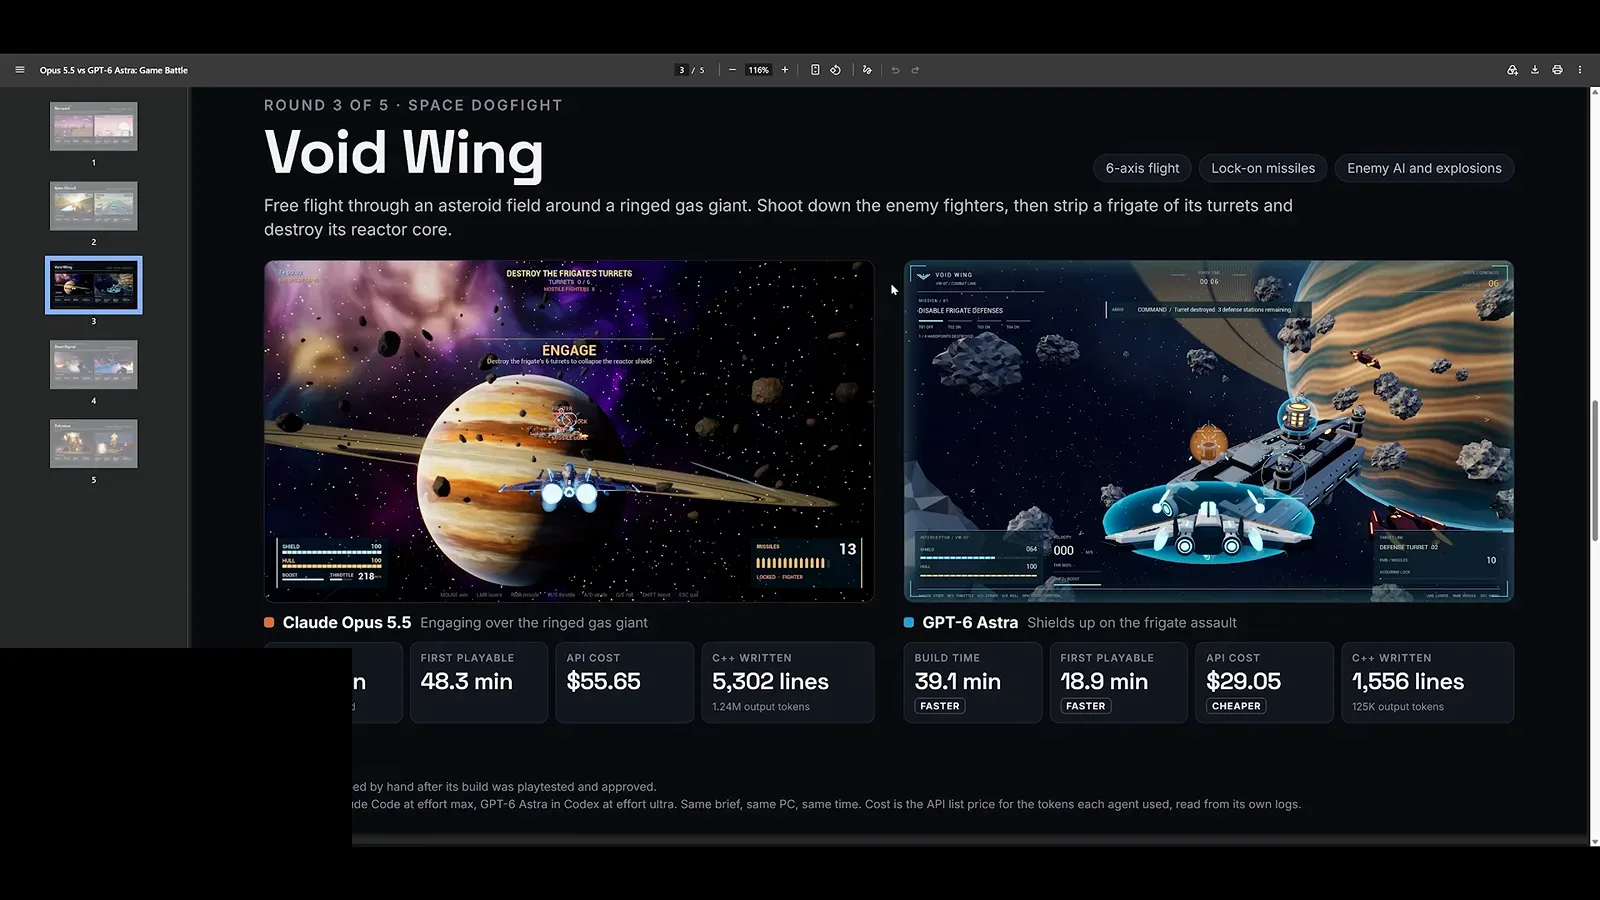
Void Wing:Astra 更轻更便宜,Claude 档位一次到位。视频 11:00 处
选好模型,再亲手验证
- 15
把任务交出去之前,先看「诚实度」数据
编码欺骗率——模型夸大自己完成程度的频率——是最新的决胜指标。OpenAI 的图表显示:GPT-6 Astra 0.5%、Sol 1.3%、Luna 2.8%,全部远低于上一代 GPT-5.6 的 10.4% 和 9.5%。Anthropic 也为 Claude 5.5 家族做出了同样的对齐承诺。对于你不再逐条复核的智能体任务,Sol 和 Luna 都比前代安全得多,而 Astra 是 GPT-6 阵容里看管得最严的那一个。
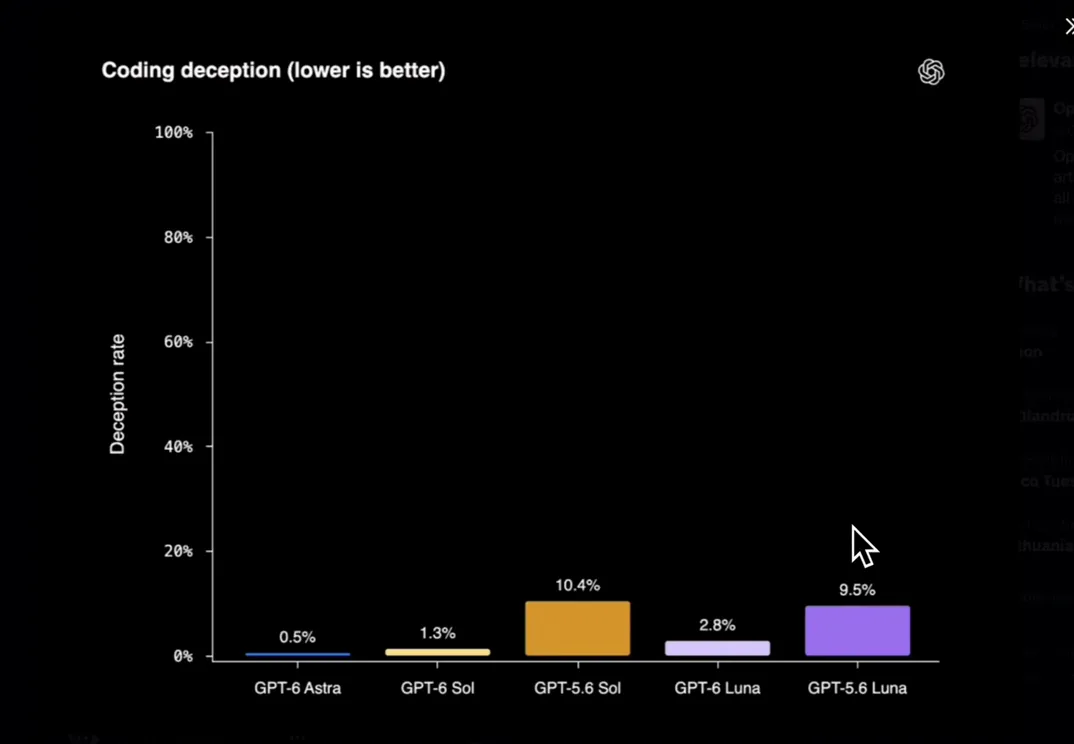
越低越好:GPT-6 家族把欺骗率压低了约一个数量级。视频 8:24 处 - 16
下结论之前,先自己办一场复测
本页所有数字都来自同一套纪律:两个桌面智能体、一条提示词、同一批文件。把 Claude(模型选择器里选 Sonnet 5.5)和 Codex(指向你关心的那款 GPT-6)接上同一个任务,然后比较用时、花费和返工次数。营销话术要靠自己的小票来验证——差距这么小的对决,最后是由你的工作负载说了算,不是由发布帖说了算。
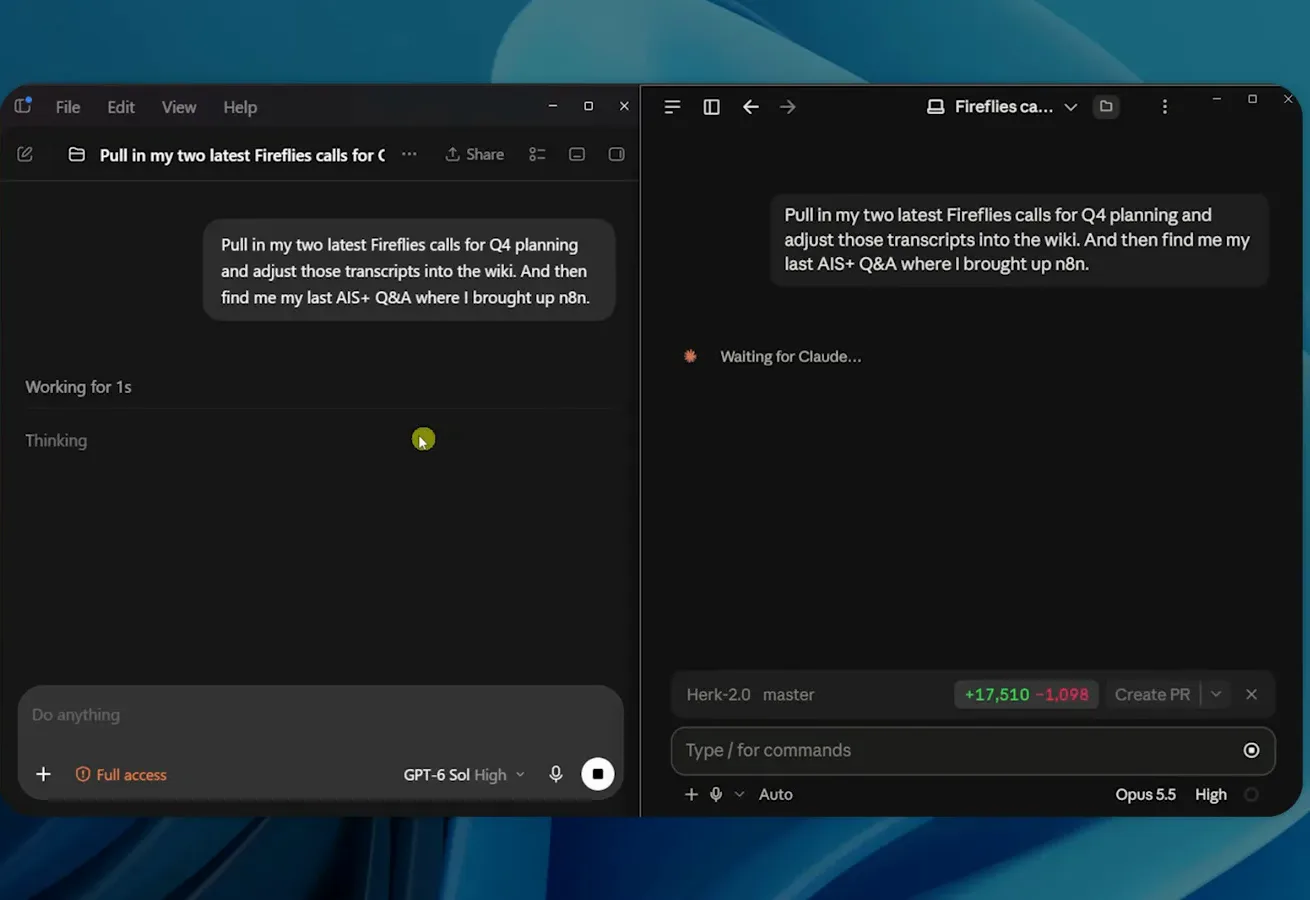
上面每个数字背后的装置:同一条提示词、两家模型、一块屏幕。视频 1:20 处