

Claude Fable 5.1 使用攻略:把最难、最长的活交给它
Claude Fable 5.1 是 Anthropic 在 2026 年 9 月 1 日发布的前沿模型,主打复杂推理、编程、知识工作与长程智能体任务,官方甚至演示过用它挖掘软件漏洞。这套用法在旧模型上行得通的习惯,到了它这里反而会拖后腿。本攻略整理自 AI LABS 的实测教程,发布与跑分画面来自 Developers Digest,实时看板案例来自 Riley Brown 的实战演示,你会看到 Fable 5.1 与 Opus 5、Sonnet 该怎么分工、怎么提示才能让它整段自主跑完,以及怎么避免周限额被快速烧穿。
来源与致谢
本教程的截图来自 AI LABS 的公开演示视频。每个步骤都链接到视频中的对应时间点,方便你对照学习。
AI LABS ↗先认识模型,再花额度
- 1
从官方公告开始认识它
Fable 5.1 于 2026 年 9 月 1 日发布,同场亮相的还有受限版本 Claude Mythos 5.1。公告本身就是最好的能力地图:开篇聚焦智能体科学研究、编程、知识工作与长程任务——也正是本攻略展开的四个方向。先通读一遍,知道它承诺了什么,再拿自己的真实任务逐条验证。
2026 年 9 月的官方公告包含跑分、安全与 Mythos 5.1 章节。视频 0:22 处 - 2
带着怀疑的眼光读跑分
Anthropic 官方表格里,Fable 5.1 的智能体科学研究得分 52.6%,是 Fable 5 的两倍多,在智能体编程、知识工作与跨学科推理上也压过 Opus 5 和 GPT-5.6 Sol。但跑分描述的是模型上限,不是你任务的必然结果。正确姿势是拿它说服自己在一个硬核项目上试水,而不是期待每条提示都跑出旗舰水准。
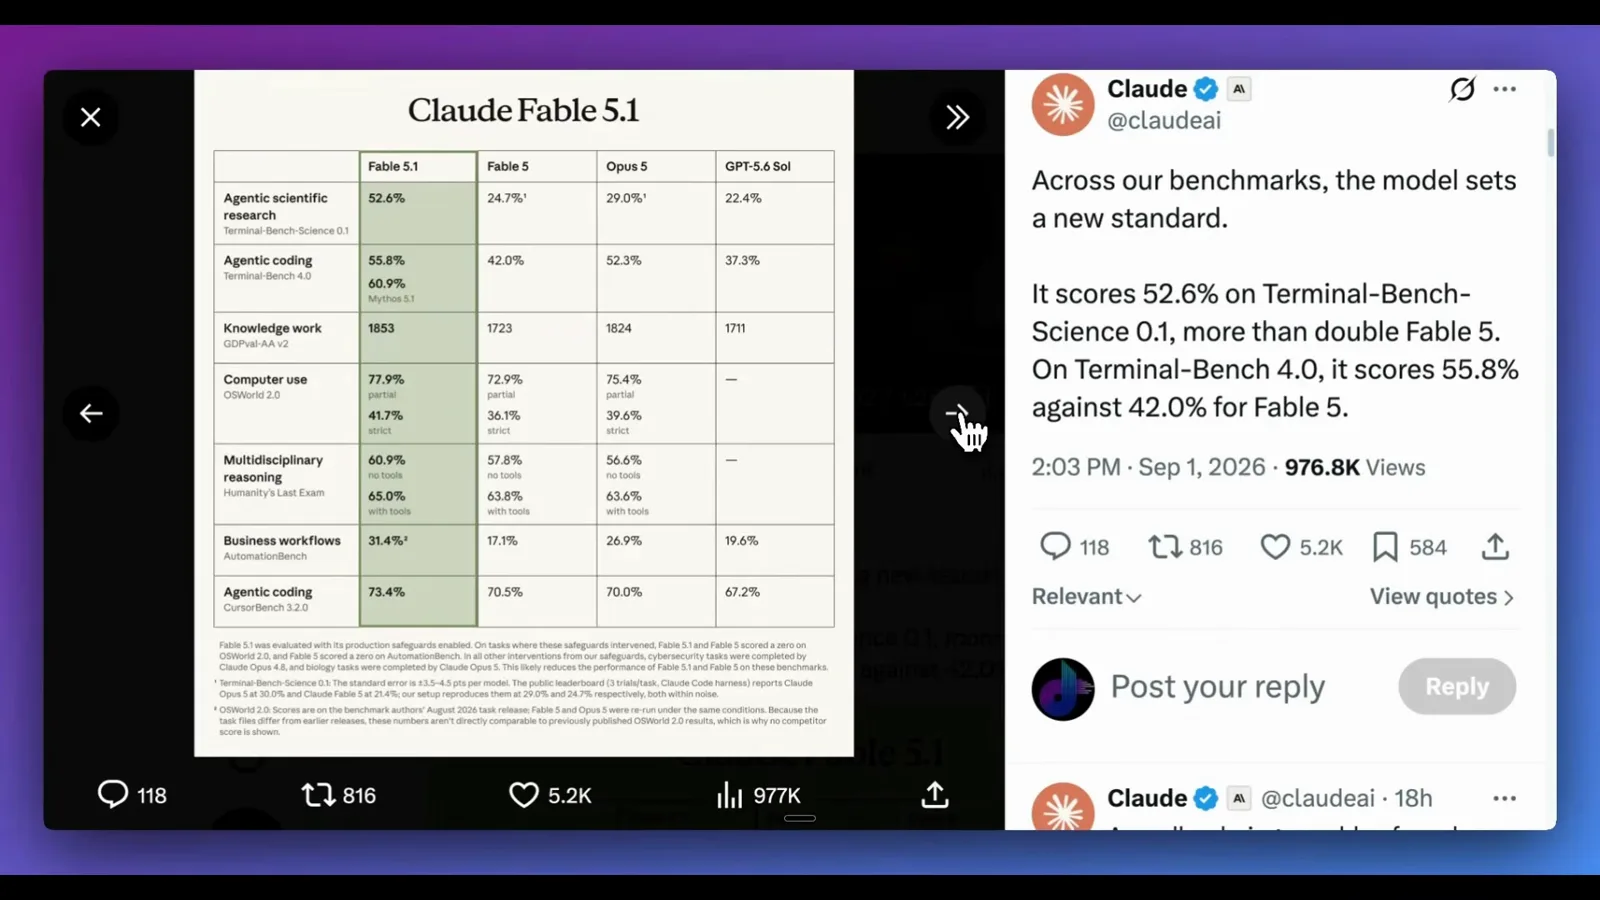
来自 Anthropic 发布帖的 Terminal-Bench、GDPval 与 OSWorld 成绩。视频 0:40 处 - 3
比 Fable 5 更少被打断
Anthropic Claude Code 负责人 Boris Cherny 在 X 上说明:Fable 5.1 的生物安全护栏对正常请求的干预比 Fable 5 少 85%,Claude Code 会话中的网络安全干预约减少 60%。落到体感上,提示词里只是沾到安全相关的字眼,任务也不容易被中途掐断。护栏仍然存在,后面几节会讲怎么绕开残余的那些。
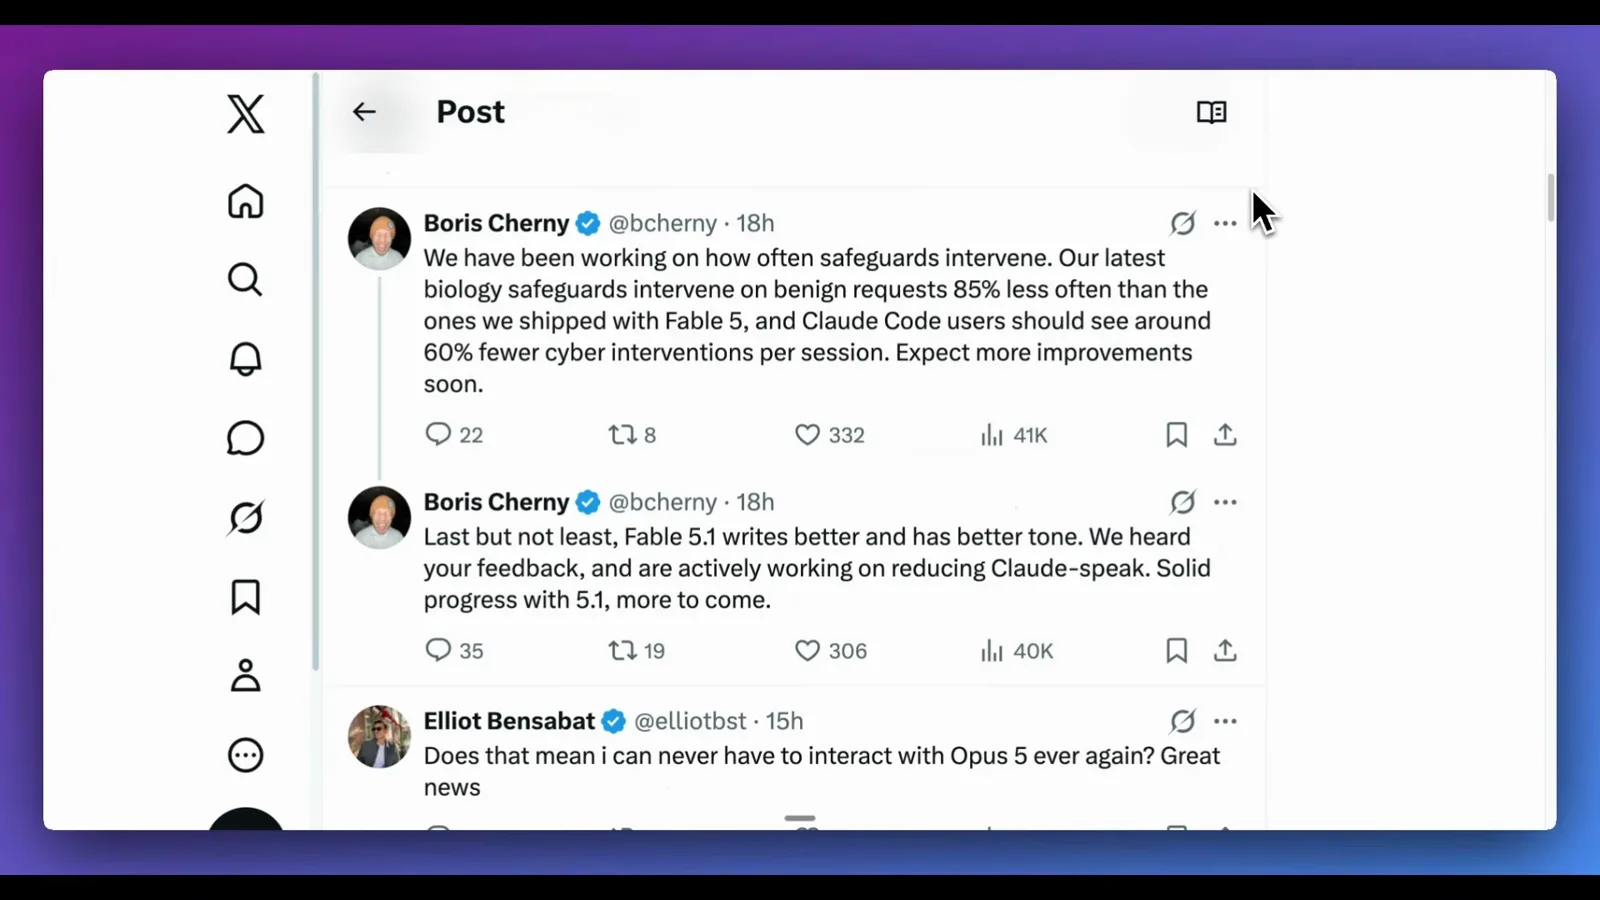
Anthropic 官方说明 Fable 5.1 相对 Fable 5 的安全调整。视频 6:30 处
选到 Fable 5.1,先给额度上保险
- 4
先定 effort,再定预期
在 Claude Code 里输入 /effort,可在 low、medium、high、xhigh、max 与 ultracode 之间选择——一条从“更快”到“更聪明”的滑杆。AI LABS 实测发现:low 档的 Fable 5.1 在代码审查中抓到 61% 的问题,反而高于 high 档的 57.1%,还快了约三分钟。默认 low 起步,只有结果确实值回票价时才升档。
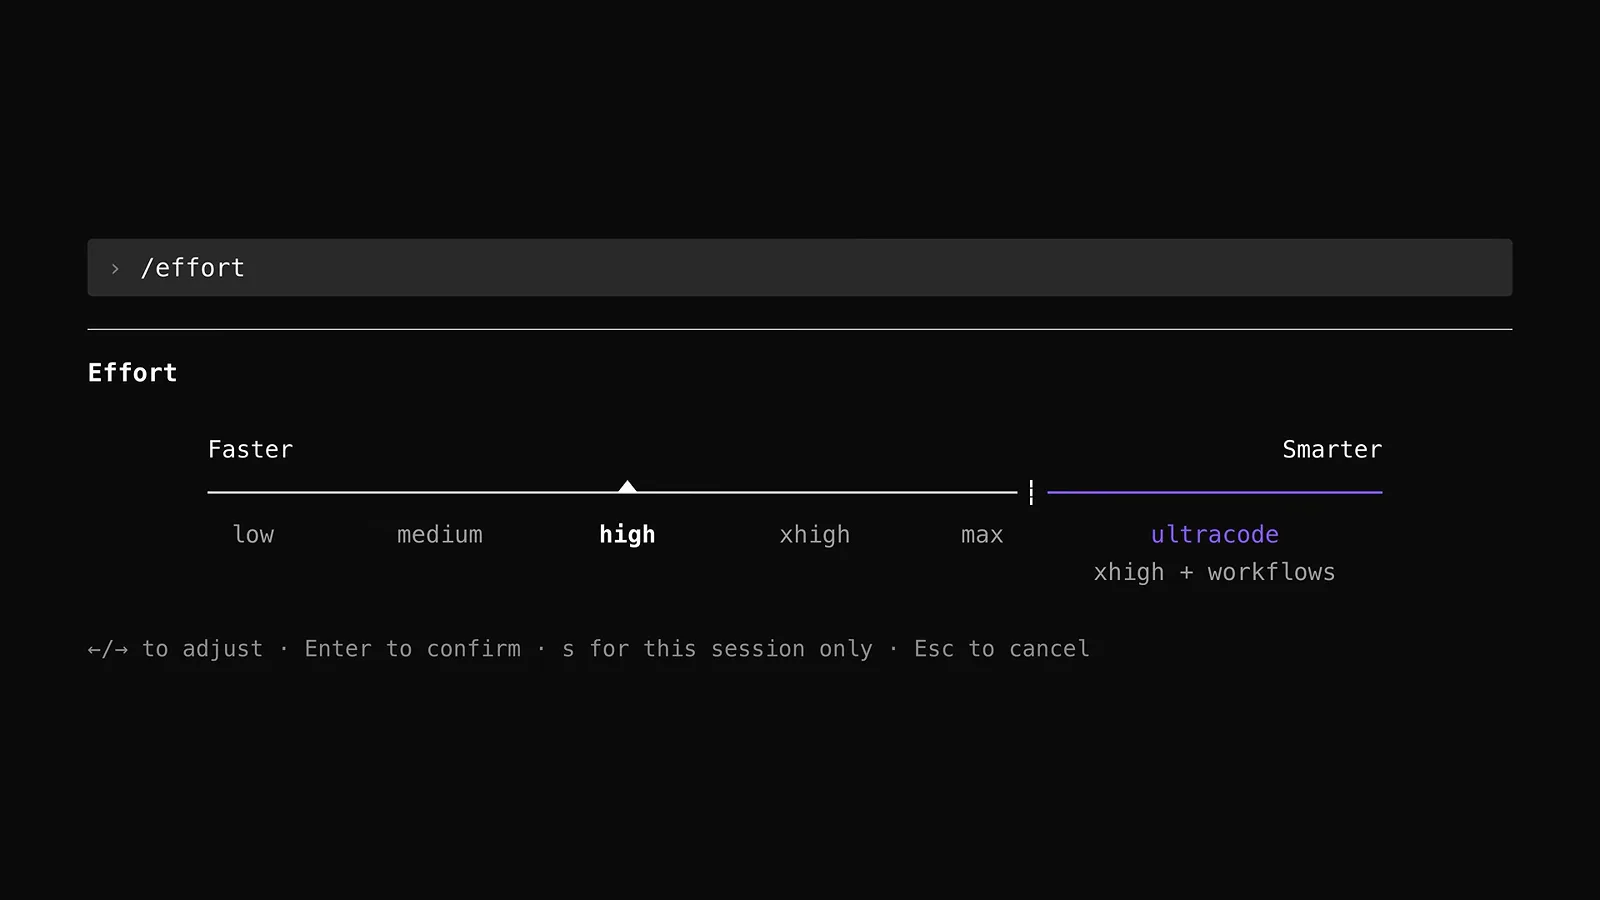
/effort 命令决定 Fable 5.1 想多深、花多少。视频 5:12 处 - 5
开工前先看周额度
在 Claude Code 里运行 /usage,能看到两块表:当前会话与本周全部模型的用量——截图里分别是 62% 和 34%,早上 6 点重置。Fable 5.1 的用量包含在 Max(约每月 100 美元)与 Max 20x 档里,更低的档位很快就会进入按量付费。长任务开工前养成查 /usage 的习惯,Fable 烧周限额的速度远快于 Sonnet。
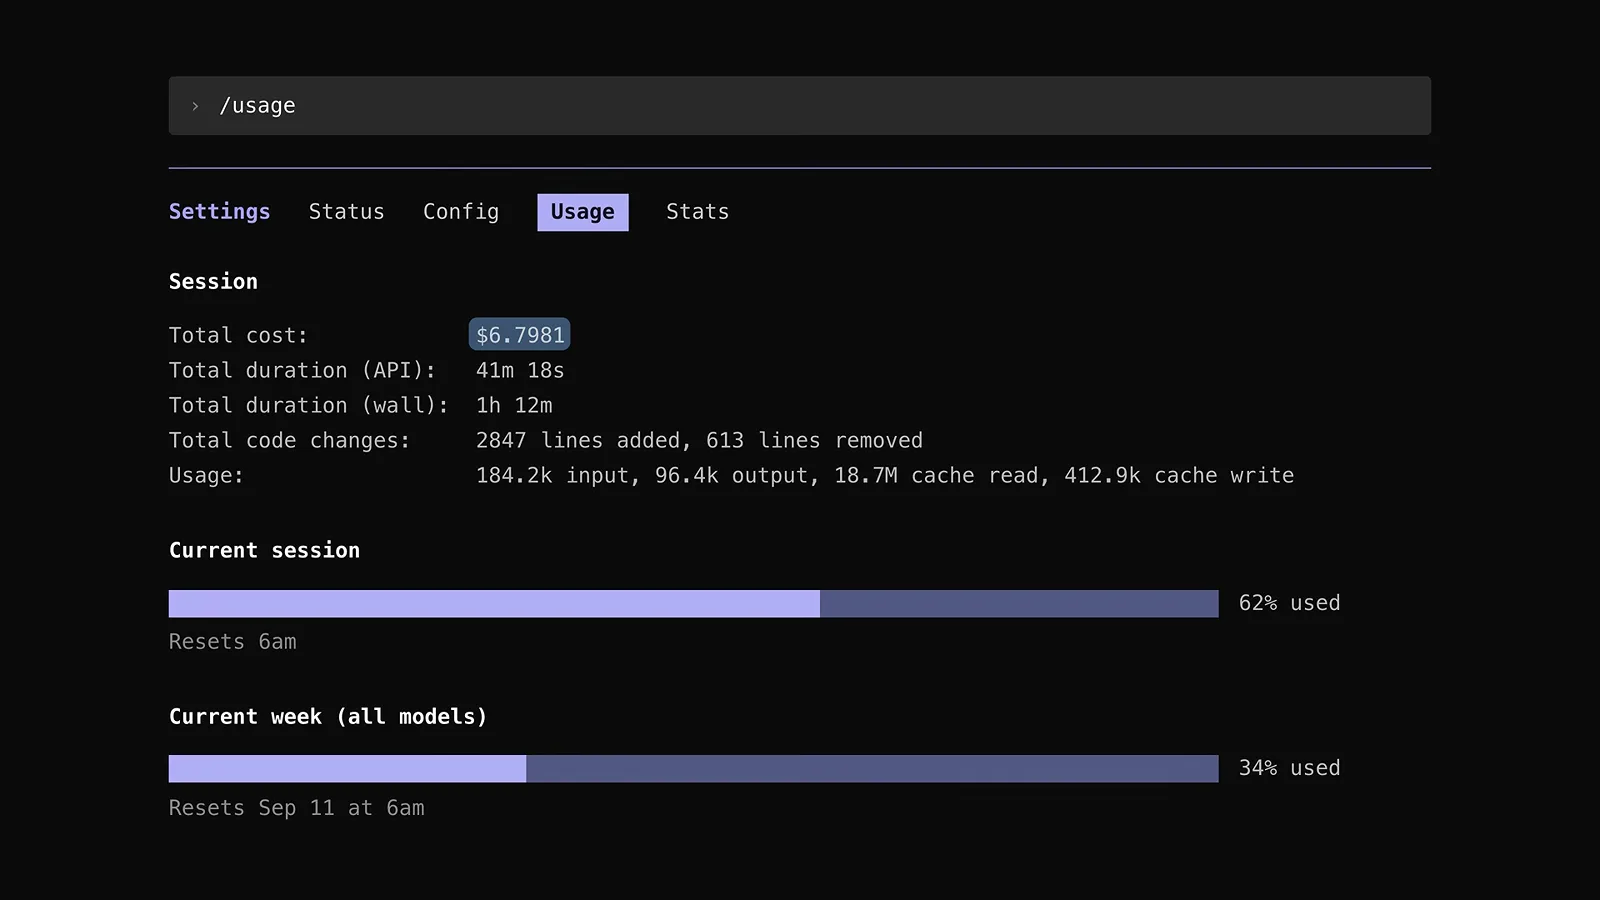
/usage 会报告会话花费、token 数量与会话、周两级用量条。视频 1:45 处 - 6
先算成本,再启动任务
Anthropic 的 Terminal-Bench 4.0 曲线把每个 effort 档的准确率对平均成本作图:low 档以零头价格拿到接近高档的分数。Fable 5.1 的缓存读取比 Fable 5 便宜 75%,按 token 计费的典型负载整体便宜约 25%,高度智能化的会话最多省 45%。在所有成本杠杆里,effort 是你随手就能拉的那一根——先把它拉下来。
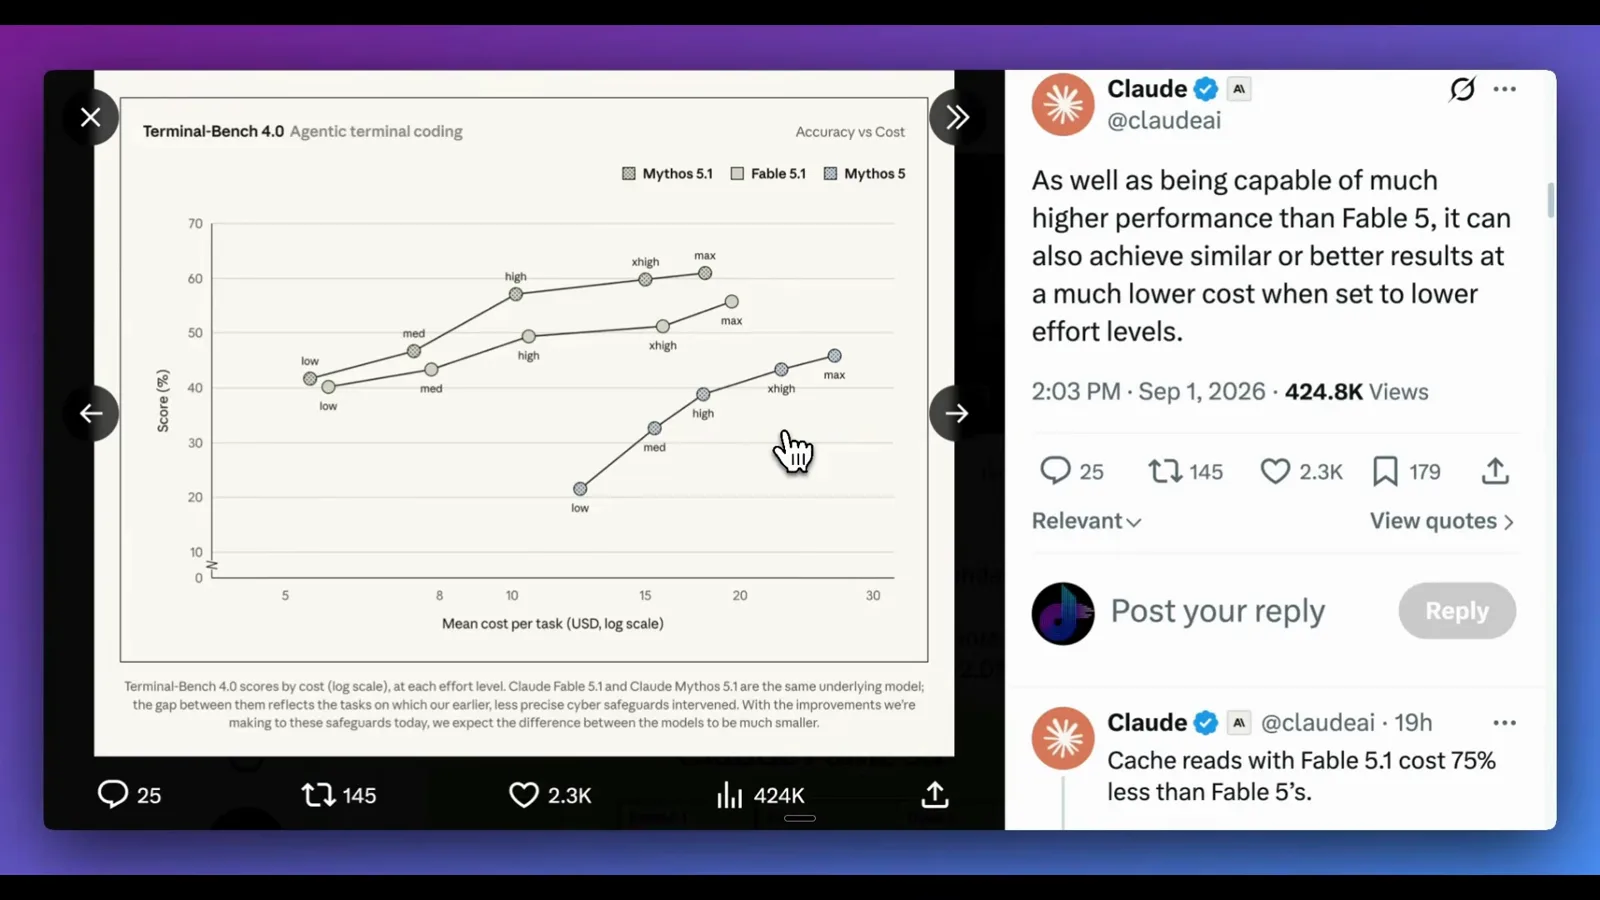
官方准确率—成本曲线,外加缓存读取降价的说明。视频 5:30 处
像交接给资深工程师一样写提示词
- 7
给目标,别给十步计划
最强的 Fable 5.1 提示词读起来像给资深工程师的工作简报:说清结果、约束和“做完长什么样”,然后停笔。Anthropic 官方演示里,一句“扫描登录页找漏洞”就足以让它自主完成安全审查。如果你发现自己在写第十步,把步骤全删掉,只描述目的地。
一句清晰的目标,就够 Fable 5.1 自己规划路径。视频 3:20 处 - 8
把整个功能交出去
把项目切成一条条小指令,只会让你在每一轮都付一遍监督成本,还浪费了 Fable 5.1 最大的优势。AI LABS 观察到它每次长任务都跑到了终点,所以正确姿势是:描述完整功能、列清包含项,让它带着清单自己跑完。任务复杂只意味着耗时更久,不意味着质量下降。
Fable 5.1 会按自己的计划推进,全部勾完才停。视频 5:08 处 - 9
讲清哪些东西不许动
Fable 5.1 热心过头——顺手修个旁边的 bug、扩写一个函数、碰你没点名的文件。AI LABS 在客户项目里就遇到过它擅自改测试文件。提示词里要写明禁区:哪些文件、目录、行为不许动;其他问题发现了先记录、最后汇报,不要顺手修。
范围边界能让 Fable 5.1 不去碰你没列出的文件。视频 9:20 处 - 10
清掉写给旧模型的旧指令
类似“改动前必须先解释”这类规则,是给 Fable 5 时代行为打的补丁,到了 5.1 只会拖累每一条提示。AI LABS 给了个简单检验:把某条指令从 CLAUDE.md 里删掉再跑同类任务,结果没差别就说明它已是死重量。CLAUDE.md 里只留仍然成立的约定。
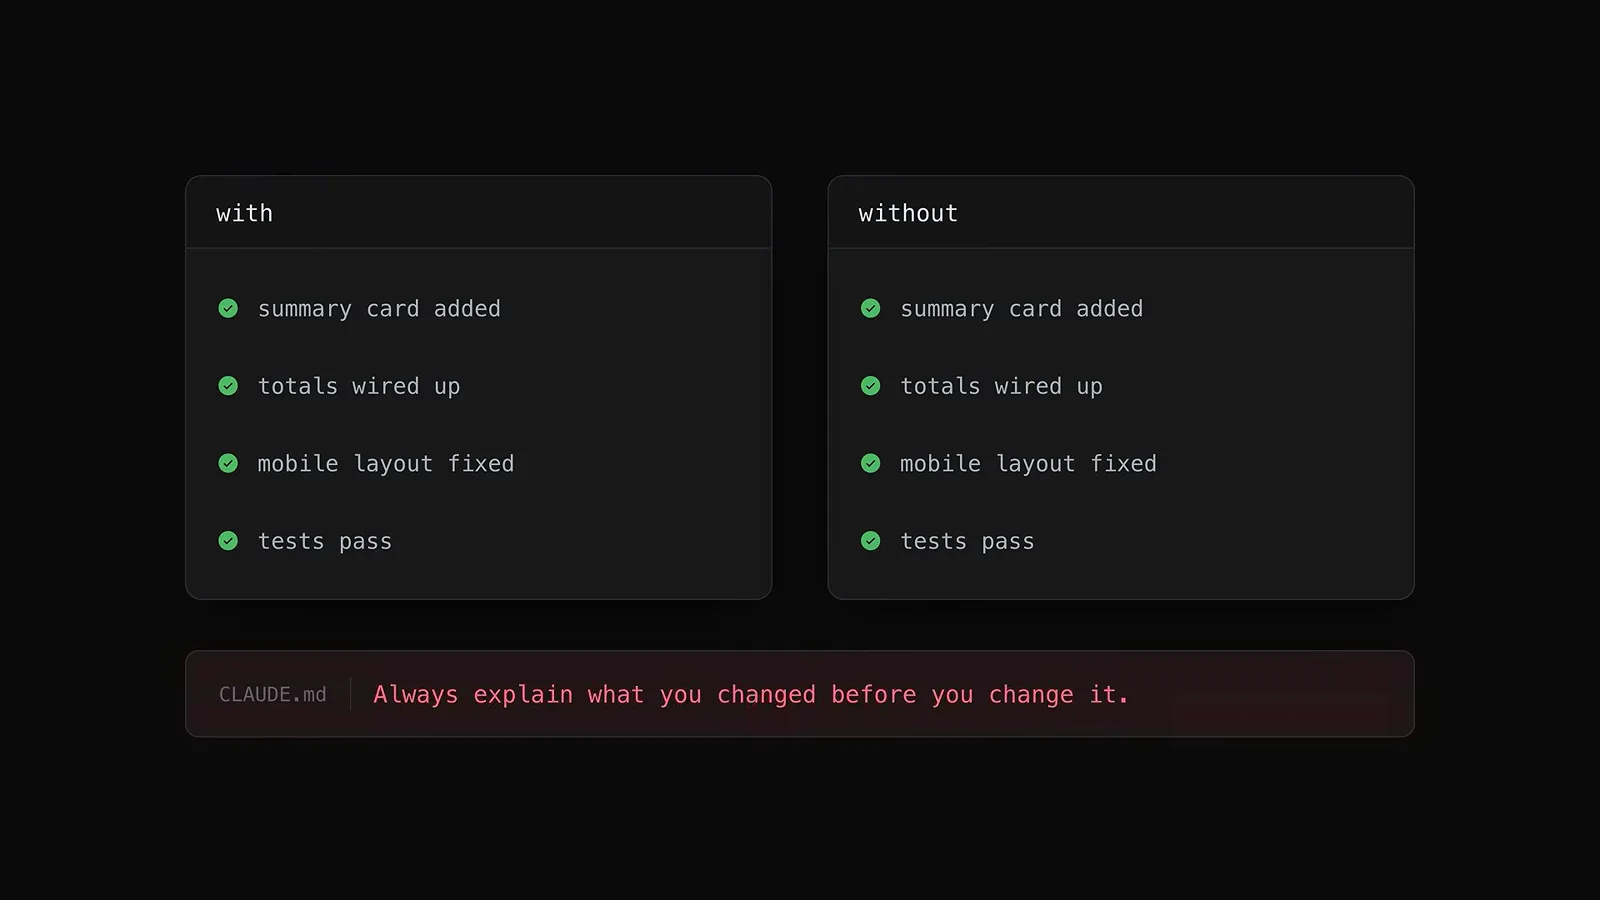
去掉规则结果不变,就说明它过时了。视频 6:40 处 - 11
明令禁止花腔文风
问 Fable 5.1 改了什么,可能得到图中这样的回答——“essentially what you would expect”“on balance the one that made the most sense”。Anthropic 在 5.1 里收敛了这种 Claude 腔,第三方实测也证实有改善,但长篇研究简报仍会飘。往指令里加一句:不许用比喻和套话,只给结论和证据。
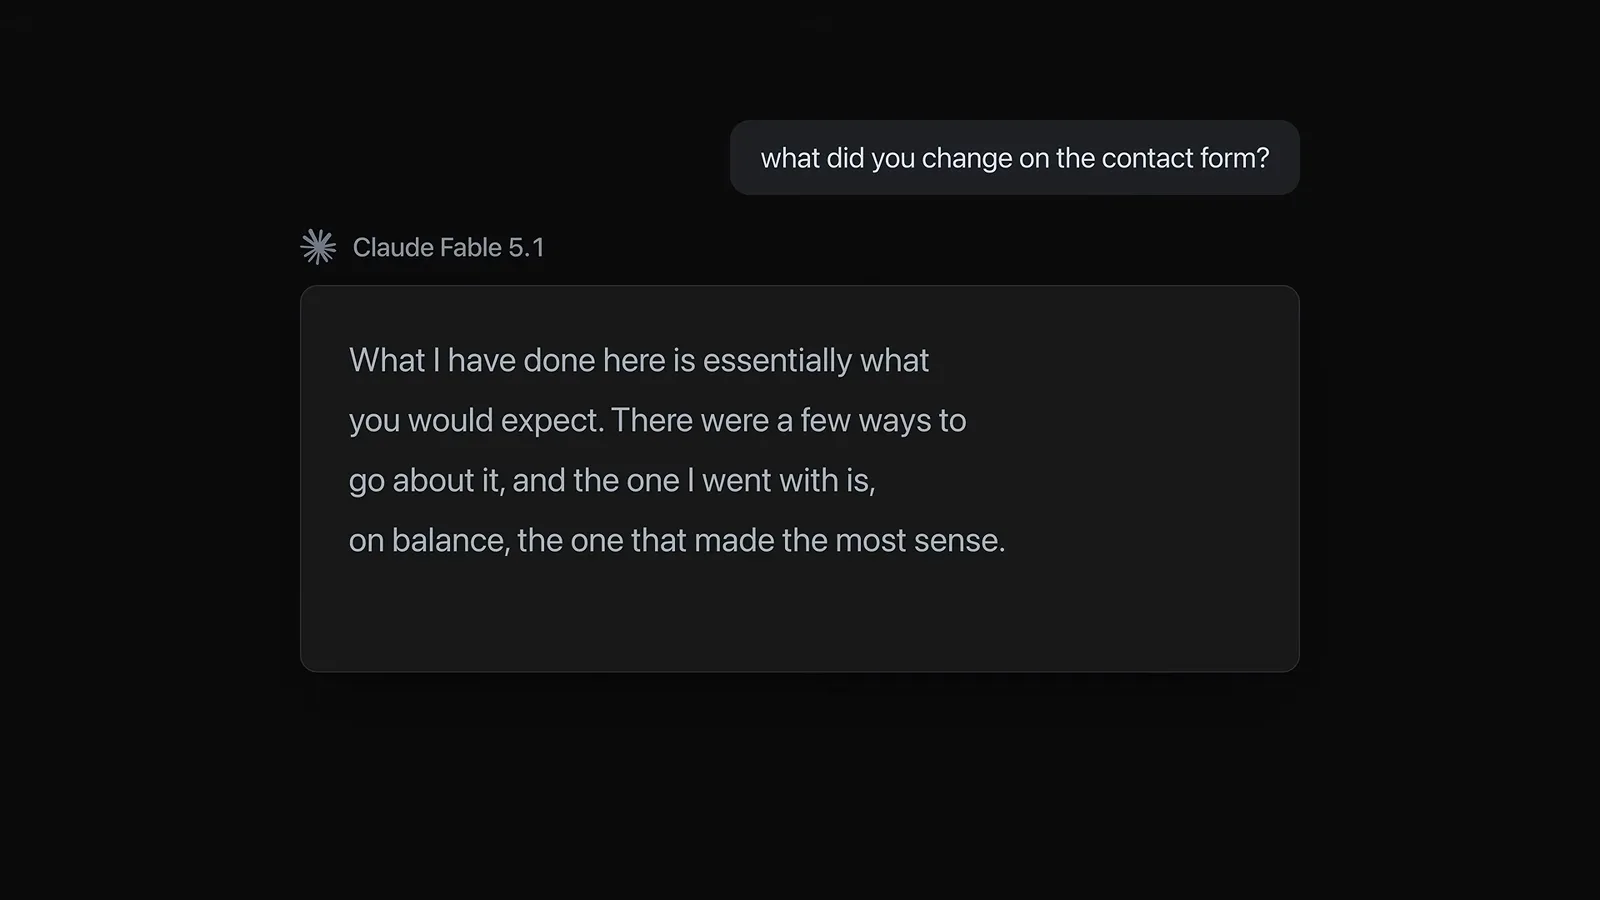
花腔文风在 5.1 里仍有残留,写研究与文案任务时要明令禁止。视频 10:00 处
让长任务自己跑,回来再核验
- 12
长任务成串跑,晚点再回来看
Fable 5.1 为多阶段长程任务而生——调研、构建、测试、迭代一环扣一环,就像图中的任务级联。Anthropic 的提示词指南建议明说“没人在看”:只要步骤可逆,就按请求继续推进,别停下来等确认。然后设一个检查点——一次 commit、一次部署或一份报告——到点再回来,而不是全程盯着。
长程任务正是 Fable 5.1 拉开与 Opus 5 差距的地方。视频 2:00 处 - 13
先信任,再核验——永远如此
第三方评测发现,Fable 5.1 在不知道答案时比 Fable 5 更爱编一个出来,还更少明说“我不确定”。下图的研究任务里,那条统计数字被标红,正是因为模型自己都拿不准。凡是会离开你桌面的数字、引文、出处,都要求它给出来源并亲自核对后再交付。
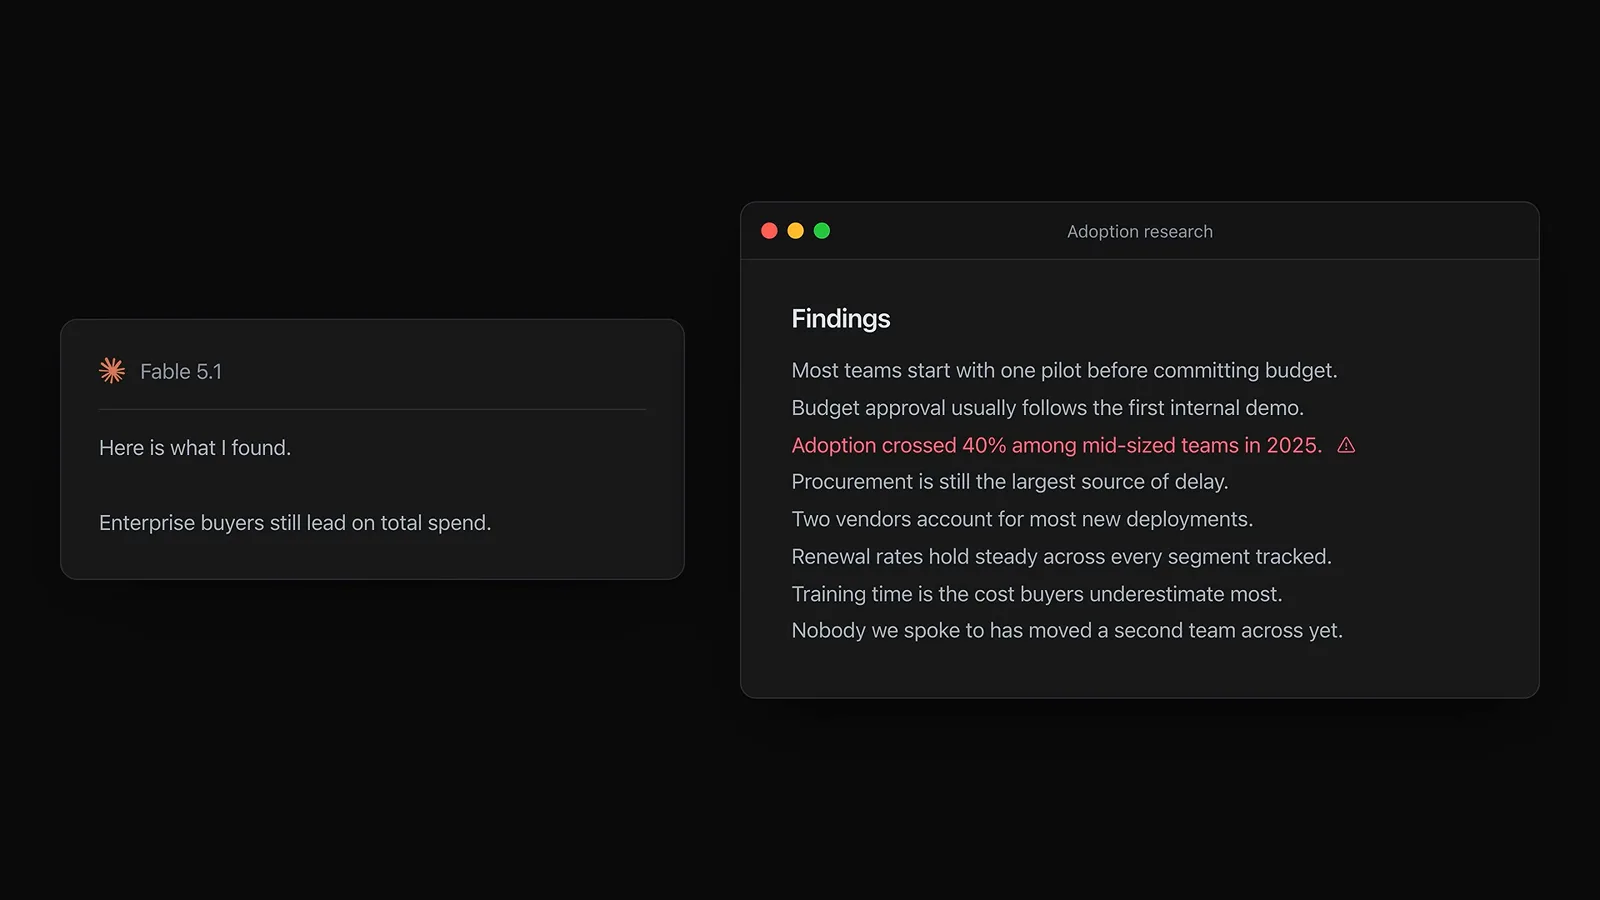
标红是模型自己提示的——没标红的数字也要同样多疑。视频 4:45 处 - 14
只把真正难的任务给它
AI LABS 把同样的任务在 Fable 5 与 Fable 5.1 上各跑多次:最简单的那单 Fable 5 做得更好;最难的那单 Fable 5.1 胜出,还快了约 40%、成本不到一半。规律是通用的——任务越难越长,5.1 的完成率优势越明显;小修小补则几乎感知不到差别。
同样的任务书,难度越高差距越大。视频 4:55 处
只把 Fable 5.1 赢面大的活交给它
- 15
不写代码,也值得用它
5.1 的文风是刻意升级过的:Felix Rieseberg 指出它更少滥用加粗、标题、列表和引号,风格指令也更听话了。这让 Fable 5.1 写研究备忘、文档和评论文章时比前代更省心。把提示词一节里那条“禁止花腔”保留在指令里,它读起来就像同事写的。
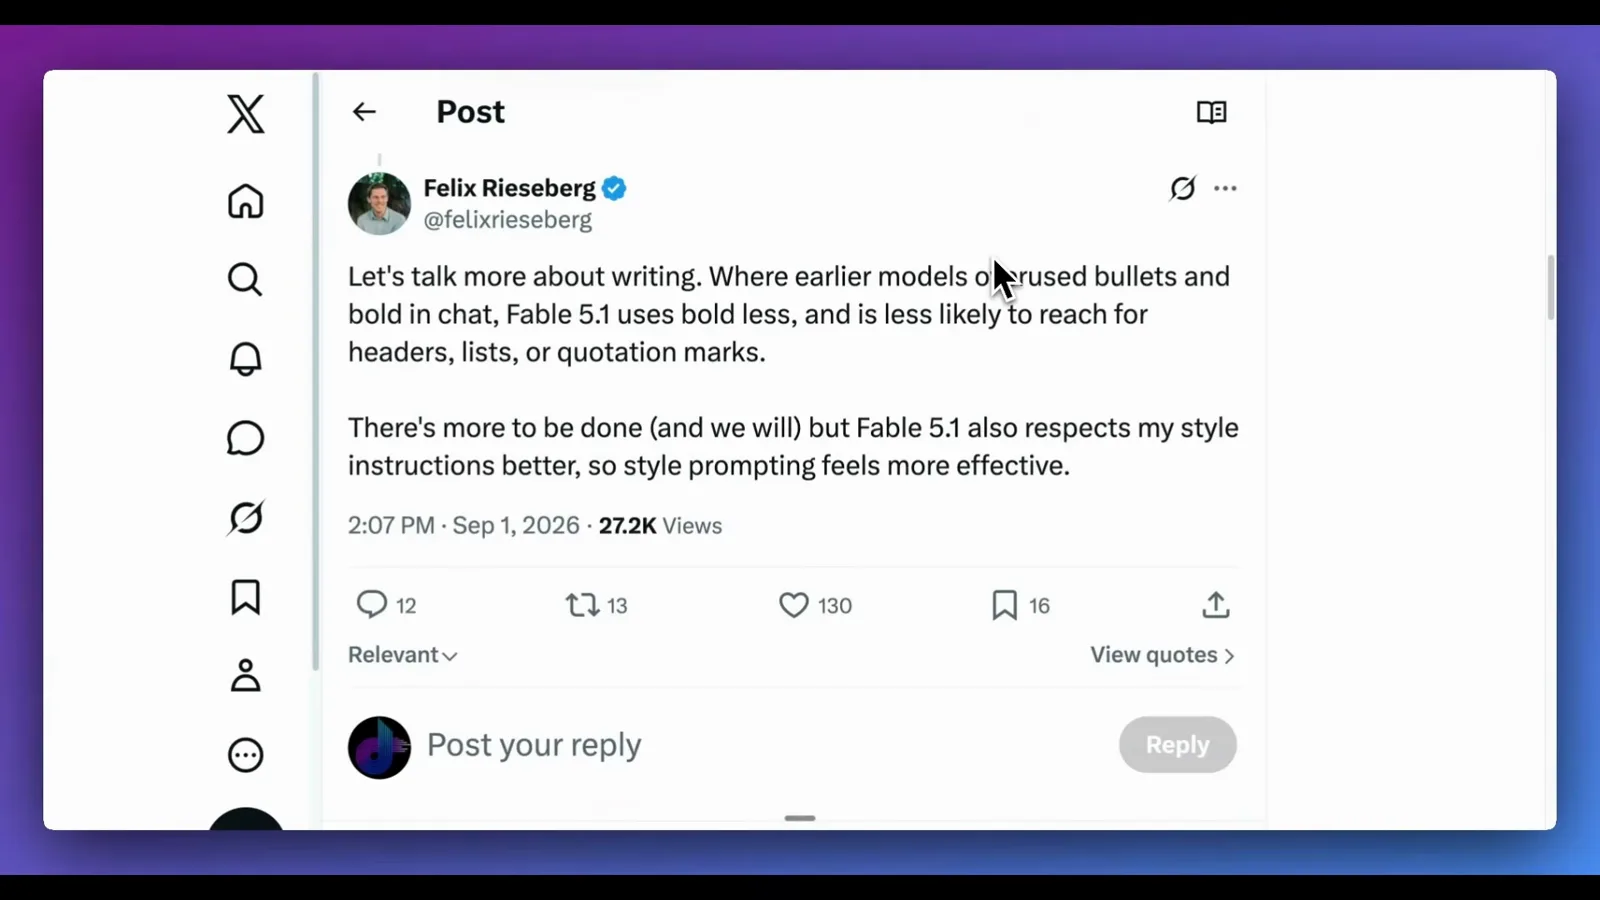
发布周里多位 Anthropic 工程师提到写作能力的提升。视频 7:08 处 - 16
把它指向真实运转的系统
案例最能说明问题:Riley Brown 用 Claude Code 里的 Fable 5.1 做出一个 agent-native 的 Trello 看板——前端、后端、实时数据库齐备,部署在 Vercel 上,Claude、Grok、Codex 等智能体能和人类一起添加卡片与评论。这才是 Fable 5.1 该干的活:环节多、集成重、需要连续自主工作数小时。把预算留给这种形状的项目。
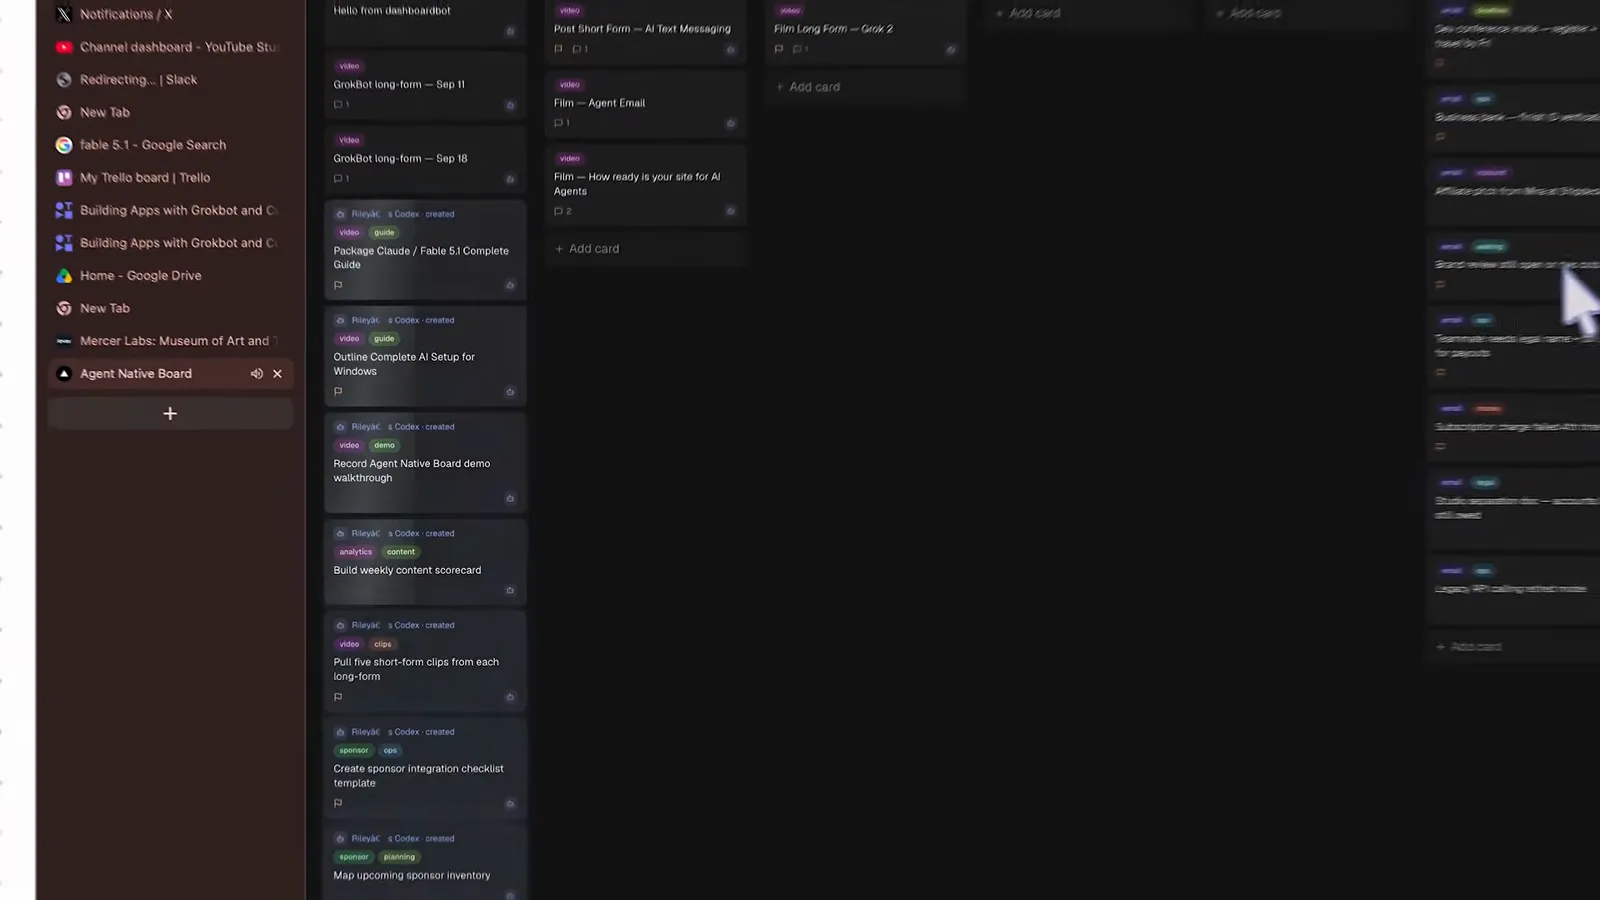
一次会话里跑出来的多智能体实时看板。视频 8:00 处