

GPT-6.1 Sol 对比 Claude Sonnet 5.5:同价双雄的正面对决
Anthropic 在 9 月 28 日发布 Claude Sonnet 5.5,OpenAI 隔天就在 DevDay 甩出 GPT-6.1 Sol——尴尬的是,两款模型都是每百万输入 token 2 美元、输出 10 美元,价签一模一样。OpenAI 的发布对比只提了 Opus,Anthropic 的对比只提了 Sonnet 5,真正值得看的这场对垒,反而没有一家实验室替你测过。这篇攻略用第三方的分档位跑分、双方价目卡和同题实测成品把它拼齐,最后给你一条今天就能套在自己工作负载上的路由规则。
来源与致谢
本教程的截图来自 The Intelligence Desk 的公开演示视频。每个步骤都链接到视频中的对应时间点,方便你对照学习。
The Intelligence Desk ↗两款中档旗舰,前后 24 小时登场
- 1
GPT-6.1 Sol 登场 DevDay:Astra 级的活儿,五分之一的价格
OpenAI 的发布页用一个发光太阳配上一句承诺:在智能体编程、电脑操作和专业工作上逼近 GPT-6 Astra 的智力,标准 token 价格只要 Astra 的五分之一。它于 9 月 29 日上线,距 GPT-6 Sol 发售仅一周,而在它登场前几小时,华尔街日报刚报道更贵的 GPT-6.1 Astra 因安全评估不达标被砍。开发者用 gpt-6.1-sol 调用,入口是 ChatGPT Work 和 Codex,普通 Chat 里还没有。
OpenAI 自己的主视觉:一颗叫 Sol 的太阳,卖着打工人的价。视频 0:00 处 - 2
Sonnet 5.5 前一天就发布了——价格和 Sol 一模一样
Claude Sonnet 5.5 于 9 月 28 日发布,定价与 Sonnet 5 持平:每百万输入 token 2 美元、输出 10 美元、缓存读取 0.20 美元,Anthropic 宣称每任务成本最高比上代低 30%。这意味着它和 GPT-6.1 Sol 的 token 单价完全相同,只有 Opus 5.5(4/20 美元)的一半。Anthropic 官方话术是 Sonnet 5.5 快 30%、大多数工作最高省 30%。而 OpenAI 的发布图表只跟 Opus 较劲,只字未提 Sonnet——这篇页面就是为补上这一课而写的。
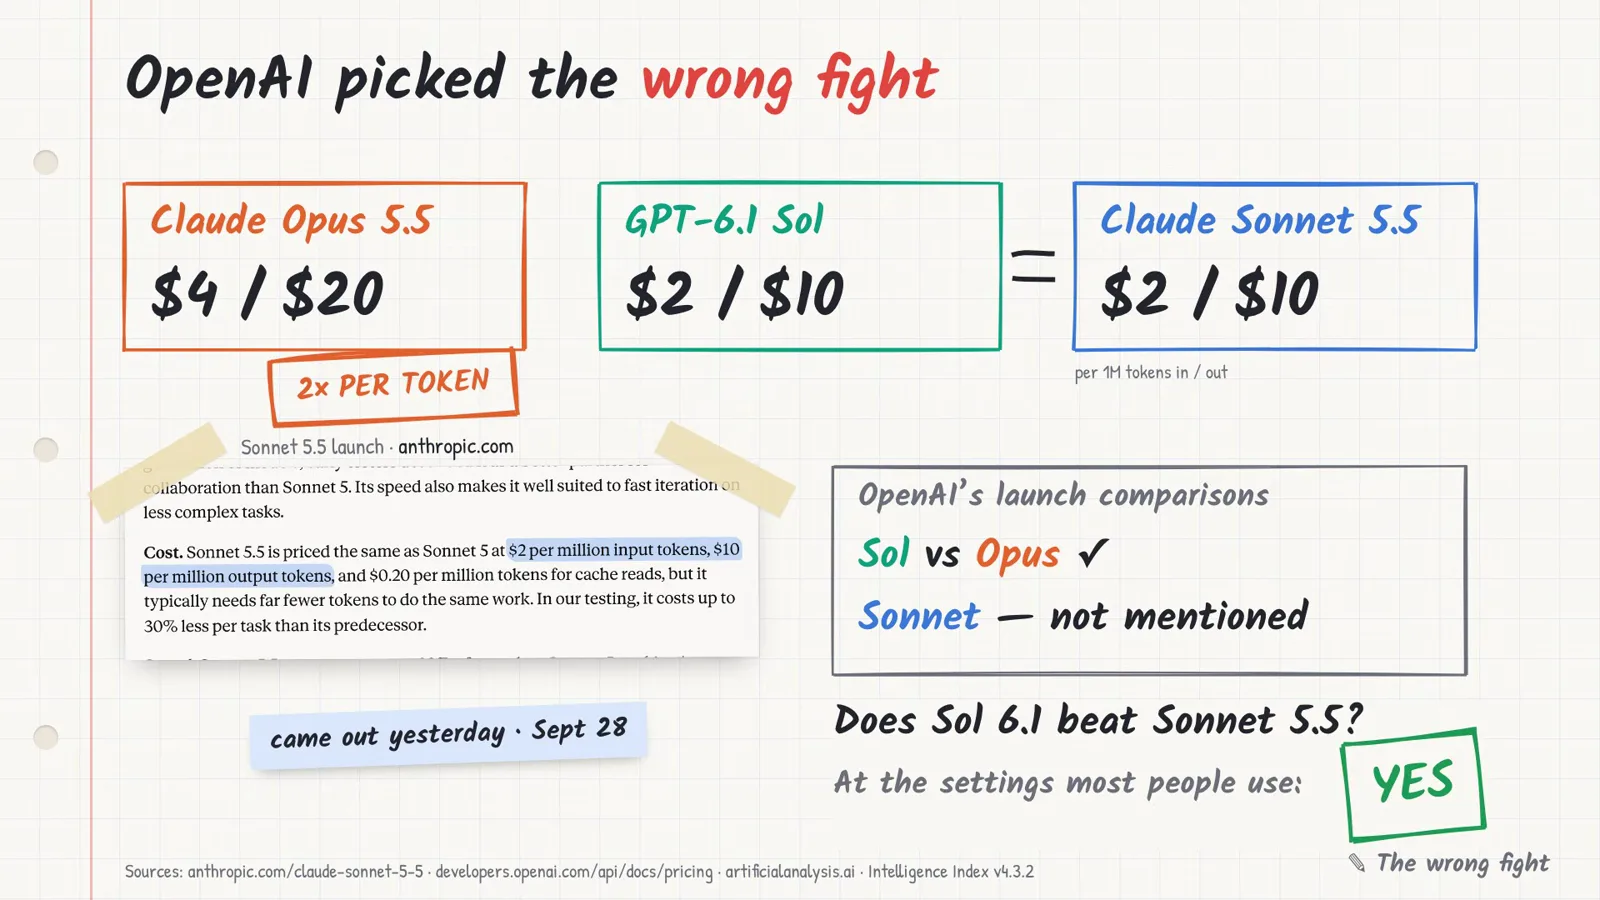
没人排期过的正面相撞:两款 2/10 美元模型,前后一天。视频 4:35 处 - 3
Sol 在 OpenAI 产品线里的位置——以及它瞄准的活儿
OpenAI 官方价目表把 GPT-6.1 Sol 卡在旗舰与廉价档之间:短上下文(输入不超过 272K token)每百万输入 2 美元、缓存输入 0.10 美元、输出 10 美元;长上下文按 4 美元和 15 美元计。Astra 仍是 10/50 美元,Luna 从 0.10/0.50 美元起。Sol 瞄准三件事——智能体编程、电脑操作、办公文档——恰好全是 Sonnet 5.5 的地盘。而 Sonnet 5.5 发布时在 Artificial Analysis 指数上拿了 56 分,比 GPT-6 Astra 的 53 还高 3 分,OpenAI 这台新打工模型显然是带着任务来的。
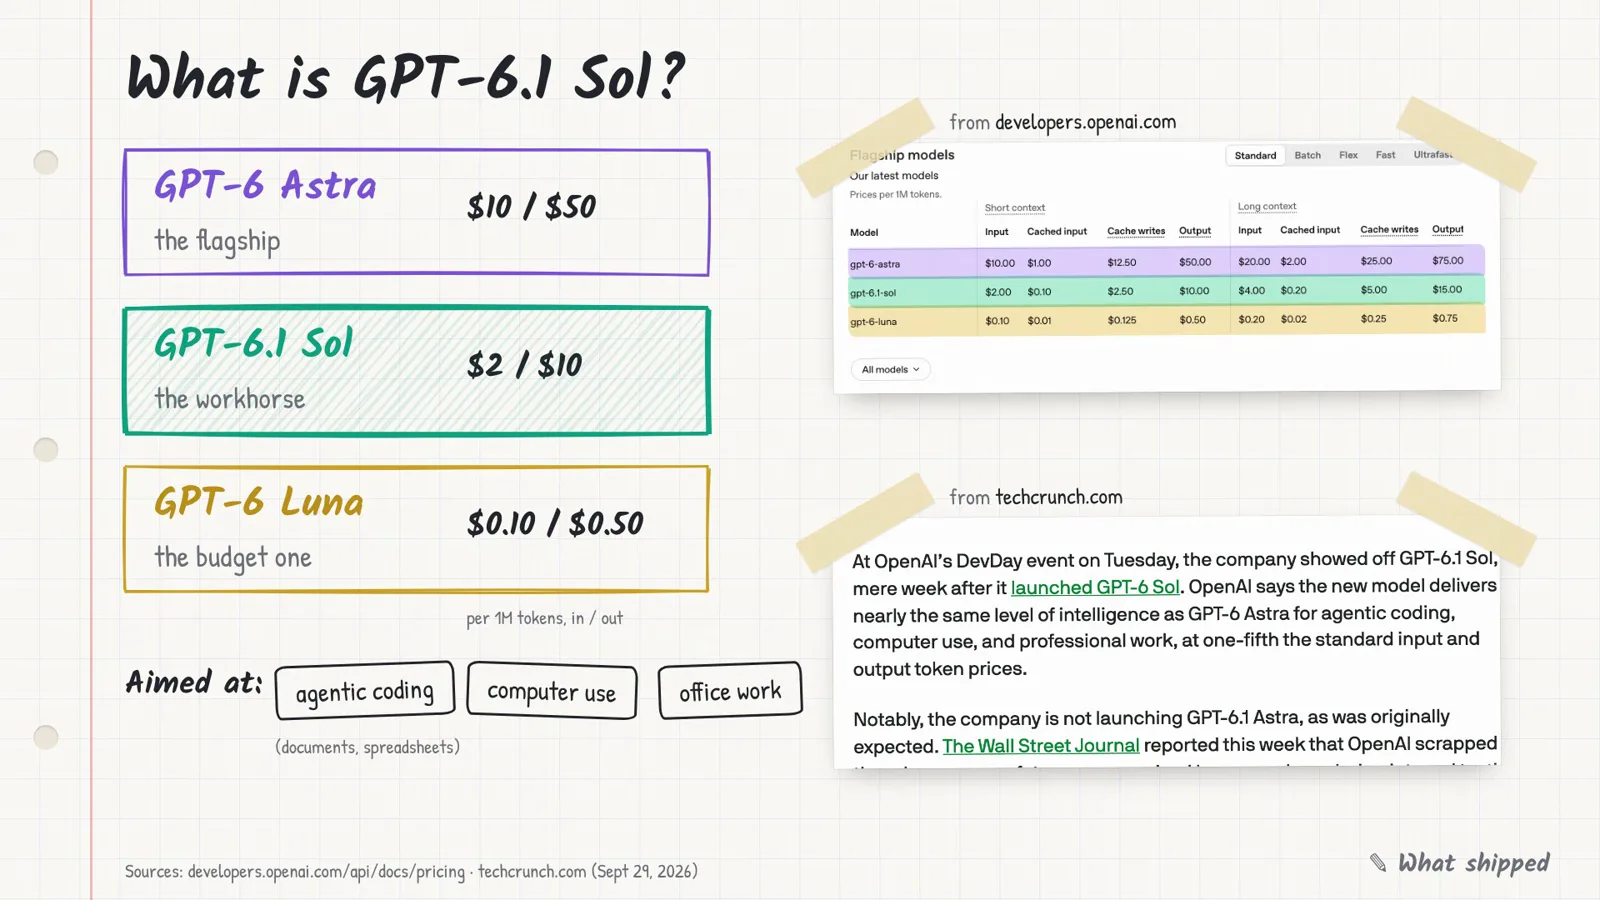
旗舰、主力、入门三张牌——Sol 是中间那张,带着证明自己的任务。视频 1:35 处
价签相同,账单大不同
- 4
token 单价相同——但 Sonnet 出厂档位更保守
每百万 token 两种真是双胞胎:输入 2 美元、输出 10 美元。分数却不是。按 Anthropic 的出厂设置——Claude 应用和 Claude Code 里默认 Medium 档,平台 API 默认 High 档——Artificial Analysis 快照显示 GPT-6.1 Sol 全部领先:Medium 档 48 比 41,High 档 50 比 47,连 Sol 的 Low 档(42)都赢 Sonnet 的 Low 档(36)。只有把 Sonnet 推到出厂之外的 Xhigh(52)和 Max(56),它才翻越 Sol 的 51、52 顶棚。
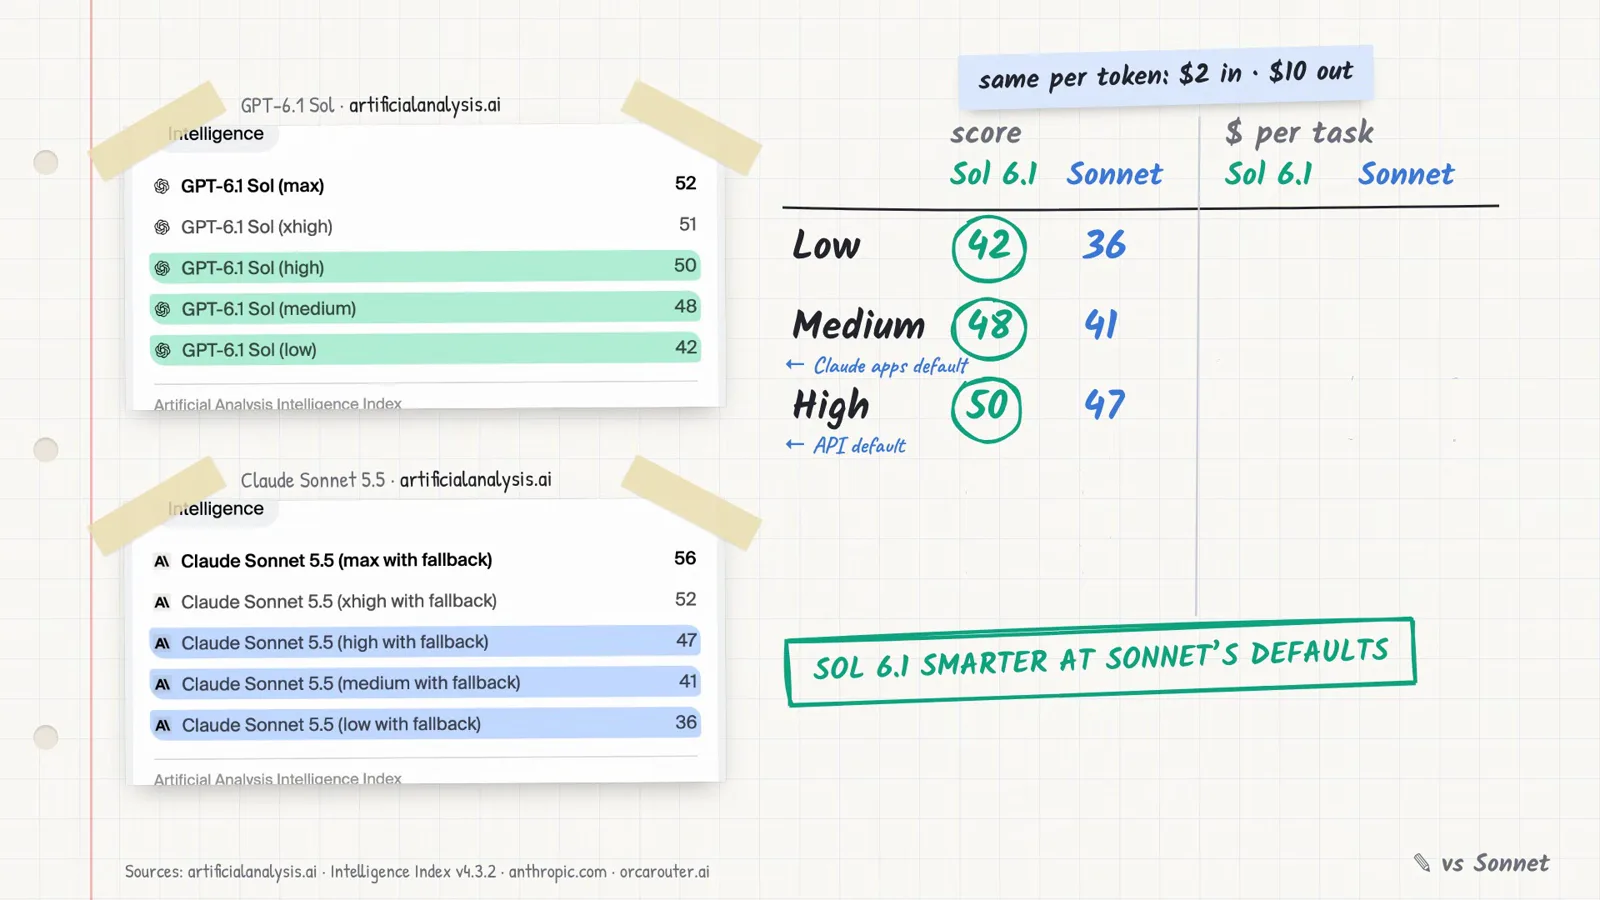
价格是双胞胎,出厂档位不是——多数人实际使用的区间里 Sol 占优。视频 5:30 处 - 5
账单:同样的活儿,Sol 只收约三分之一的钱
token 单价相同,发票却天差地别,原因是 Sonnet 5.5 话痨得多:跑完整套指数它写了 4.10 亿输出 token,Sol 只要 6700 万——折合每任务约 19.3 万对 3.1 万,同样的 10 美元单价,token 量是 6 倍。落到账上:Medium 档每任务 0.21 美元对 0.59 美元,High 档 0.32 美元对 1.08 美元——分更高还只收约三分之一。智能体循环里缓存输入再拉开一截:Sol 每百万收 0.10 美元,Sonnet 收 0.20 美元。
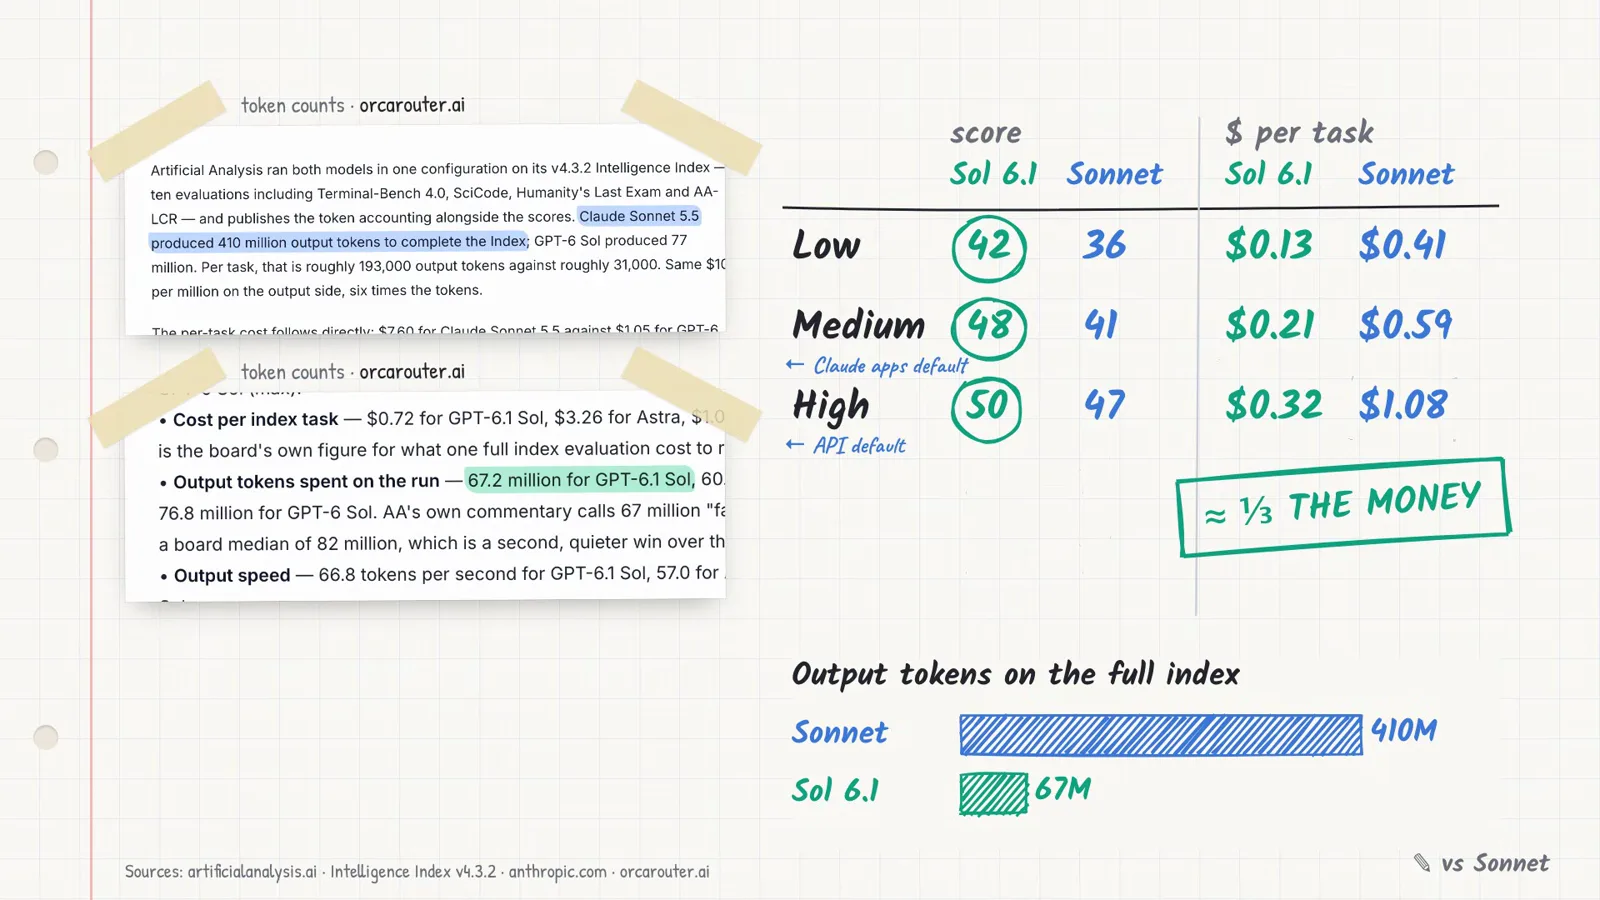
同一张价目表,三分之一的账单——话痨程度就是全部差额。视频 6:05 处 - 6
把两台旋钮都拧到 Max,Sonnet 反超——代价是 10 倍价钱
把两款模型都推过出厂档位,局面就反转。Xhigh 档 Sonnet 以 52 比 51 险胜 1 分,每任务成本却跳到 2.74 美元对 0.39 美元;Max 档 Sonnet 赢 4 分(56 对 52),7.60 美元对 0.72 美元——每任务约十倍价钱。如果你真需要 56 分这个级别,注意图表上的第三张牌:Opus 5.5 在 Xhigh 档就能到 56,每任务约 3.50 美元,不到 Sonnet Max 账单的一半。
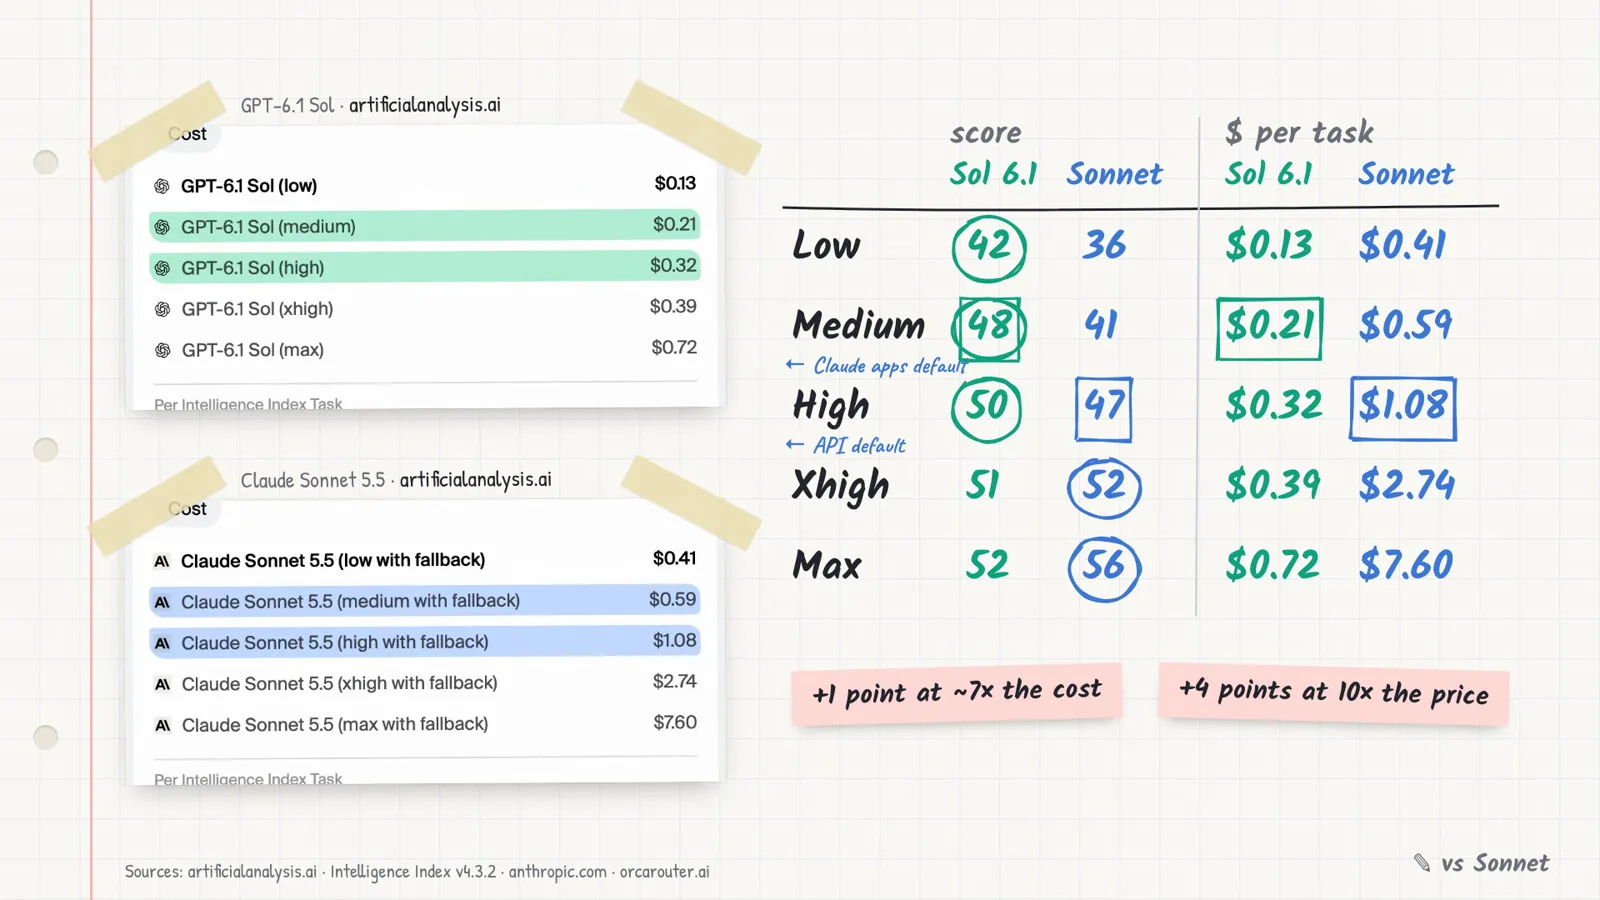
Sonnet 的反超是真的——每任务的成本也是真的,约十倍。视频 7:05 处
档位旋钮决定一切
- 7
一张图说完整场对决:Max 档 56 对 52
整场对决被压缩在这一页里。最高档位上,Artificial Analysis 指数给 Sonnet 5.5 打 56 分、Sol 打 52 分——但 Sonnet 的 Max 档每任务要 7.60 美元,Sol 只要 0.72 美元,贵约十倍。可要是让 Sonnet 待在它的常规档位,GPT-6.1 Sol 就同时做到更聪明、更便宜。这页剩下的内容全是围绕这笔交易展开的细节:你买的要么是 Sonnet 的上限,要么是 Sol 的日常性价比。
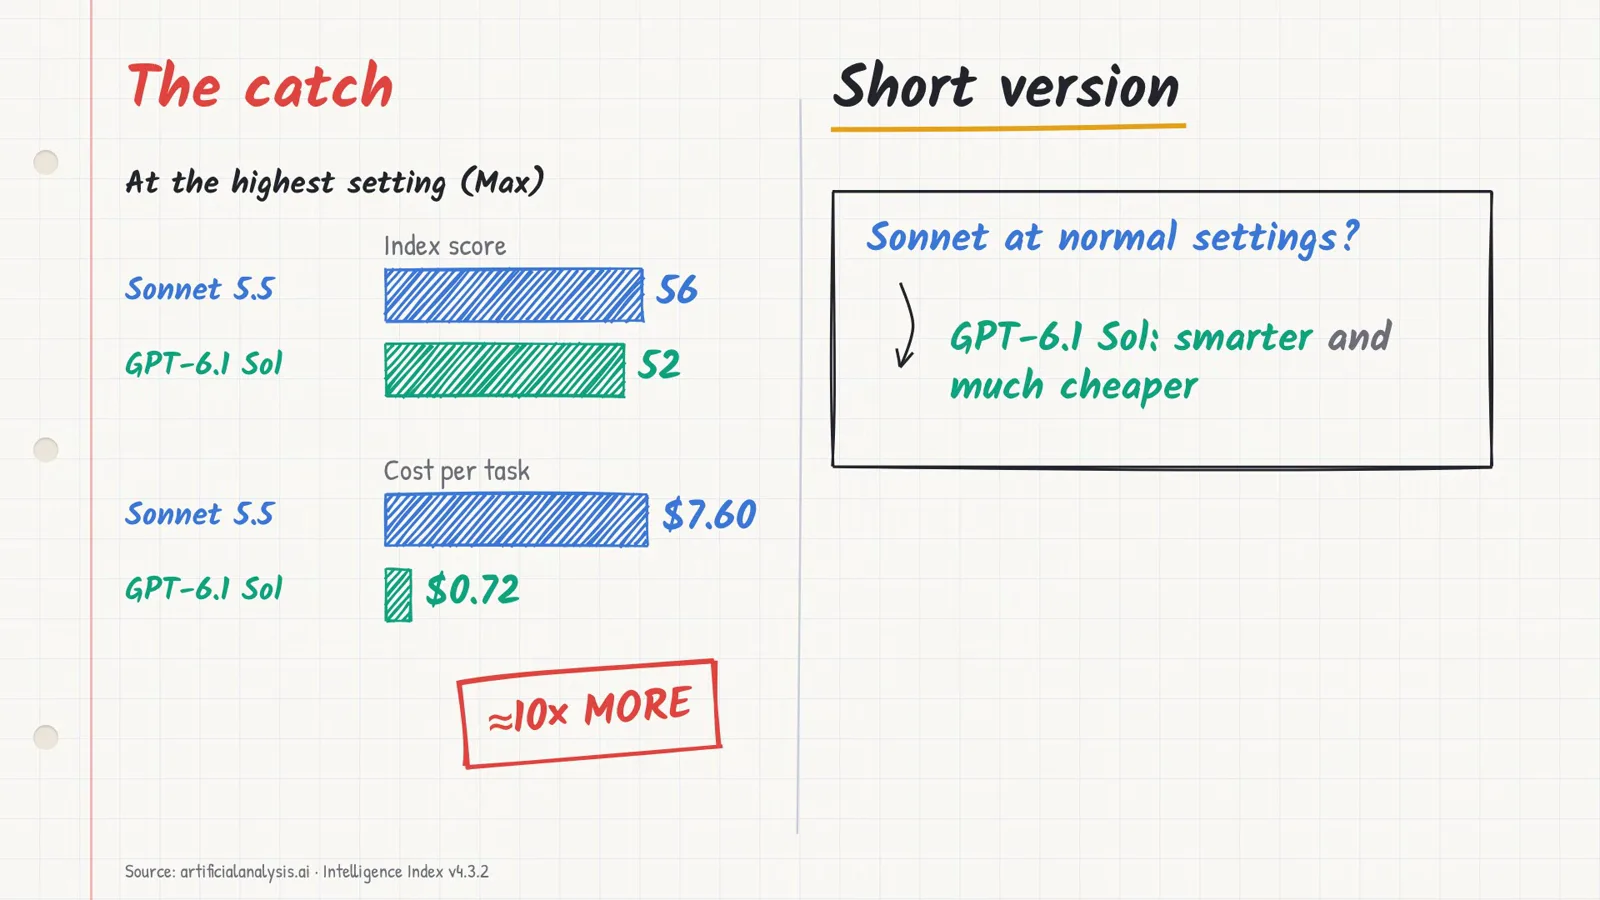
一张条形图就是全部争论:Sonnet 的上限对 Sol 的价格。视频 0:45 处 - 8
诚实解读 OpenAI 的发布数字:Opus 仍是天花板
对着 Anthropic 旗舰打,Sol 赢不了——Opus 5.5 在每个档位都持平或更高(58/56/54/51/42 对 52/51/50/48/42)。但 OpenAI 自家发布卡也摘下了几项实打实的战果:DeepSWE v1.1 在 High 档拿到 75.2%,比 GPT-6 Astra 的 74.1% 高 1.1 分;OSWorld 2.0 电脑操作 71.4%、每任务 1.27 美元,Astra 要 9.44 美元;GDP.pdf 拿 32.0%,压过 Opus 5.5 的 28.8%;AutomationBench 在 Medium 档领先 Opus(31.7% 对 29.5%),Max 档则落后。上下文为 105 万 token,输出上限 12.8 万。
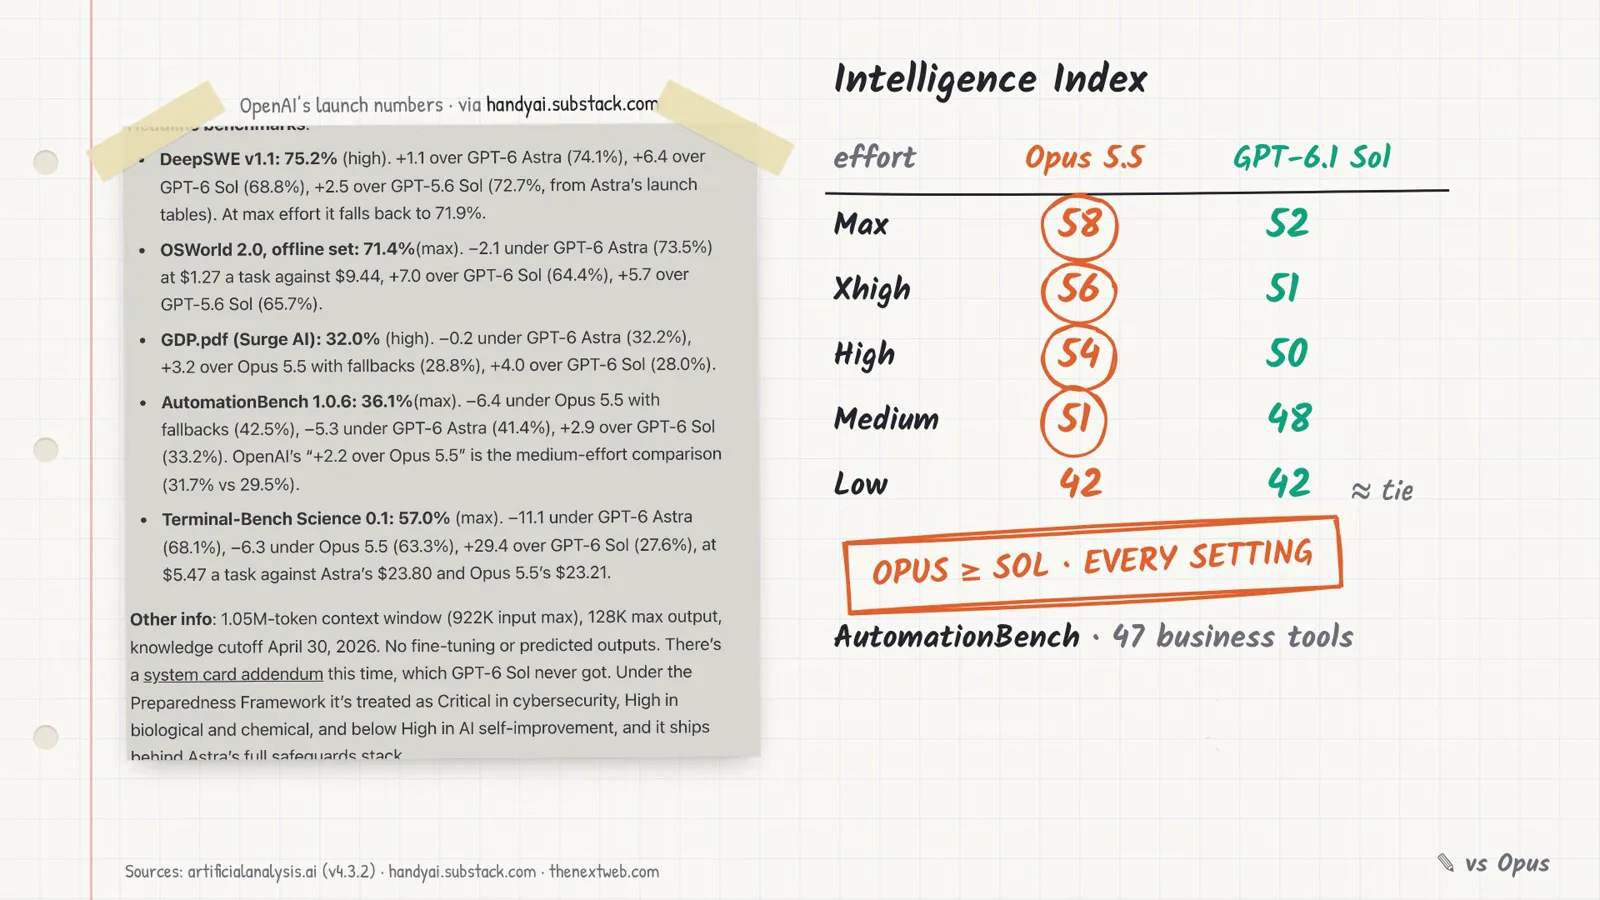
比起 Opus 是笔好买卖——但天花板无论怎么比都在 Anthropic 手里。视频 3:30 处 - 9
公平地说:Sol 的最高档,用一半的钱压过 Opus 的中档
读这张梯队图最公平的方式:Sol 在 Max 档拿 52 分、每任务 0.72 美元;Opus 在它的默认 Medium 档拿 51 分、每任务 1.34 美元——分略高,钱省一半。一项科学终端测试里,OpenAI 的数字是 Sol 每任务 5.47 美元,Opus 5.5 在 Max 档要 23.21 美元。页面上的两个图章说得直白:划算至极,但不是 Opus 杀手。对本页而言结论更简单——Sonnet 5.5 正处在这条中间地带,而 Sol 给这个地带定了个凶狠的价。
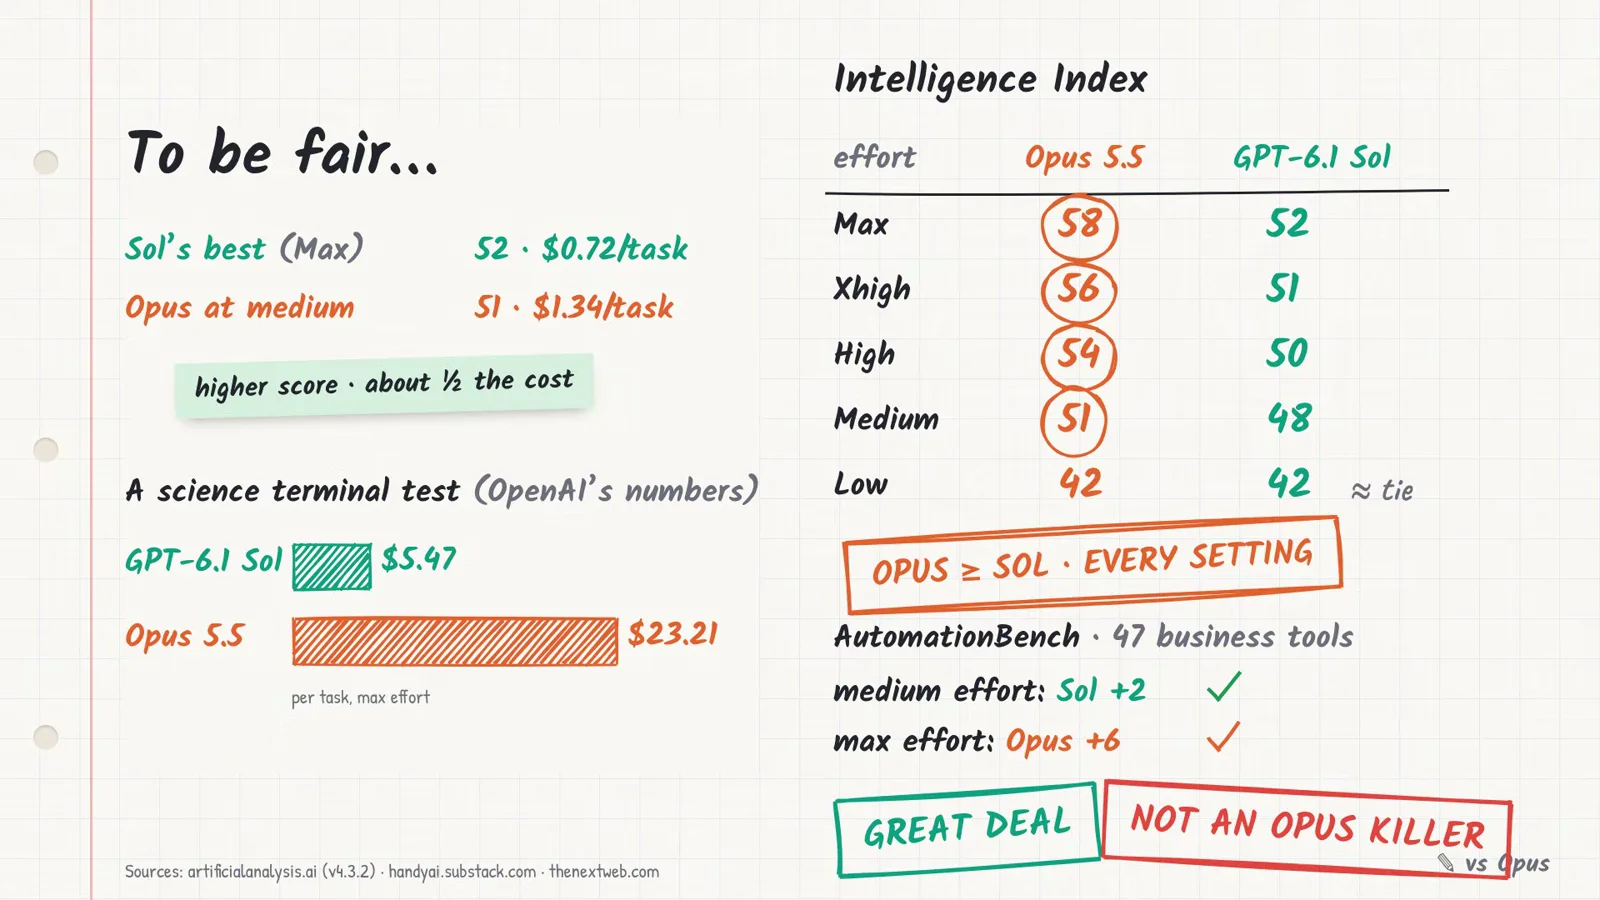
Sol 的上限与 Opus 的下限重叠,花的钱却只有零头。视频 4:05 处
同一道题,两款模型:真实成品对比
- 10
实测环境:同一套题、同一个测试台、两款模型
跑分帮你进候选名单,成品才帮你签单。AIex 的 AI Workbench 用同一个本地测试台跑了两款模型——Sonnet 走 claude-code 运行器,Sol 走 codex-cli 运行器,各用各的订阅——由大模型裁判打功能分和视觉分。他的控制台显示两家咬得多紧:GPT-6.1 Sol 加权 5.7/10,Claude Sonnet 5.5 加权 5.6/10。注意他写在屏幕上的提醒:分数不能一对一硬比,因为每个 Sol 任务抽样五次,对应 Sonnet 的一次。
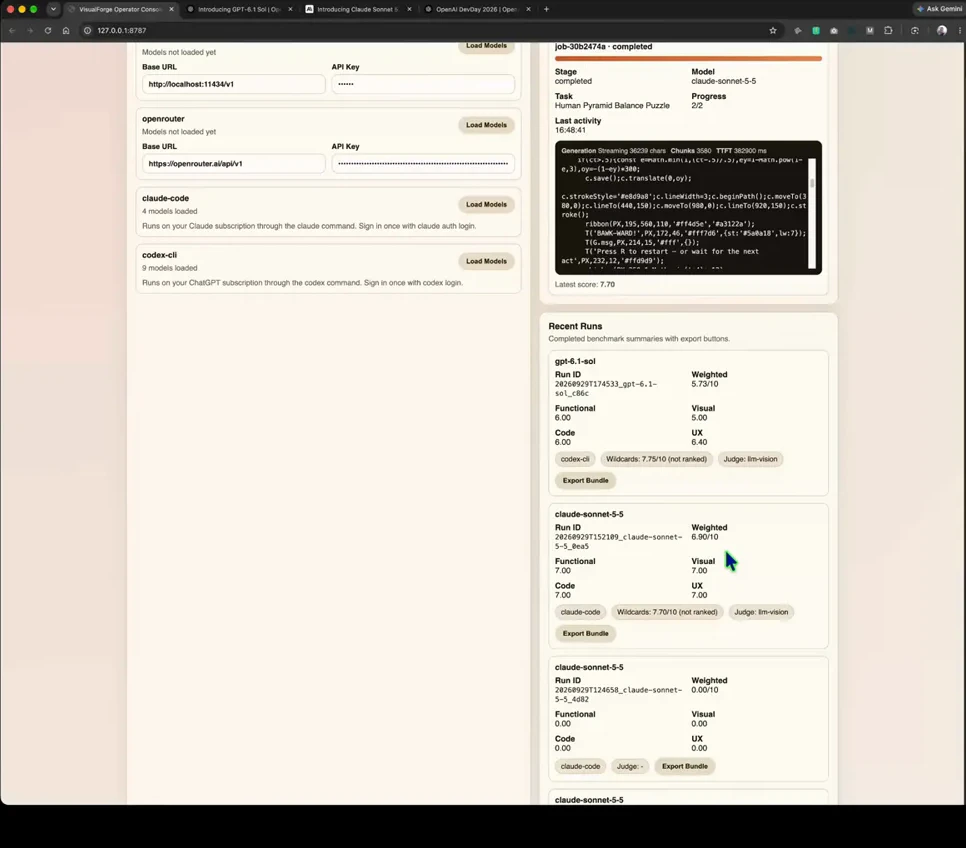
一个土制竞技场:同一测试台、两份订阅、几乎持平的均分。视频 1:20 处 - 11
成品实测:Sol 的 VANTA 风洞配置器
拿到同一道 3D 产品页题目,GPT-6.1 Sol 交出了这座 VANTA 展厅:银色跑车停在暗色风洞内的转台上,背后是一整面涡轮墙,底部还有一块带风阻与下压力读数的仪表面板,数字实时跳动。地址栏标着 model=gpt-6.1-sol。这是两个版本里更有电影感的一个——克制的配色、live 仪表代替装饰。
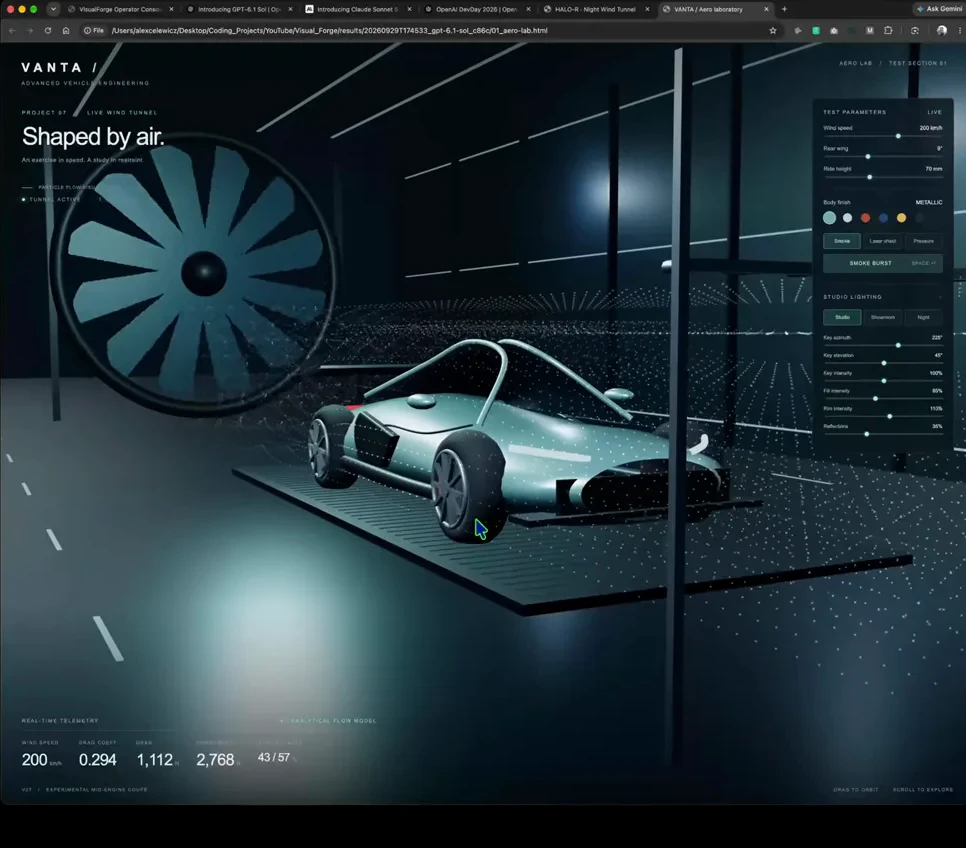
Sol 对同一道题的回答:黑暗、电影感、带仪表。视频 1:50 处 - 12
成品实测:Sonnet 的海岛飞行小游戏
飞行游戏题目下,Claude Sonnet 5.5 交付了一款能玩的横版小游戏——双翼机掠过棕榈海岛,座舱里有风力表,空中飘着可拾取的道具,底部一条实时遥测栏。地址栏标着 model=claude-sonnet-5.5。它能跑、有动画,物理手感像调过参而不是随机生成——正是 Sonnet 招牌的前端打磨功夫。
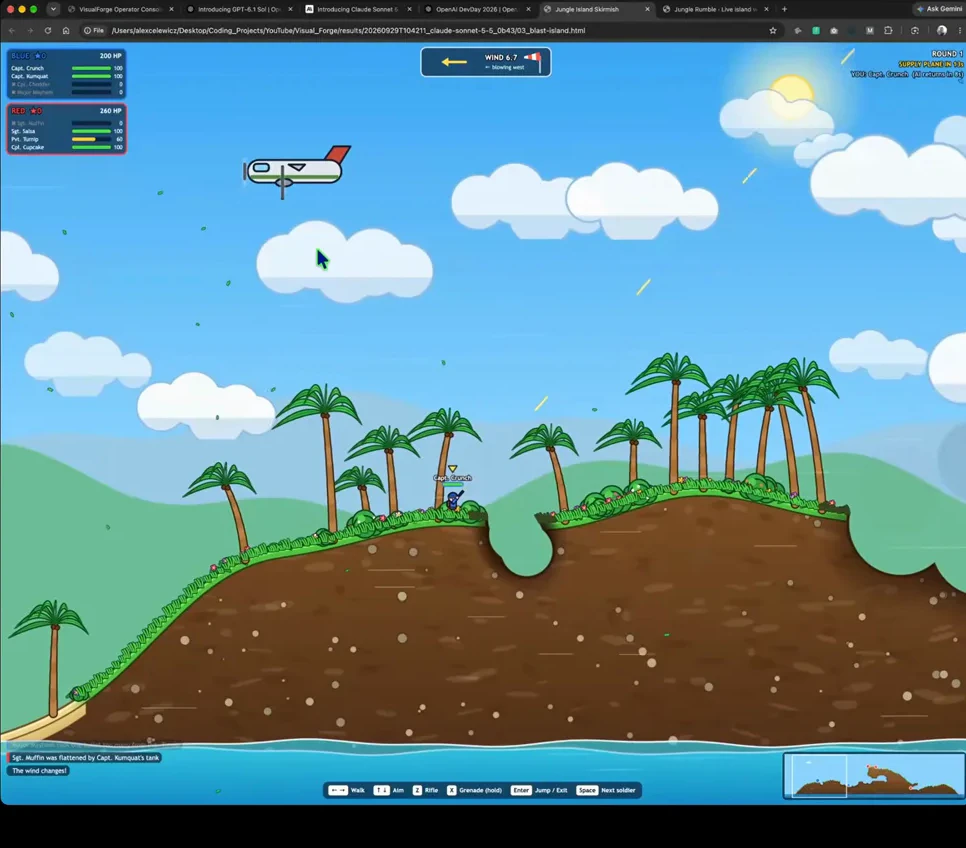
Sonnet 的答卷:上手即玩,调校细腻,色彩明快。视频 4:00 处 - 13
创意实测:Sonnet 的嘉年华接杂技演员游戏
开放式创意题里,Sonnet 5.5 做了一座嘉年华射击棚:你用跷跷板接住空中的杂技演员——LEVEL 2 横幅、3600 分、16 个接住 13 个、等待区卡片分重量级与中量级、还有自动演示模式和物理倾斜仪。地址栏确认是 model=claude-sonnet-5.5。它很懂游戏设计——计分、失败条件、风味文本一应俱全,正是 Sonnet 稳定输出的那种成套互动。
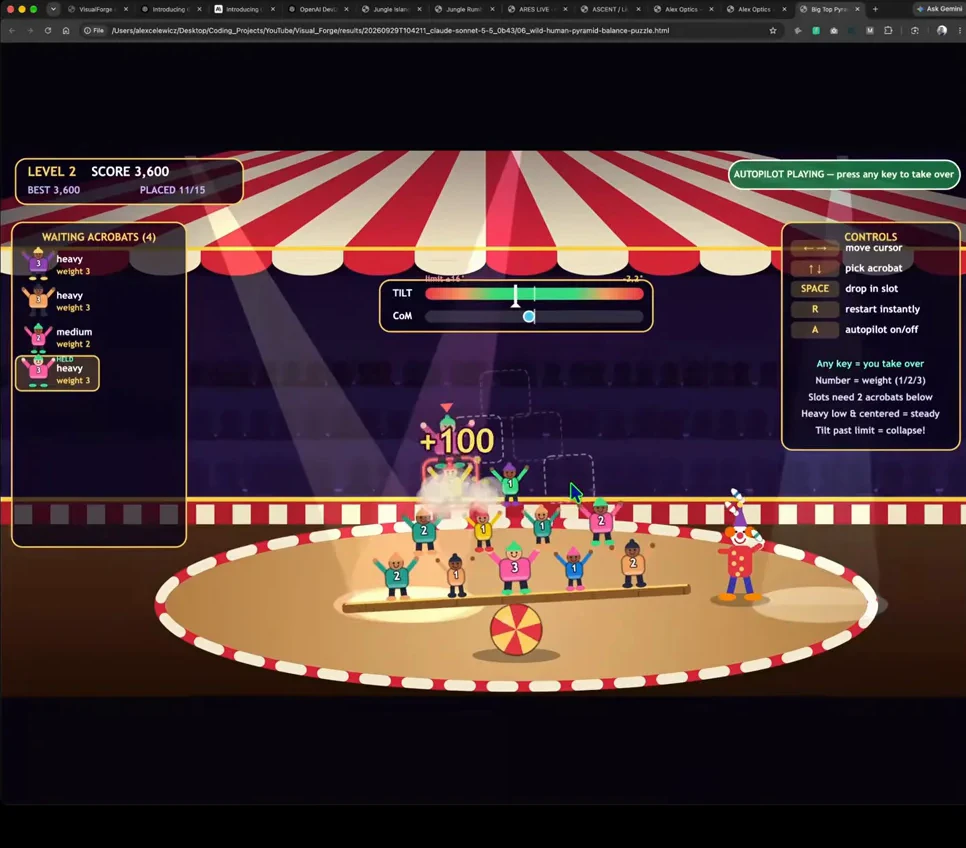
关卡、计分、自动演示、物理——Sonnet 交付的是一整个游戏循环。视频 6:00 处 - 14
创意实测:Sol 的 Wind/Weft 帆船设计工坊
同一道创意题,GPT-6.1 Sol 走去了更怪、更艺术指导化的方向:Wind/Weft,一间帆具设计工作室——彩色线程汇聚成一张面孔,旁边是带张力读数和实时模式的风之主权面板。地址栏标着 model=gpt-6.1-sol。Sonnet 做了游戏,Sol 做了氛围——交互更少,识别度更强,属于你会拿去给客户看、用来论证模型有品味的那种产出。
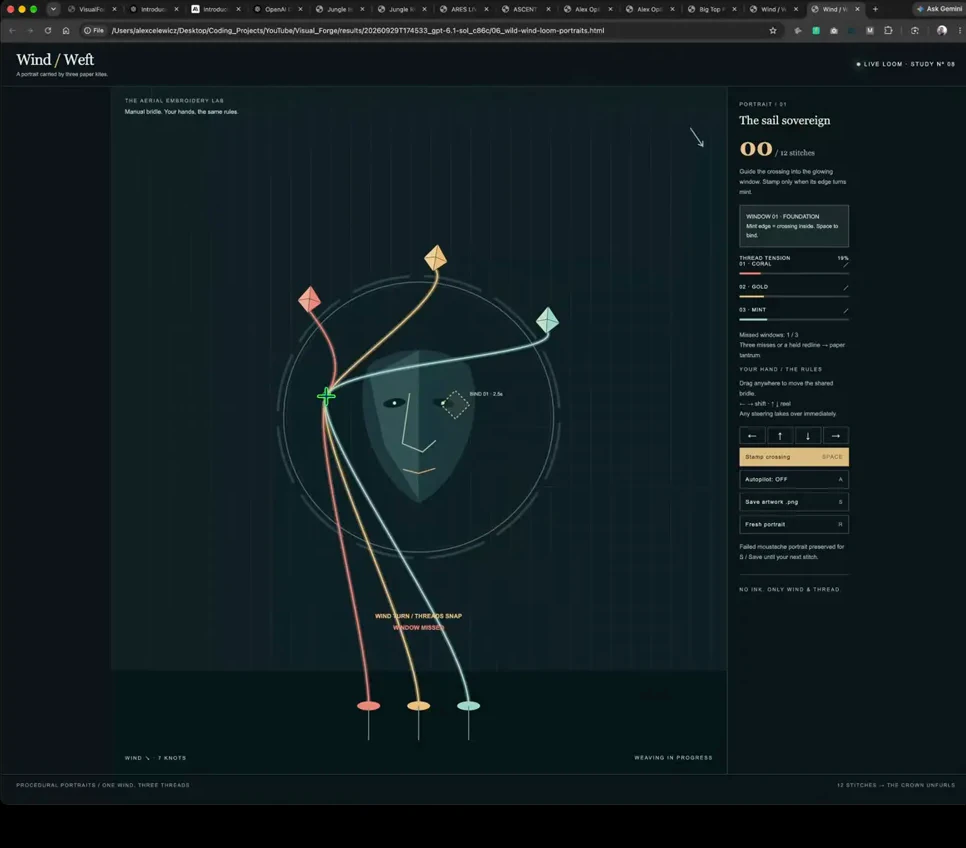
Sol 的答卷:一件带设置面板的艺术品——品味优先于可玩性。视频 6:25 处
到底该选哪个?
- 15
路由规则:按你实际使用的档位选模型
上面的数据自己就能长出决策树。如果你的 Sonnet 5.5 跑在 Low、Medium 或 High 档——大多数编程智能体、浏览器自动化和办公流程都在这几档——GPT-6.1 Sol 大概率分更高、账单只有约三分之一,这周就值得试点。如果你是刻意把 Sonnet 拧到 Max 的用户,请顺便对比 Opus 5.5:它在 Xhigh 档就能到同样的 56 分,每任务成本约一半。至于最难、最长的任务,Opus 5.5 仍是九月没人撼动的天花板。
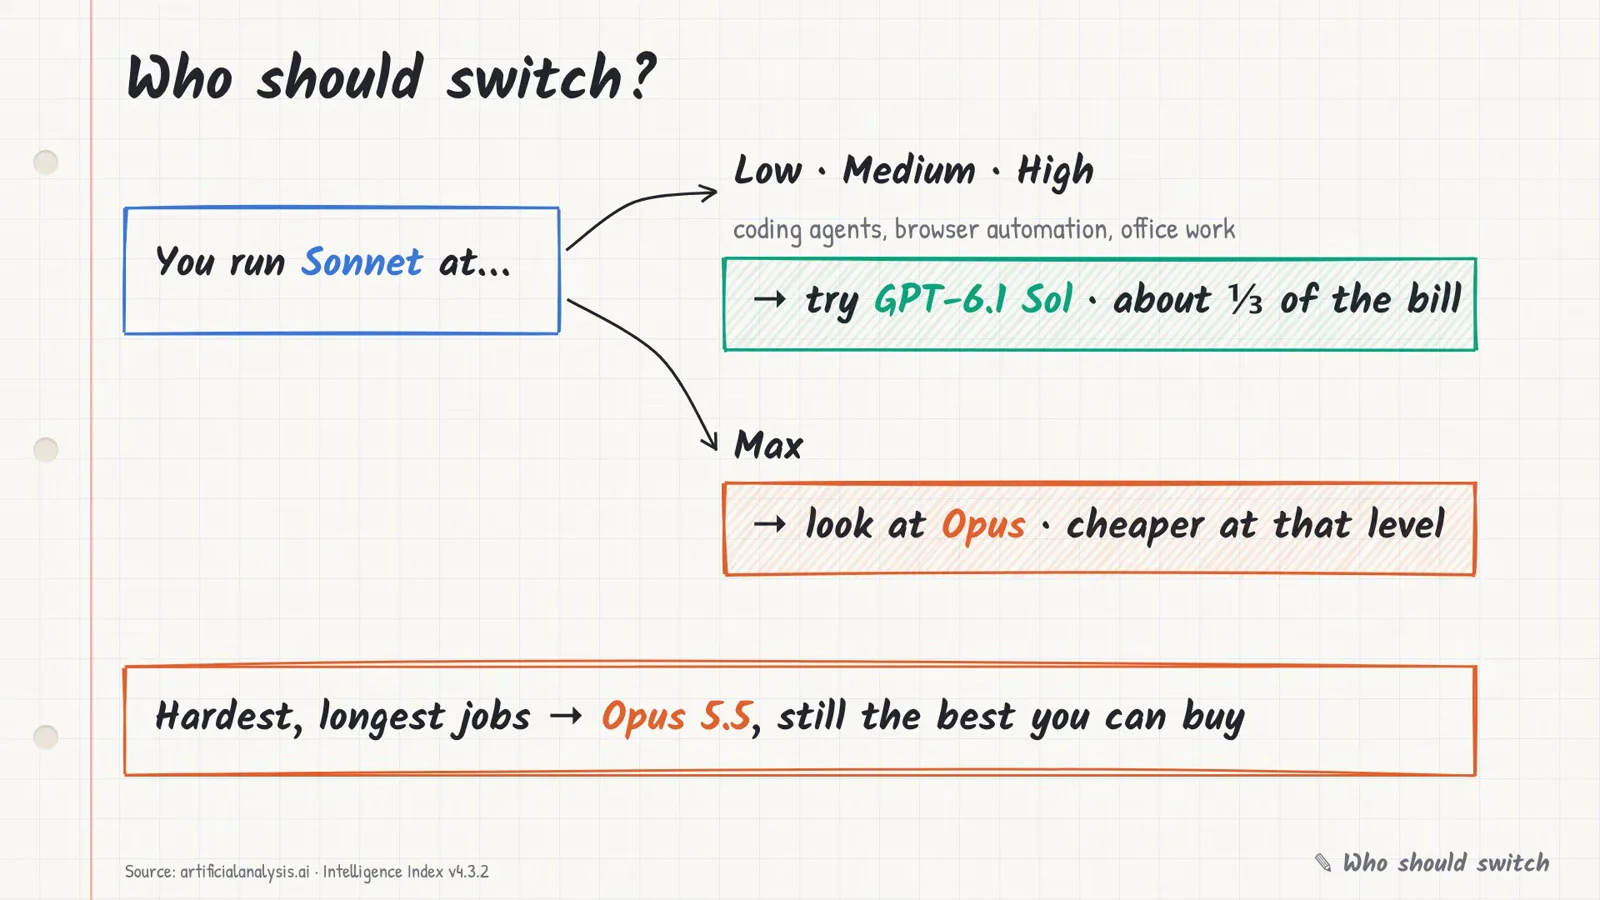
三支箭头一个习惯:先看你的档位,再看你的忠诚度。视频 8:58 处 - 16
迁移之前:三个值得知道的限制
三件事给 Sol 的热度降降温。普通 ChatGPT 对话里还没有它——入口是 ChatGPT Work、Codex 和 API。Ultrafast 极速档也还没轮到 Sol:OpenAI 官宣 Codex 将迎来最高 8 倍生成速度,而 VentureBeat 报道 Astra 已上线的 Ultrafast 按标准费率 6 倍收费,溢价可以预期。另外这些指数分数都是几天内的快照,随时会动。对冲一下:发布报道提到 Sol 的错误率与 GPT-6 Astra 相差在 1.9% 以内,绕过安全审查的企图也比 GPT-6 Sol 更少。
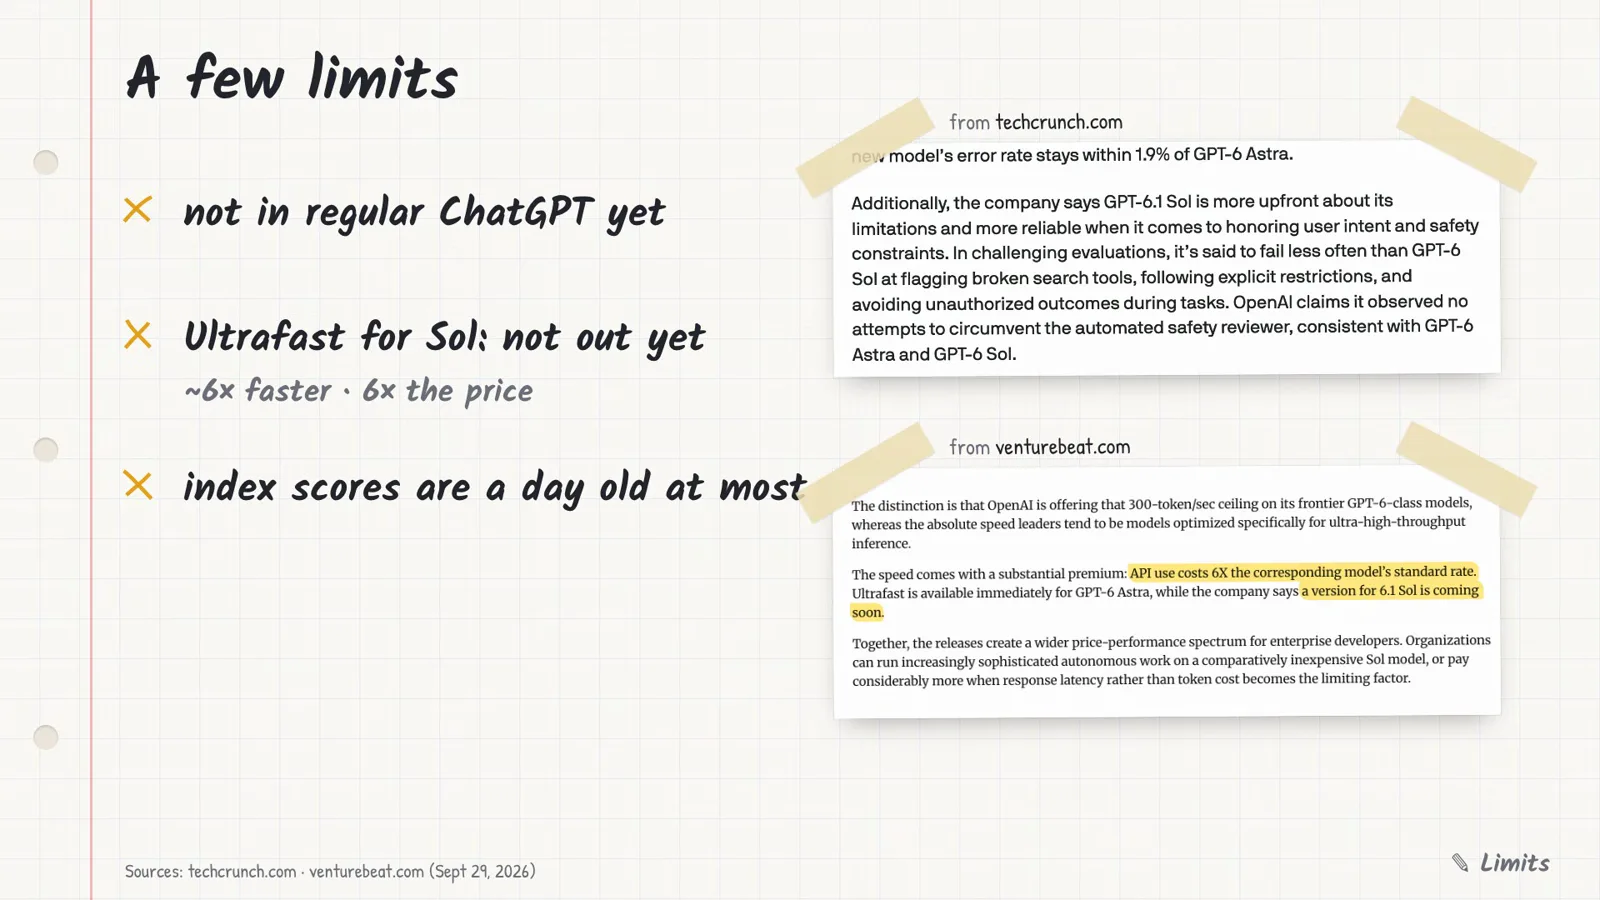
先买今天够得着的模型;Ultrafast 是承诺,不是商品。视频 8:30 处