

Bonsai 2(Ternary 27B)本地部署实战:2026 图文教程
Ternary Bonsai 2 27B 是 PrismML 在 2026 年 9 月 17 日发布的模型:把 Qwen3.8 27B 稠密模型的绝大多数权重压成三值的「负 1、0、正 1」,体积只有 5.9GB,官方口径是保留全精度模型 98.2% 的基准总分。一个 27B 级别的模型能塞进 8GB 显卡、24GB 显存的 GPU 或者配置像样的笔记本,这就是它几天内在本地大模型社区刷屏的原因。动手清磁盘之前先说一个实话:原版 Ollama 和 LM Studio 目前还加载不了这种三值权重文件,所以本教程走的是 PrismML 官方的 Bonsai-demo 路线——它自带的 llama.cpp 定制版加启动脚本,从头到尾一步不跳。下面每一张截图、每一个实测数字都来自四支上手视频:Digital Spaceport 在 Proxmox 上的单卡 RTX 3090 部署(主源)、Fahd Mirza 的 Ubuntu 服务器实战、DEEPTECH AI LABS 的 8GB 显卡拆解、Execute Automation 的 M5 Max 实测,厂商数字则以 PrismML 公告、模型卡和 Bonsai-demo README 交叉核对。
来源与致谢
本教程的截图来自 Digital Spaceport 的公开演示视频。每个步骤都链接到视频中的对应时间点,方便你对照学习。
Digital Spaceport ↗安装之前,先认识 Bonsai 2
- 1
从官方公告读起
2026 年 9 月 17 日,PrismML 发布 Ternary Bonsai 2 27B:把 Qwen3.8 27B 稠密模型做 2-bit 三值压缩,体积只有 5.9GB——比大约 54GB 的全精度版本小 9 倍多——官方宣称保留 98.2% 的基准总分。许可证是 Apache 2.0,支持 262K 上下文和文本加图片输入。这些是厂商口径的数字,所以在你腾磁盘空间之前,本教程还会用三支独立实测视频来核对它们。
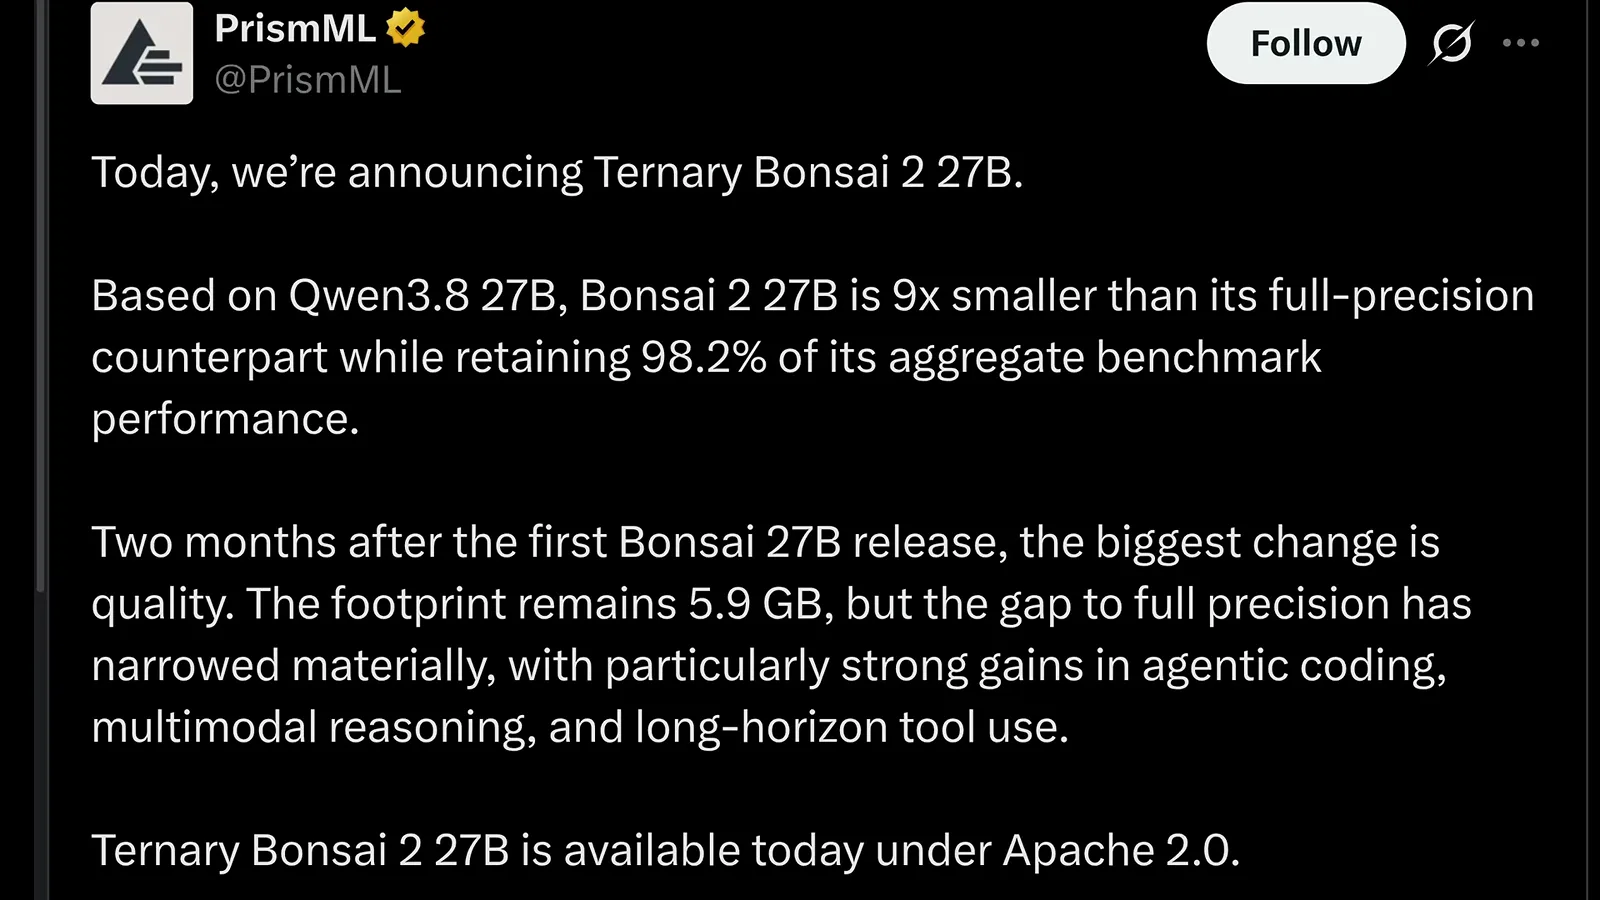
厂商自己的卖点,直接摘自 9 月 17 日的公告帖。视频 0:12 处 - 2
搞懂为什么 27B 能塞进约 6GB
普通模型里每个权重都是一个 16 位数字。Bonsai 2 把几乎全部语言权重舍入成三种状态:负 1、0 或正 1。每 128 个权重共享一个全精度 FP16 缩放系数——三值负责方向,缩放系数负责幅度,两者相乘就能还原出接近原始的权重。这样平均每个权重只要约 1.7 个有效比特,部署体积从 FP16 的 54GB 降到 7GB 上下,同时保留约千分之一的权重维持高精度来兜住质量。
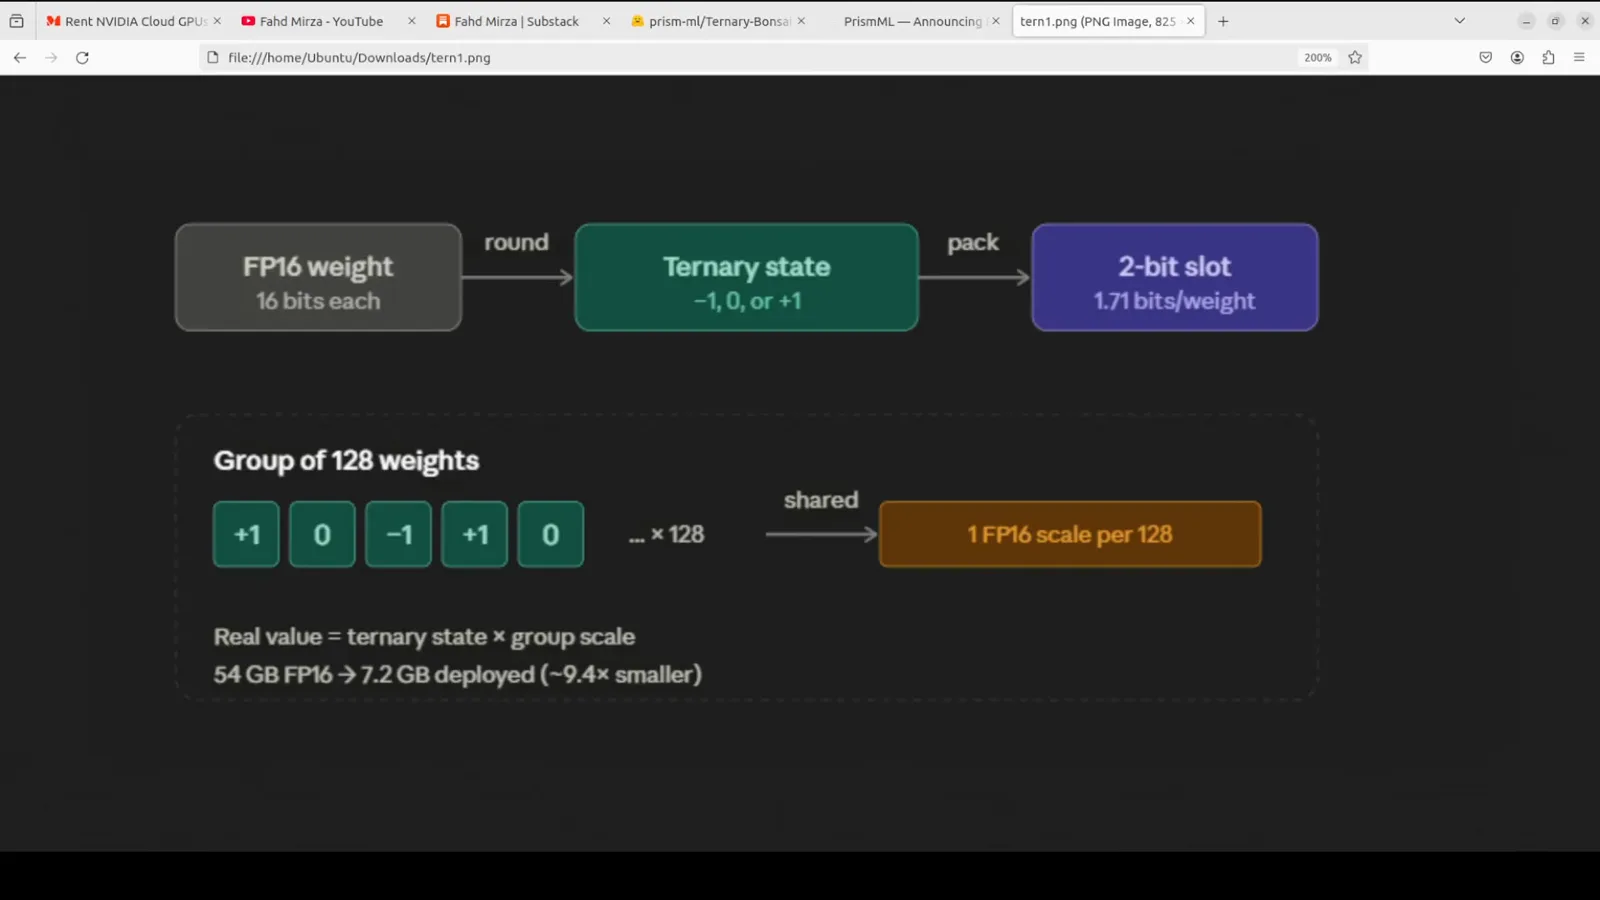
方向由开关决定,幅度由共享的组缩放系数决定。视频 2:30 处 - 3
给你的显卡挑对文件体积
发布版在全精度之外提供两种打包:紧凑打包的 5.95GB 版和更松散的 PQ2_0 版 7.21GB,对比约 54GB 的 FP16 原版。Bonsai-demo 安装脚本默认下载更大的 PQ2_0 文件加视觉投影器——对 12GB 及以上显存是正确选择。8GB 显卡用户请自己手动下载 5.95GB 的小文件,并配合后文讲到的 4-bit KV 缓存选项。
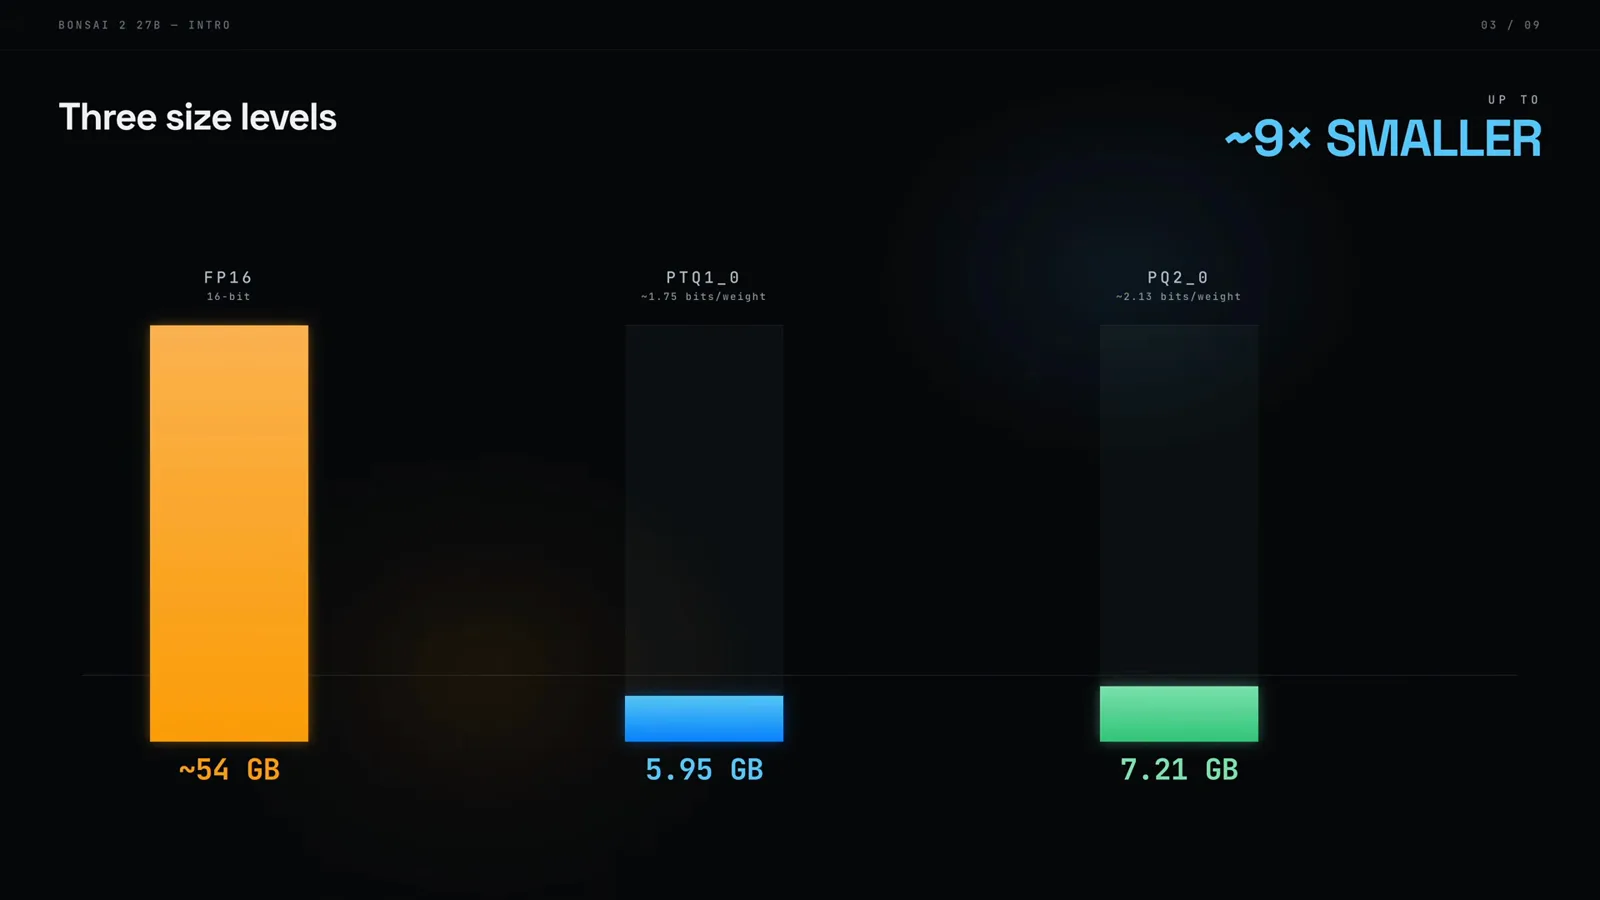
同一个 27B 模型,磁盘和显存账单差出三档。视频 0:46 处 - 4
先泼冷水:Ollama 和 LM Studio 现在还加载不了
这是大部分封面不会告诉你的部分。原版 Ollama 和 LM Studio 目前都打不开 Bonsai 2 的三值文件——社区里虽然有 Ollama 镜像仓库,但原版 Ollama 加载不了 PQ2_0 或 PTQ1_0 这类量化,原版 llama.cpp 则要么拒绝读文件、要么因为权重以旋转方式存储而输出乱码。PrismML 自家构建才懂 CUDA 和 Metal 的定制数学,而这正是 Bonsai-demo 安装脚本会装上的东西。主流工具的支持正在一点点向上游合并;在补丁合并之前,请照下面的官方路线跑。
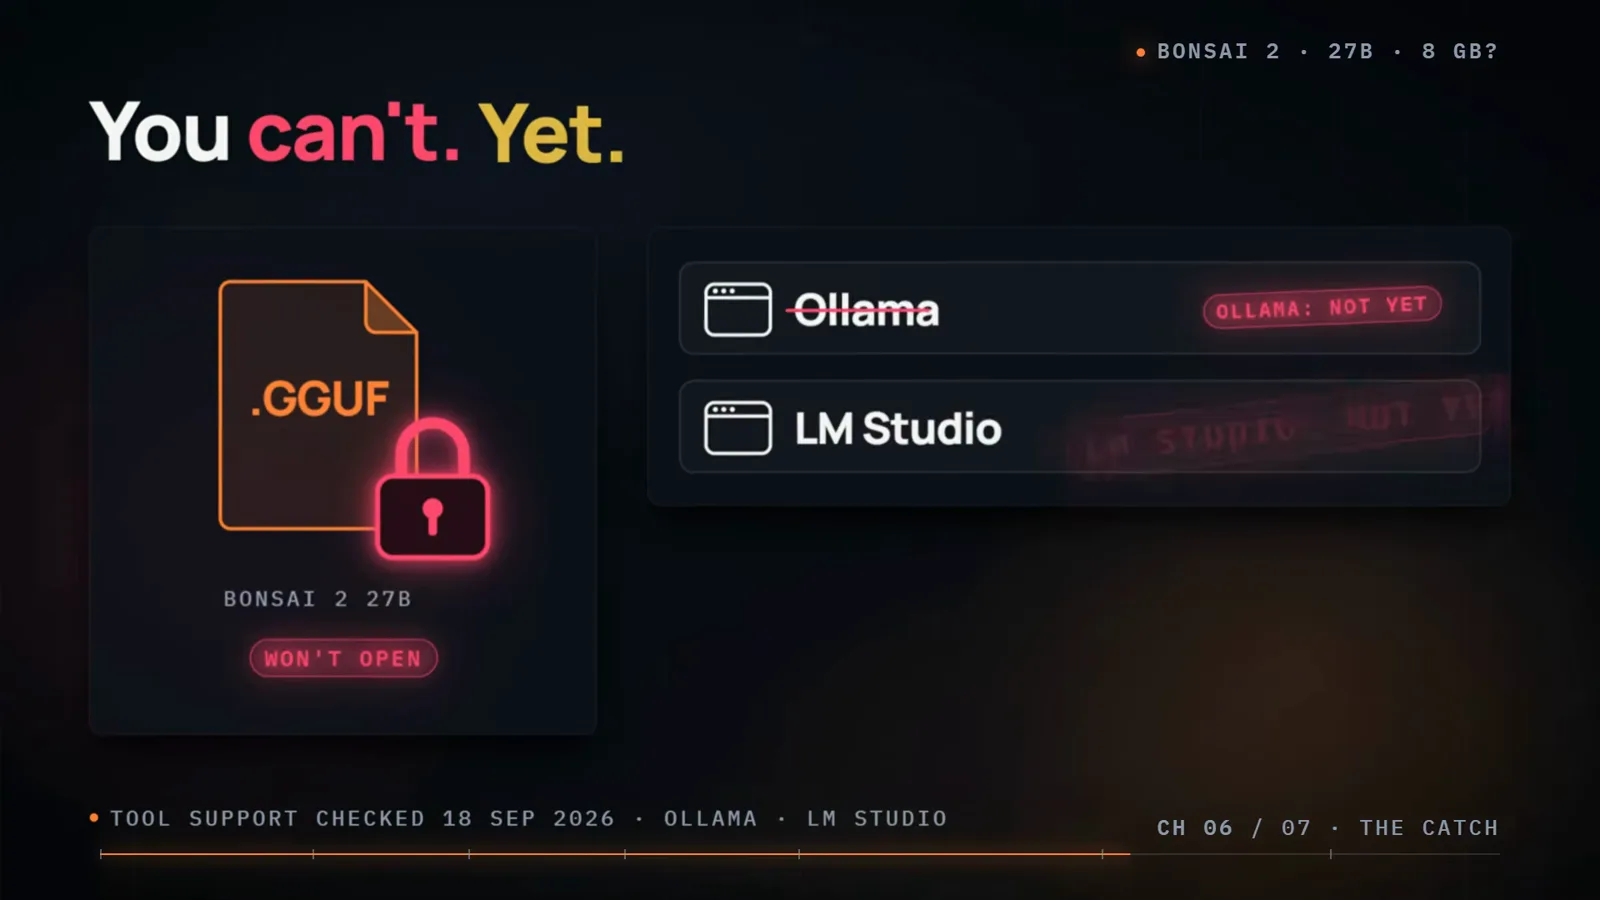
工具支持情况核对于 2026 年 9 月 18 日——文件装得下,启动器还没跟上。视频 6:04 处 - 5
算清显存账:权重加缓存加运行开销
全精度光语言权重就要 53.8GB——那是服务器的领地。Bonsai 2 把它压到 5.9 到 7GB,但显卡还要装 KV 缓存和运行时的临时空间,小显存的 Windows 卡上显示器和驱动还要再占走约 1GB。PrismML 说这个模型能跑在笔记本或单卡上。实际经验是:24GB 显存(如 RTX 3090)跑得从容;8GB 显卡用小文件、保守上下文加 4-bit KV 缓存也能跑;Mac 想跑长会话建议 32GB 统一内存起步。
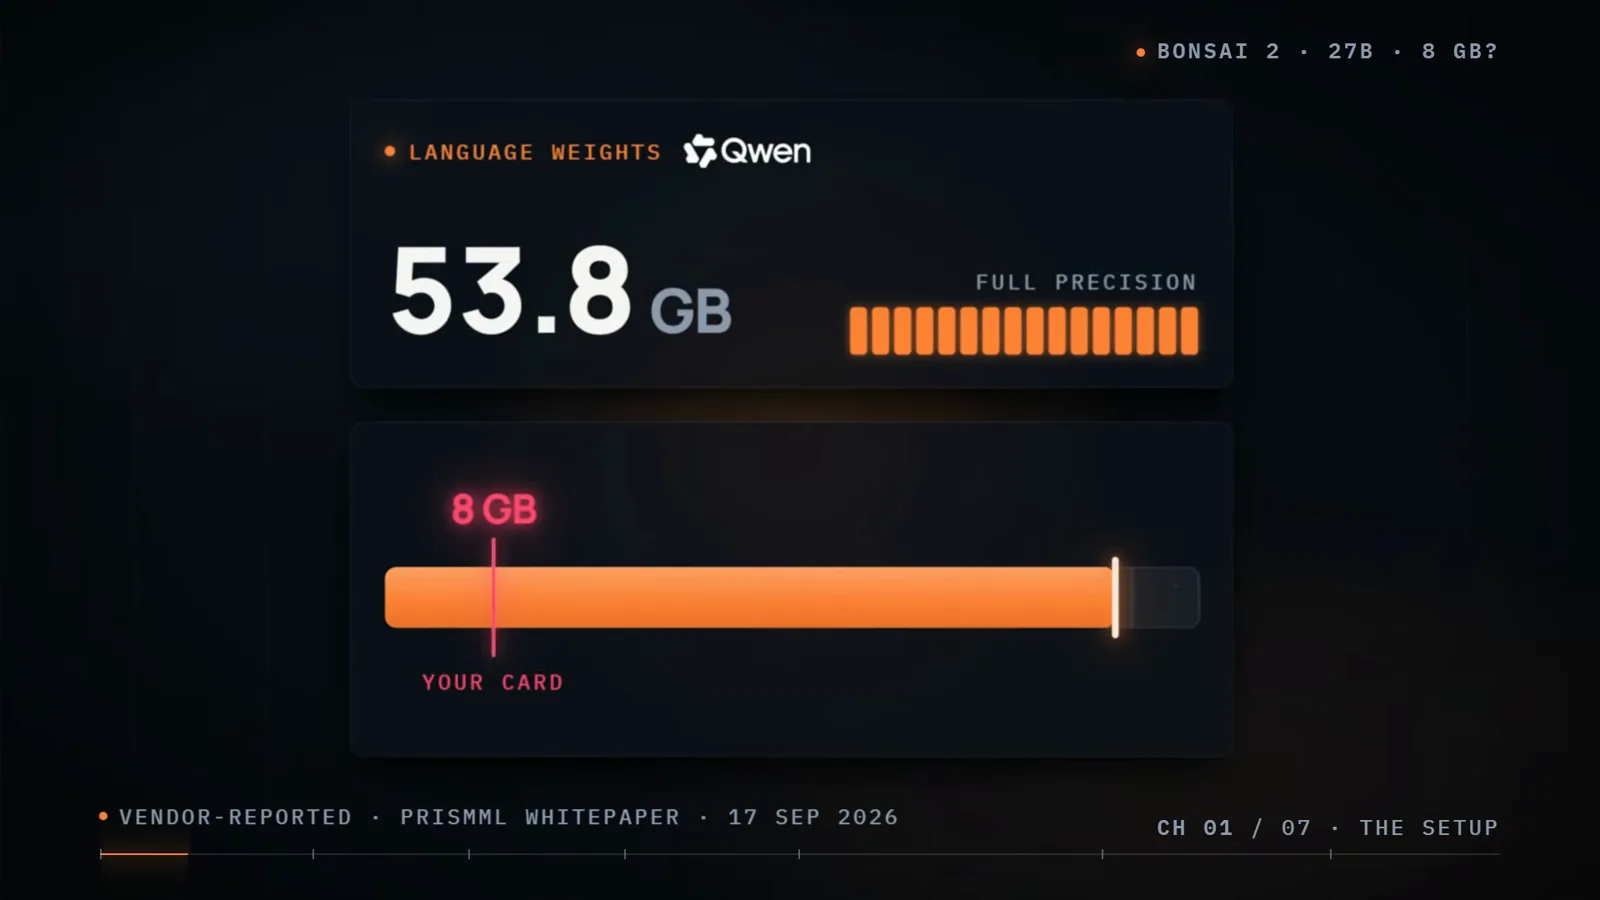
权重只是容易的那一半——缓存和开销才决定到底装不装得下。视频 0:31 处
用官方 Bonsai-demo 脚本安装 Bonsai 2
- 6
在 Hugging Face 找到 GGUF 权重
PrismML 把权重发布在 Hugging Face 的 prism-ml 账号下:有面向 llama.cpp 的 GGUF 打包,也有面向 Apple Silicon 的 MLX 版本,全部 Apache 2.0、全部公开仓库,不需要任何访问令牌。你甚至不用手动点下载——下一步的安装脚本会全部拉取——但建议打开仓库页看一眼文件变体和 llama.cpp 兼容性表。
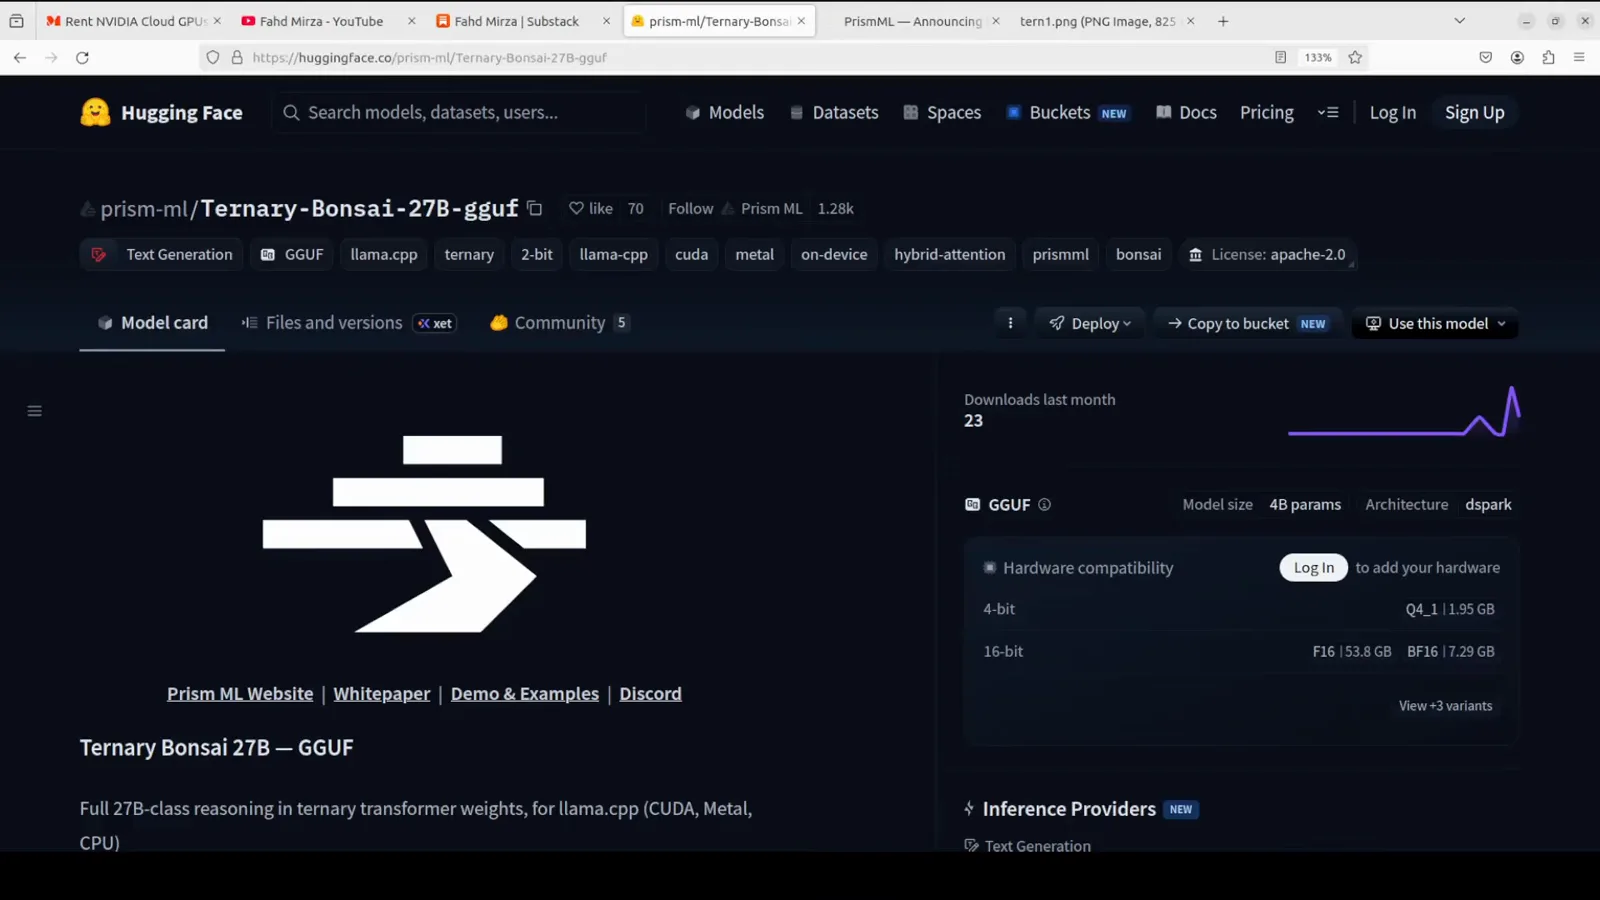
公开仓库、Apache 2.0——文件由脚本替你拉取。视频 0:01 处 - 7
克隆 Bonsai-demo 仓库
所有东西都在一个仓库里。macOS 或 Linux 上运行:git clone https://github.com/PrismML-Eng/Bonsai-demo.git,然后 cd Bonsai-demo,再执行 ./setup.sh。Windows PowerShell 用户把最后一行换成 setup.ps1。这个 demo 里带着锁定版本的 PrismML llama.cpp 构建、启动脚本和一个轻量网页界面,其他东西都不用手动装。
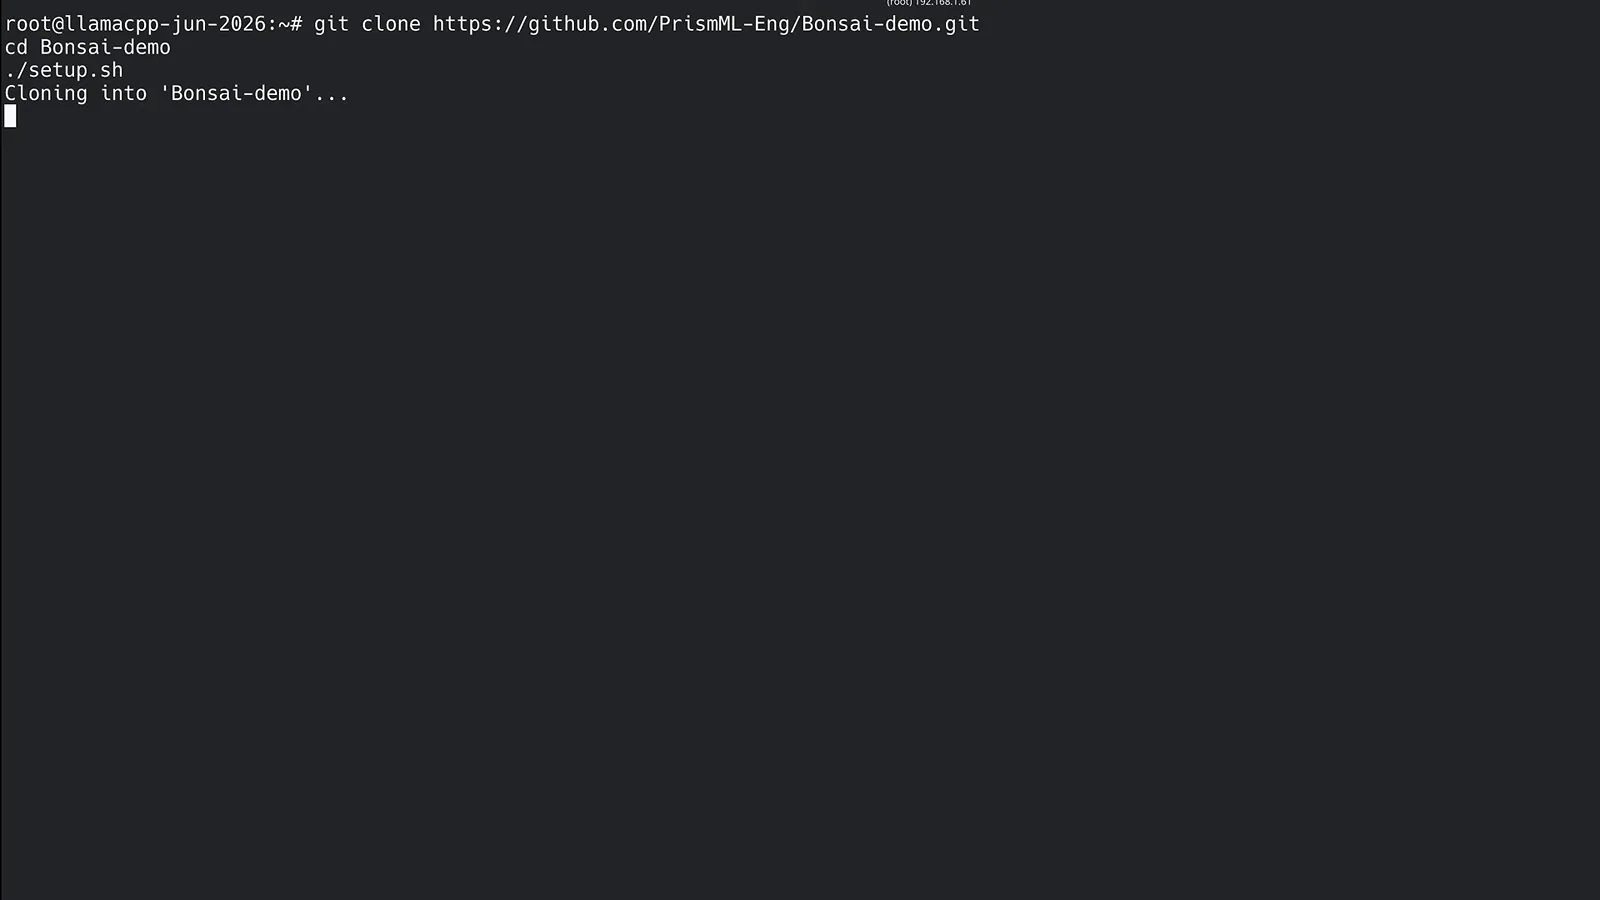
一个仓库装下 llama.cpp 构建、脚本和网页界面。视频 1:06 处 - 8
运行安装脚本,令牌直接回车跳过
安装脚本会创建 Python 3.11 虚拟环境,装好基础依赖(cmake、ninja、huggingface 命令行工具),探测你的 CUDA 版本,然后下载匹配的 PrismML llama.cpp 预编译二进制——完全不用编译。提示输入可选的 HuggingFace 令牌(用于私有仓库)时,直接按回车跳过即可。Windows 用户运行 setup.ps1,步骤完全一致。
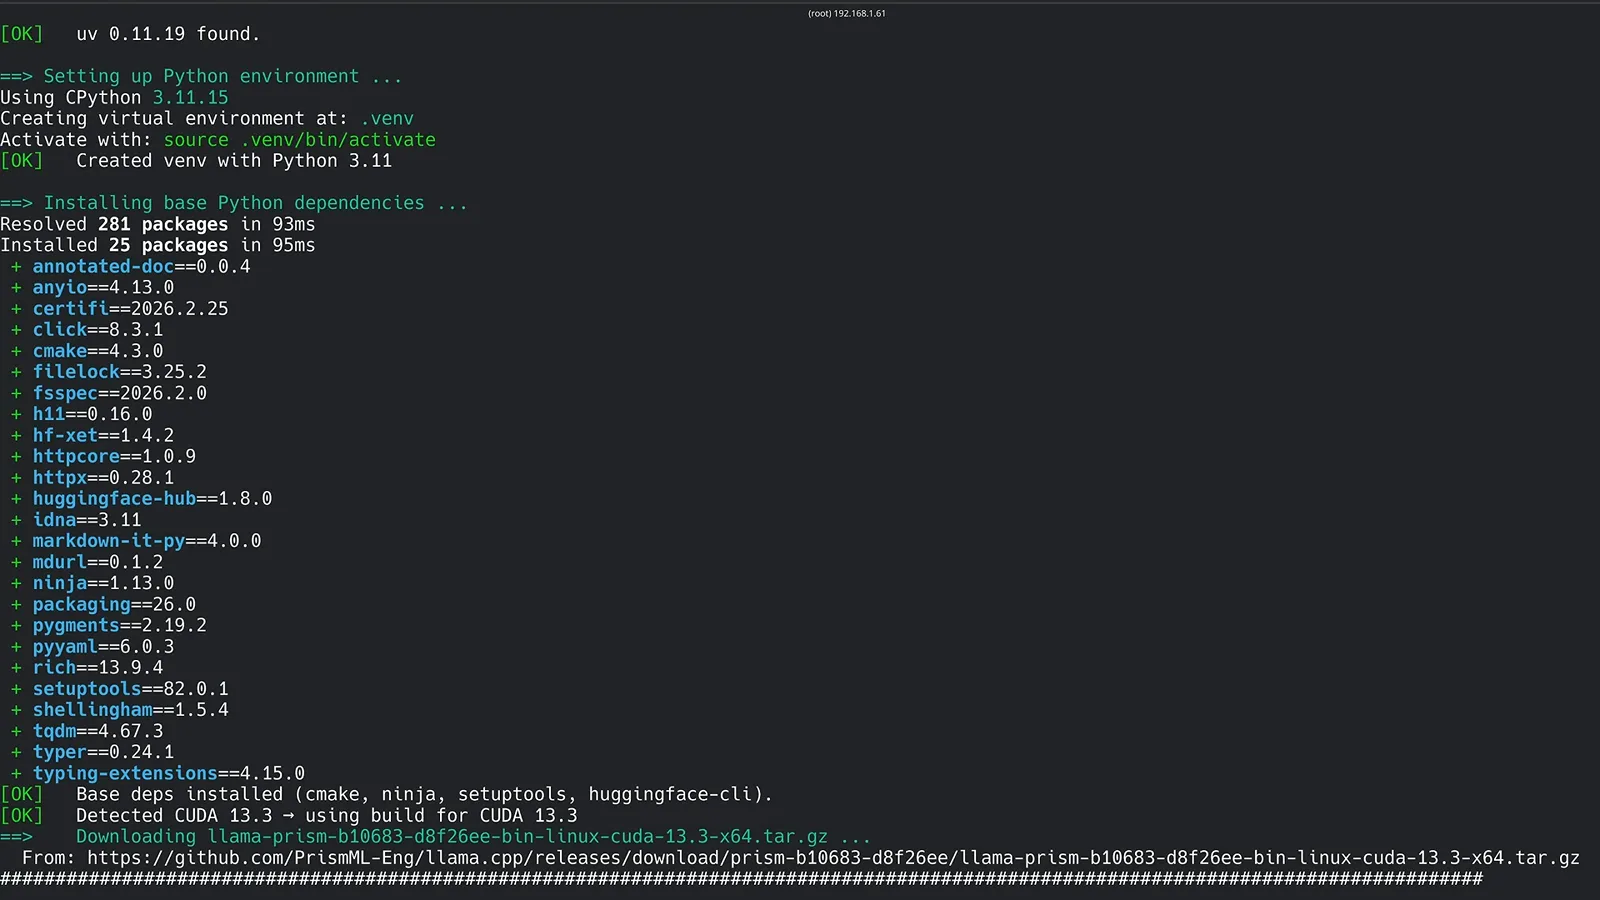
来自 PrismML 分支的预编译二进制——cmake 装了但永远不用你跑。视频 1:10 处 - 9
设置真正重要的环境变量
demo 里的每个启动器都读环境变量。有四个值得记住:BONSAI_HOST 覆盖默认回环绑定——设成 0.0.0.0 才能让局域网其他机器访问服务(默认 127.0.0.1 更安全)。BONSAI_CTX 固定上下文长度;不设则按内存自动分档,最高 262,144 tokens。BONSAI_KV4=1 打开 4-bit KV 缓存,每 token 约省 3.5 倍空间。BONSAI_SPECULATIVE=1 启用 dspark 投机解码,在 CUDA 上有 1.8 到 2.4 倍收益。
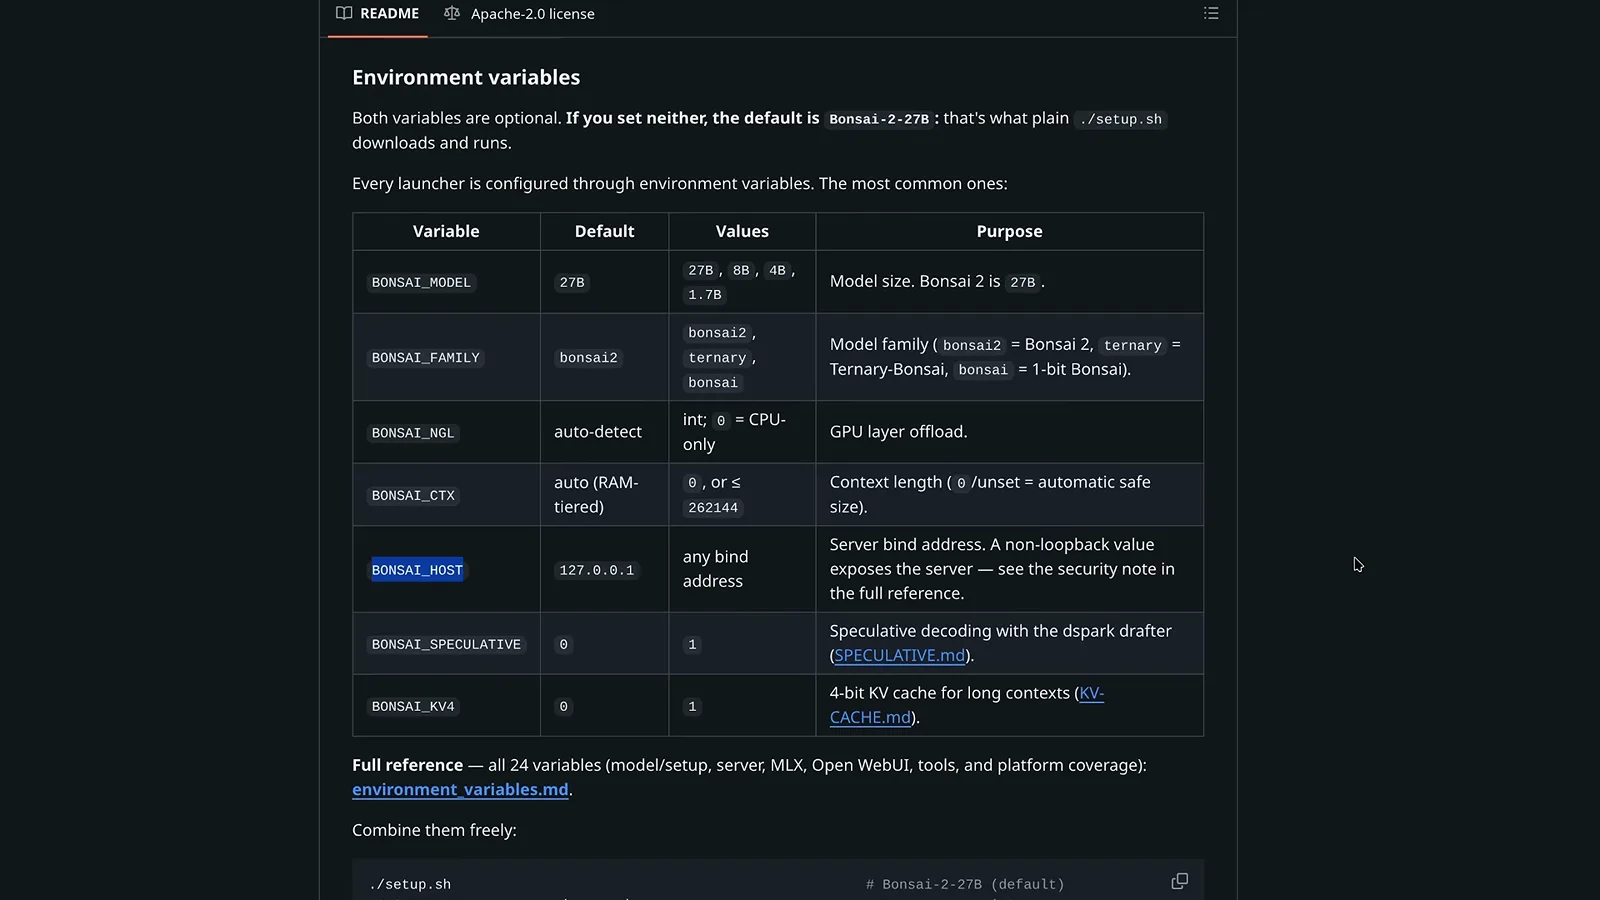
默认值都很合理——大多数人改的只有绑定地址。视频 3:05 处 - 10
启动服务,打开 8080 端口
用 ./scripts/start_llama_server.sh 启动(Windows 用 start_llama_server.ps1)。日志会先显示多模态投影器加载、统一上下文槽位——这台 24GB 显存的机器分到 131,072 tokens——然后出现最关键的一行:llama_server: listening on http://0.0.0.0:8080。在浏览器打开这个地址,demo 的聊天界面就绪;同一端口还提供 OpenAI 兼容 API 给 agent 调用。
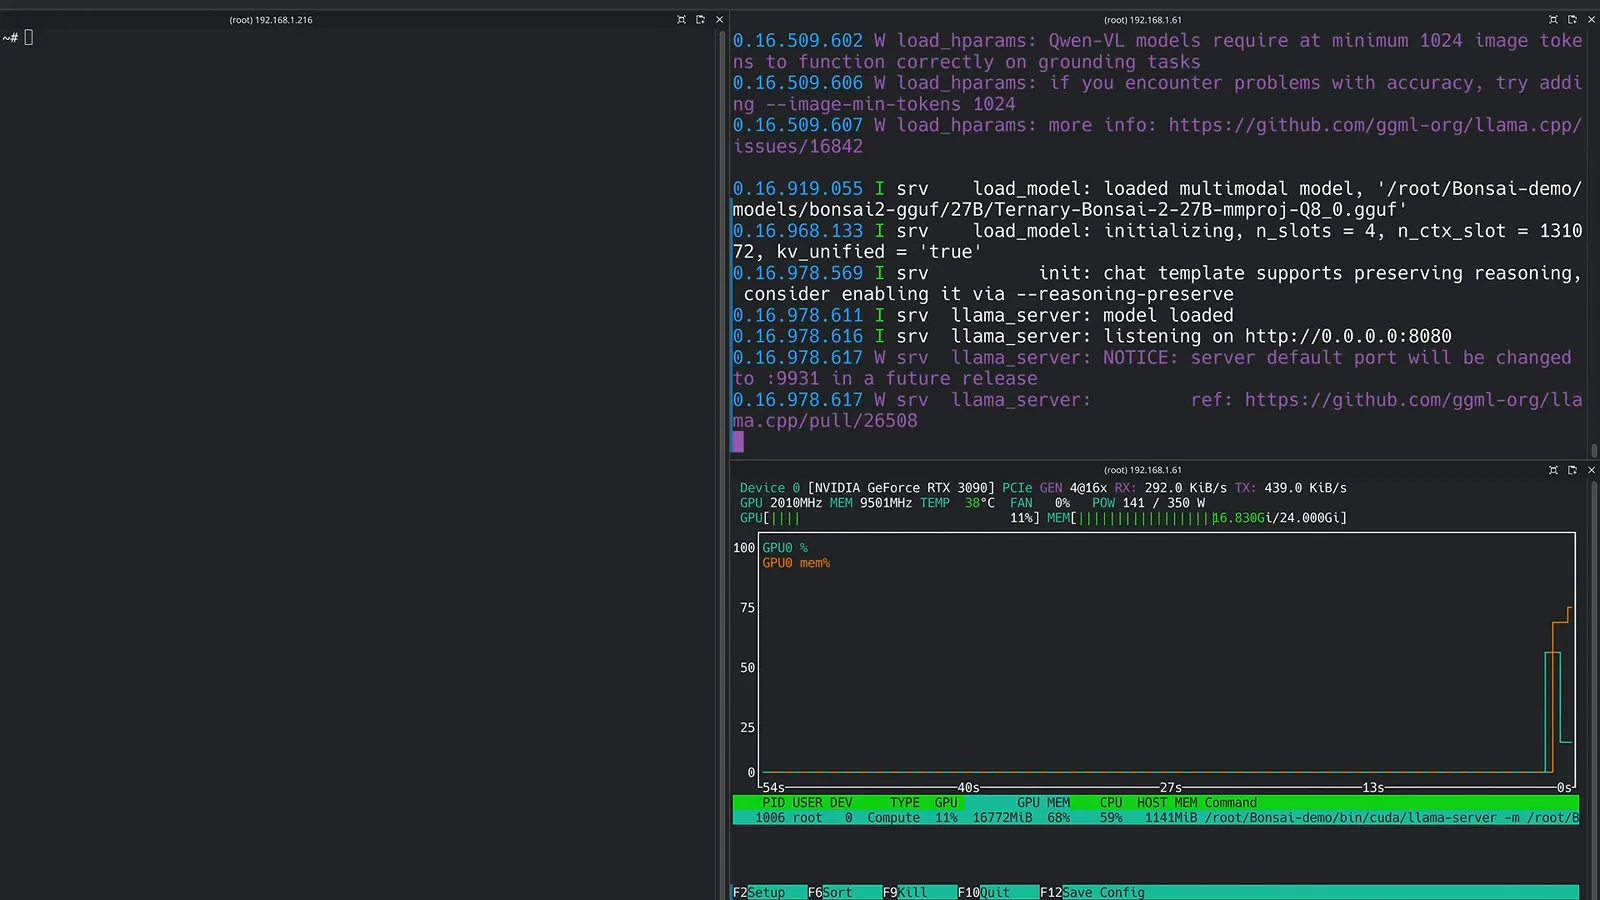
模型加载完、KV 缓存预留好、监听 8080——这就成了。视频 4:01 处
首次运行:显存、第一条提问和速度
- 11
用 nvtop 核对显存占用
服务起来后,nvtop 会告诉你这笔预留的真实成本:llama-server 进程占掉这块 RTX 3090 的 24GiB 中的 16.8GiB——约 7GB 是权重,其余是为 131K 上下文预分配的 KV 缓存。小显存显卡要盯住的就是这个数:调小 BONSAI_CTX 或打开 BONSAI_KV4=1,占用会随之下降,给第二个模型或桌面腾出空间。
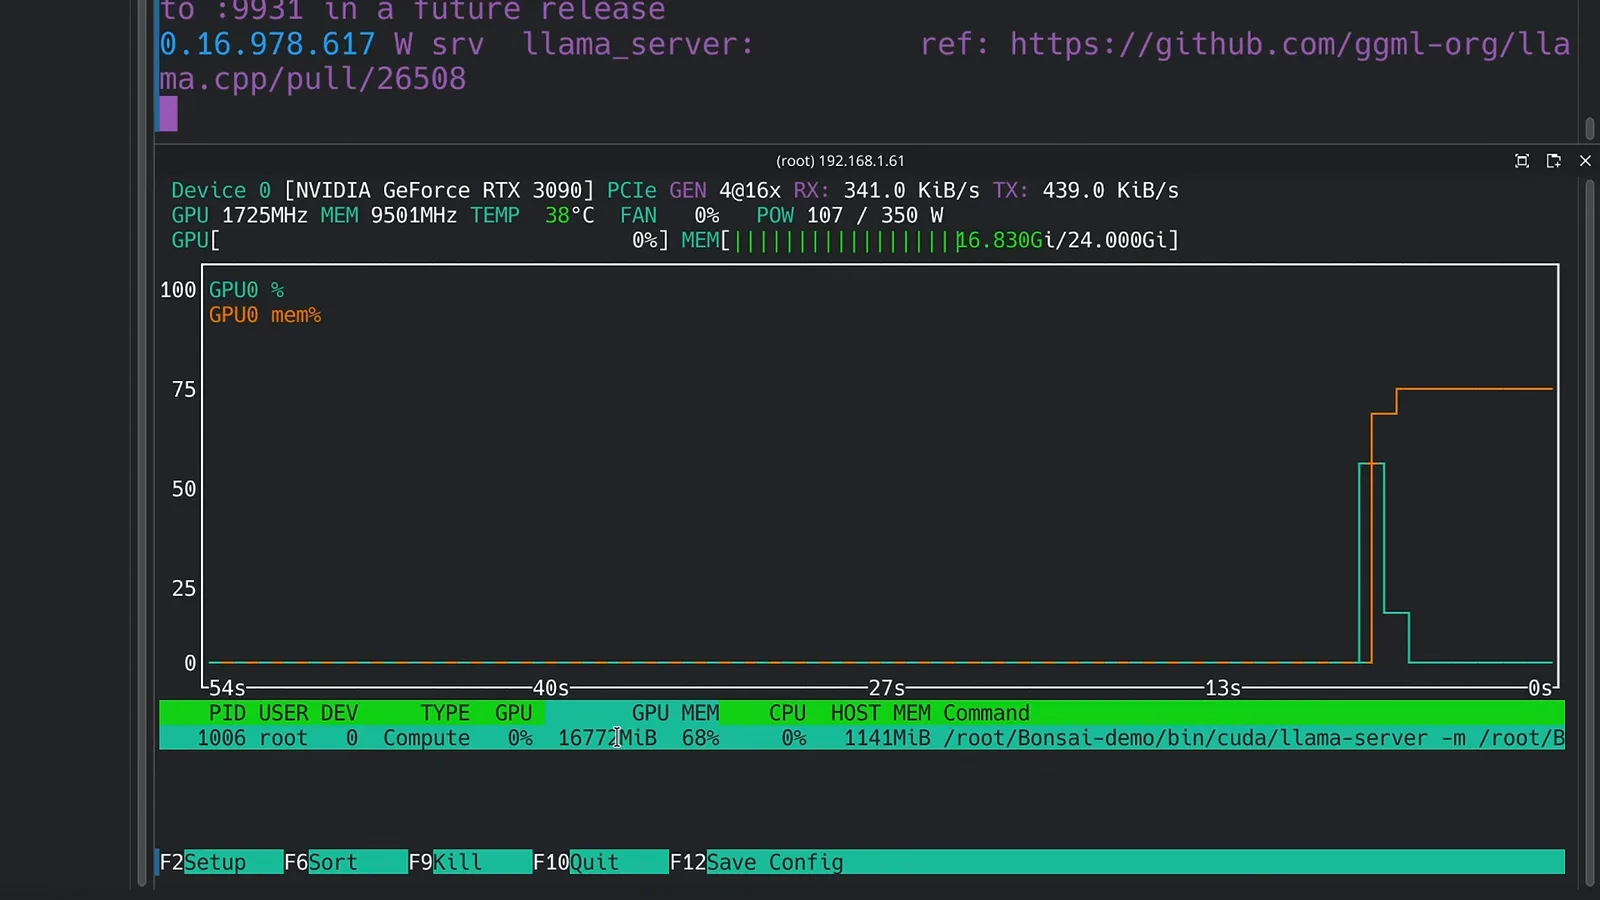
权重约 7GB;预留里剩下的都是 KV 缓存。视频 4:07 处 - 12
发出第一条提问
输入 howdy,几秒内就能收到 Howdy there! What can I help you with? 的回复。回复自带遥测:由 Ternary-Bonsai-2-27B-PQ2_0.gguf 生成的 45 个 tokens 跑出 69.02 tokens 每秒,短提问的预填充速度约 784 tokens 每秒。看到这个量级说明 GPU 通路正常;如果解码慢得可怜,八成在用 CPU——去检查 BONSAI_NGL。
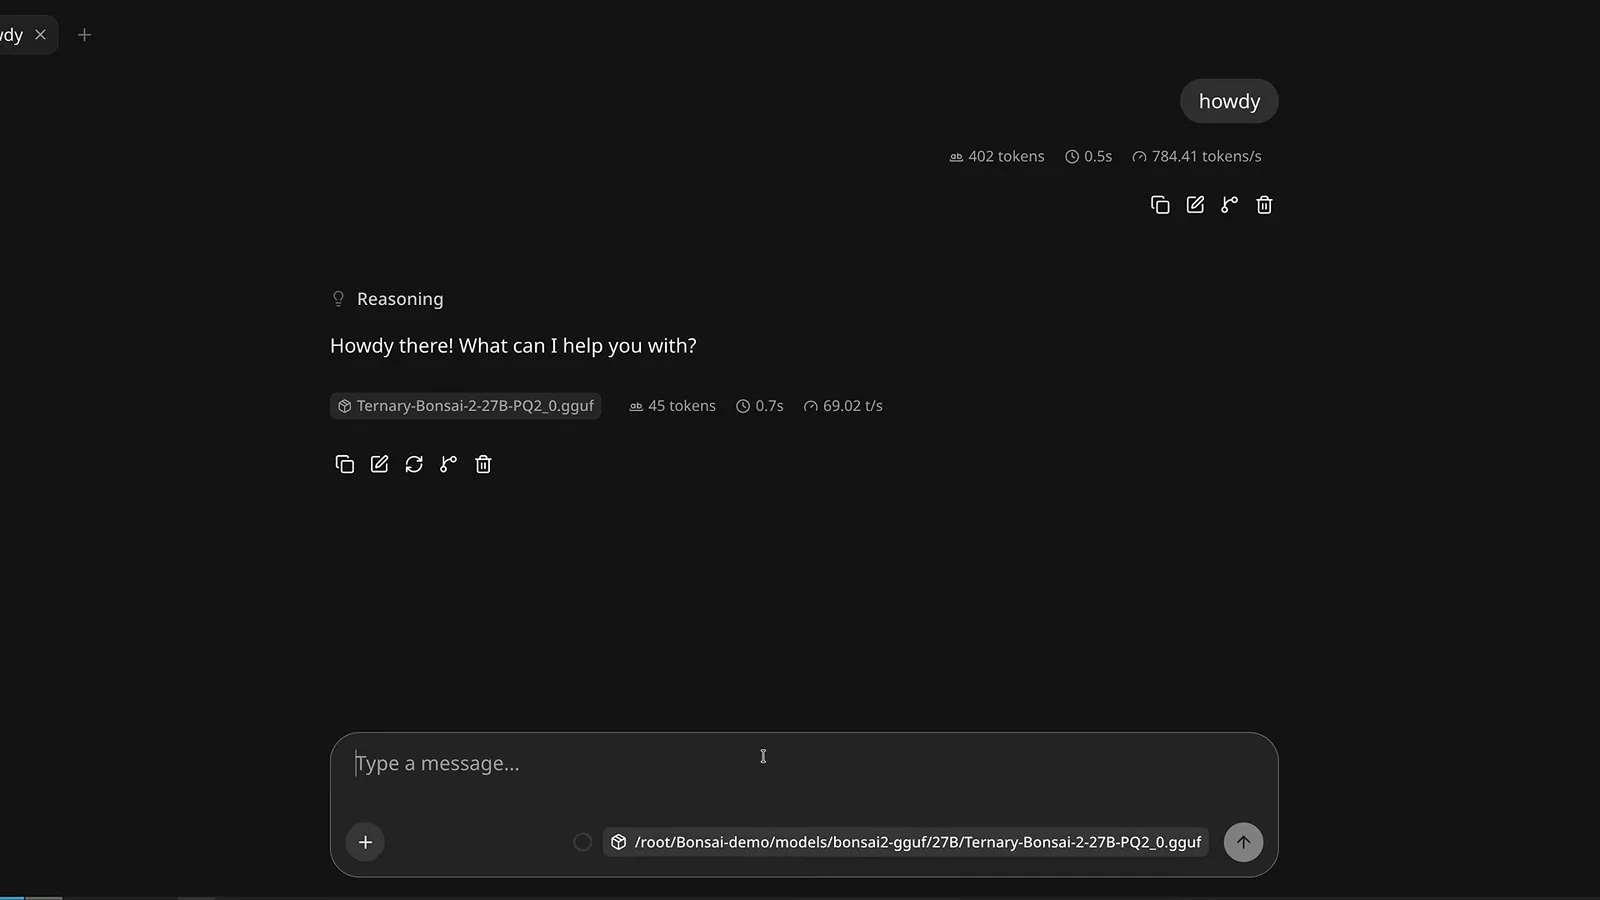
回复页脚就是你的 GPU 体检单。视频 4:31 处 - 13
诚实读速度:约 69 tokens 每秒
单张 RTX 3090 的持续解码速度约 69 tokens 每秒——这条 625 tokens 的回答是 69.35——提示词处理约 1,250 tokens 每秒。PrismML 官方口径是 RTX 5090 最高 143 tokens 每秒、M5 Max 46.8,所以 3090 跑在 70 上下完全符合预期。真实 agent 负载会远低于裸解码——一次 M5 Max 实测端到端平均只有 14 tokens 每秒——把页脚数字当上限,而不是日常预期。
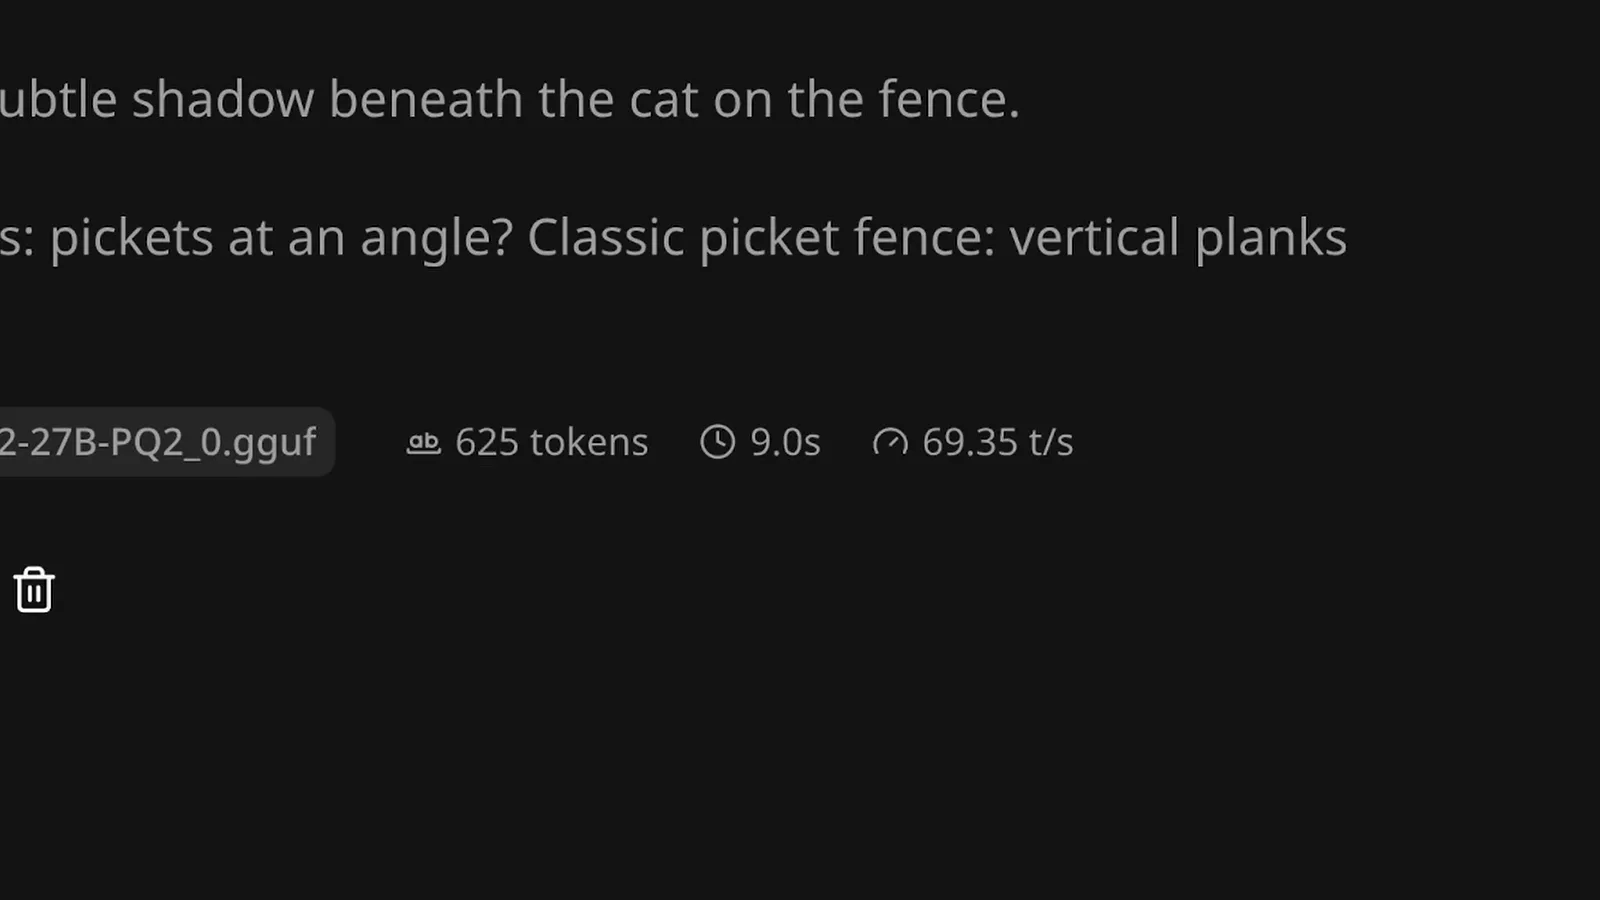
解码速度是上限——agent 循环远低于它。视频 4:49 处
对比 Qwen 3.8 的基准成绩,以及 2-bit 的代价在哪
- 14
Bonsai 2 对比 Qwen 3.8:看懂官方成绩表
PrismML 模型卡给出的总分是:Bonsai 2 的 83.9 对全精度 Qwen3.8 27B 的 85.4——也就是那个著名的 98.2%。分项表格能看出分数丢在哪:数学几乎无损(96.57 对 97.06),编码和指令跟随在这几行里甚至反超(89.42 对 89.07,82.66 对 81.25),而知识与推理出现明显下滑(79.86 对 85.55)。全部为厂商自报数据,看看就好——但这个形状与独立实测者看到的一致。
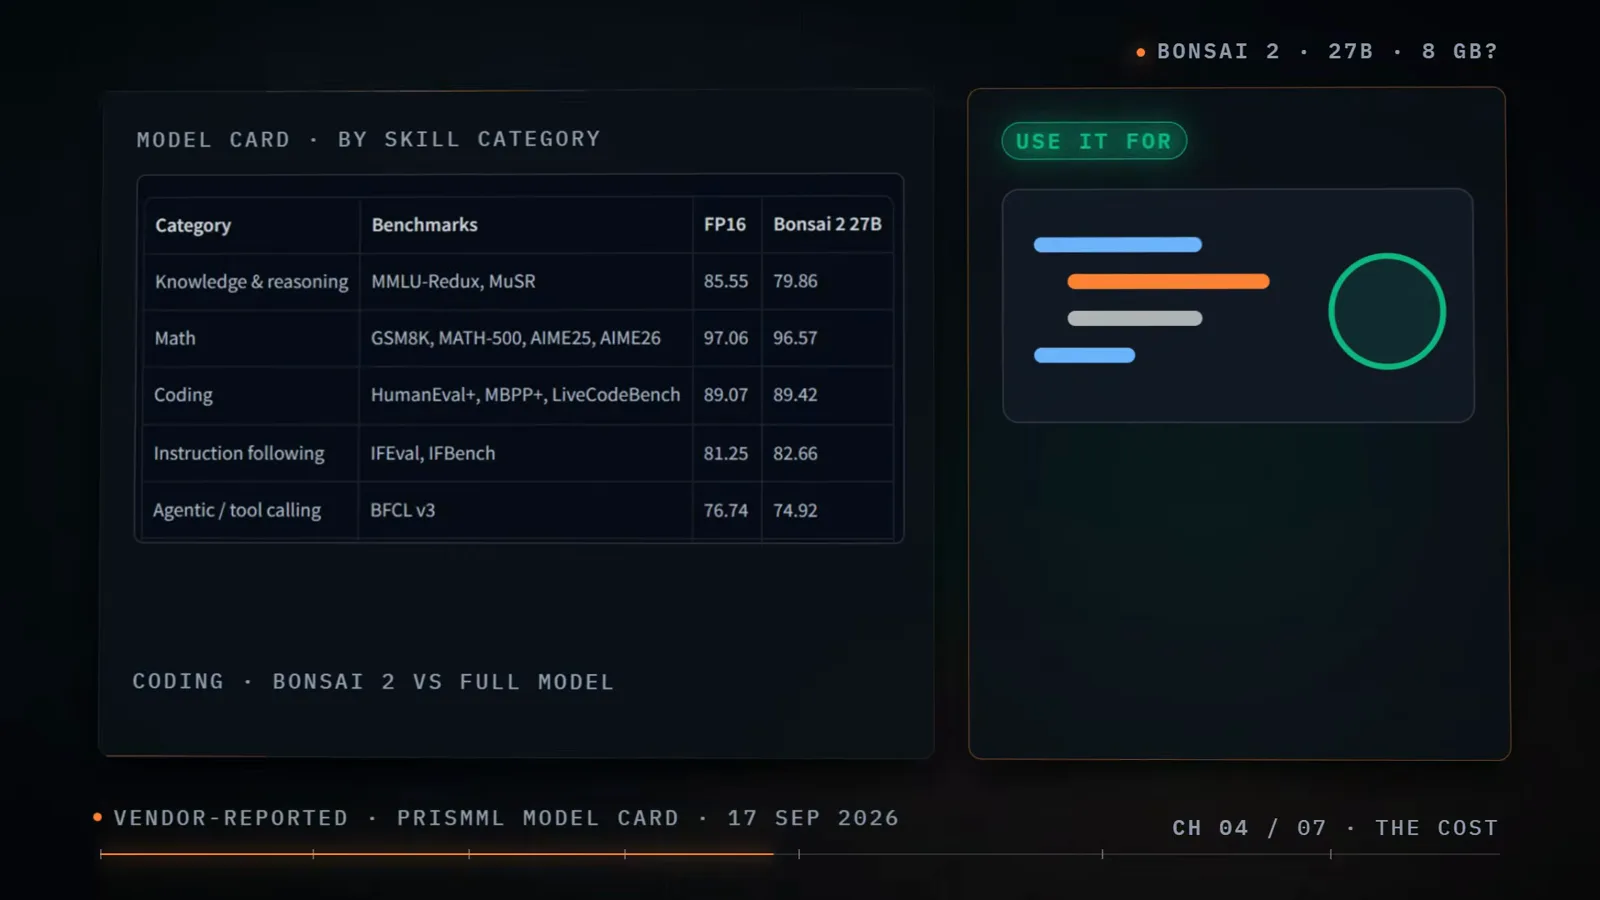
98.2% 是个平均数——分项行才看得出分数从哪来。视频 3:58 处 - 15
搞清 2-bit 的代价咬在哪里
差距集中在长链路的多步编码上。在 SWE-bench Verified 风格的真实 GitHub issue 测试里,PrismML 自己白皮书给出的数字是全模型 80.6、Bonsai 2 只有 60.8——大约每修四个才成三个。短篇编码求助、聊天和工具调用都扛得住(Digital Spaceport 实测没有丢过一次工具调用),但大型代码库里的长任务就会拉开差距;Execute Automation 的一次 SVG 任务产出也明显弱于 Q4 的 Qwen 3.8。
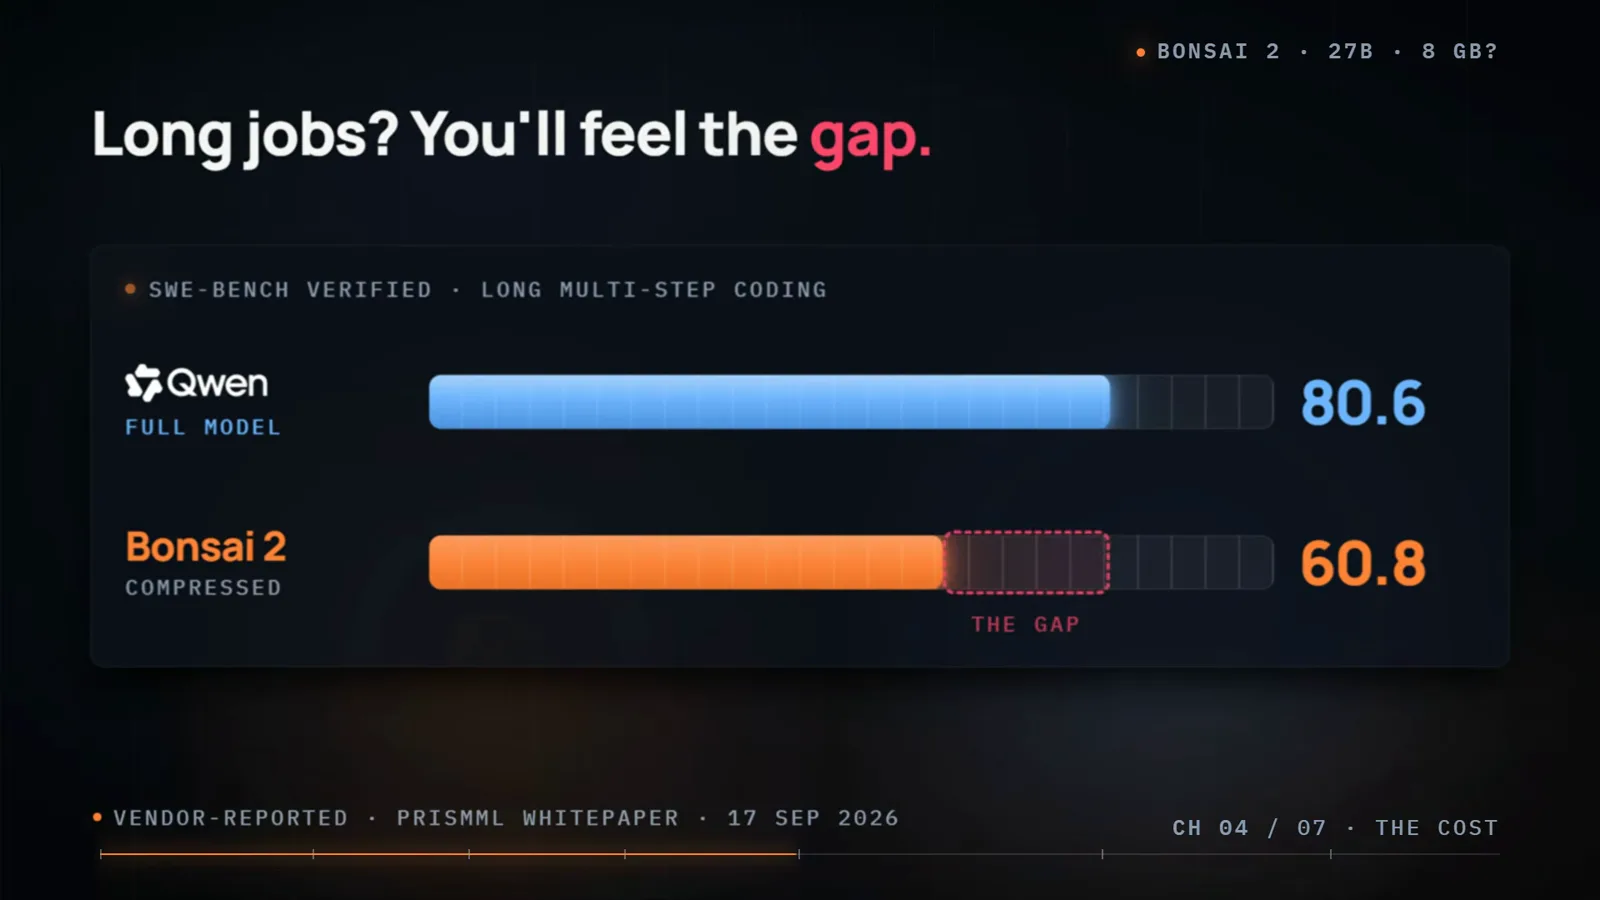
把 agent 指向大仓库之前,先看这张图。视频 4:06 处 - 16
盯紧 Ollama 和 LM Studio 何时跟上
启动器的现状只是暂时的。PrismML 已经开始把改动向上游送——截至 2026 年 9 月 18 日视频核对时,指向 llama.cpp 主项目的第 27779 号拉取请求仍是 open 未合并状态。等三值内核和旋转权重加载合入之后,基于原版 llama.cpp 的工具——包括 Ollama 和 LM Studio——就会以正常方式获得支持。在那之前,继续用 PrismML 构建,每隔几周回头看看你常用的启动器。
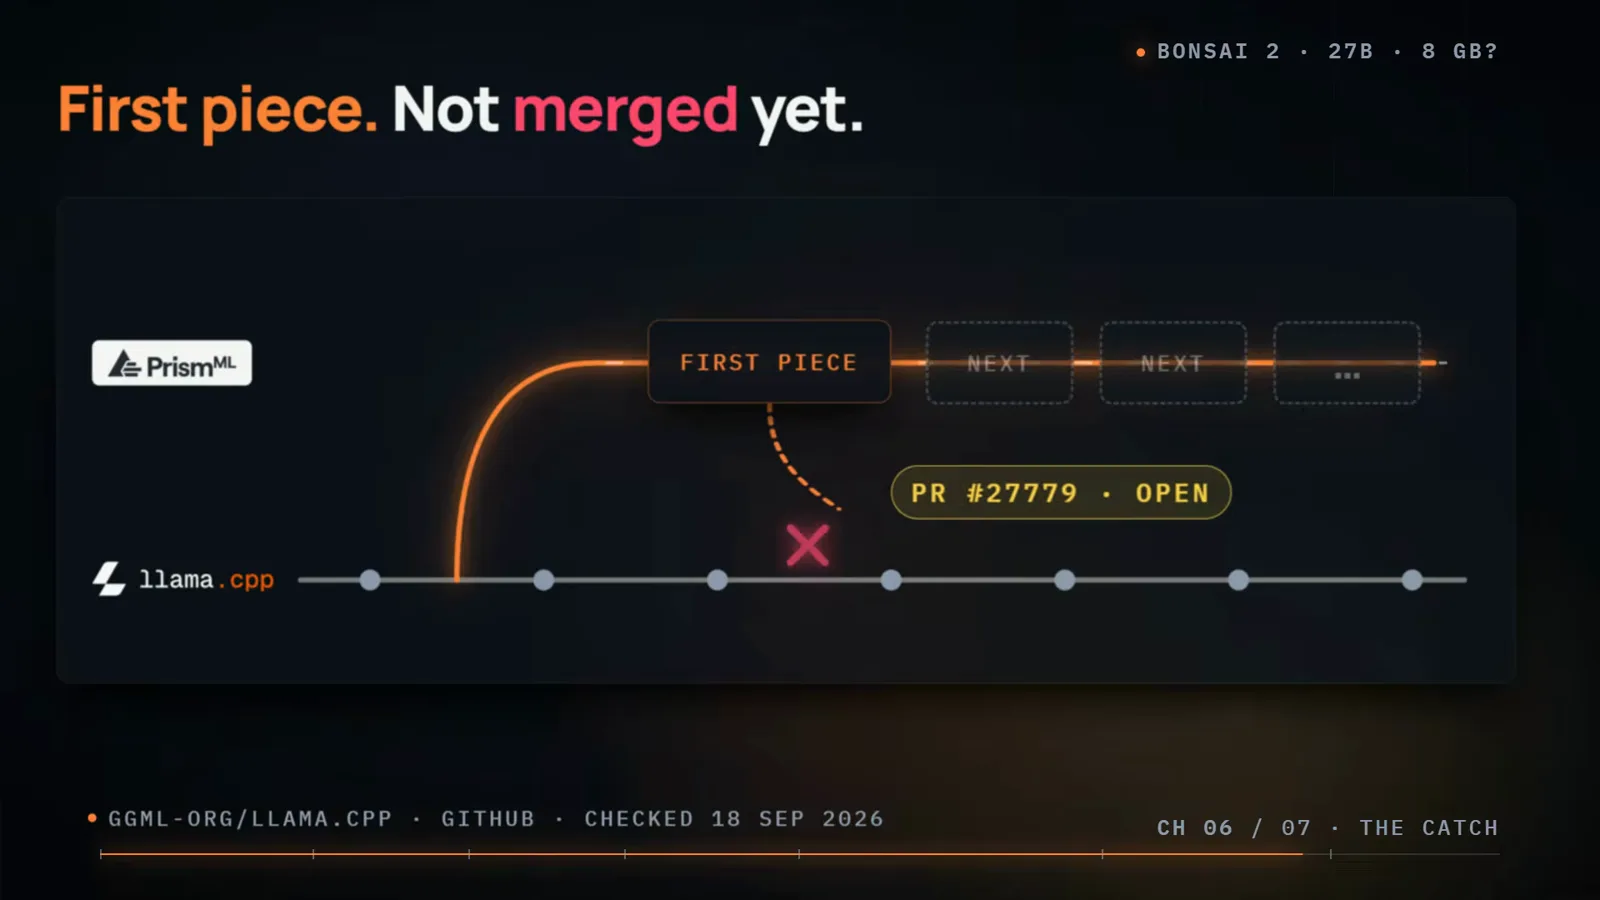
合并之日,才是常用启动器登场之时。视频 7:05 处